一个程序员的心路历程
Tailscale 官方揭秘提速方案:一场关于「少拷贝、多队列、缓存」的 Go 语言网络性能优化实战
Tailscale 近年来持续投入网络性能优化:从 Linux 设备 TCP 吞吐量提升,到 wireguard-go 突破 10Gb/s 大关,再到借助分段卸载技术将 UDP 应用吞吐量提升 4 倍以上。这一次,团队把优化重心放在了三个方向上——降低小数据包的内存开销、为高负载节点引入多队列并行处理、以及通过网络地图本地缓存缩短设备连接建立的冷启动时间。文章还透露,团队计划在 v1.104 及后续版本中逐步落地这些改进,并公开征集用户对“Tailscale 原生性能诊断工具”的需求。这不仅是一次单点优化,更是 Tailscale 在朝着支撑 CI/CD、Agentic 工作流、远程开发环境、机器人边缘设备等高性能敏感场景演进过程中的系统性工程实践。
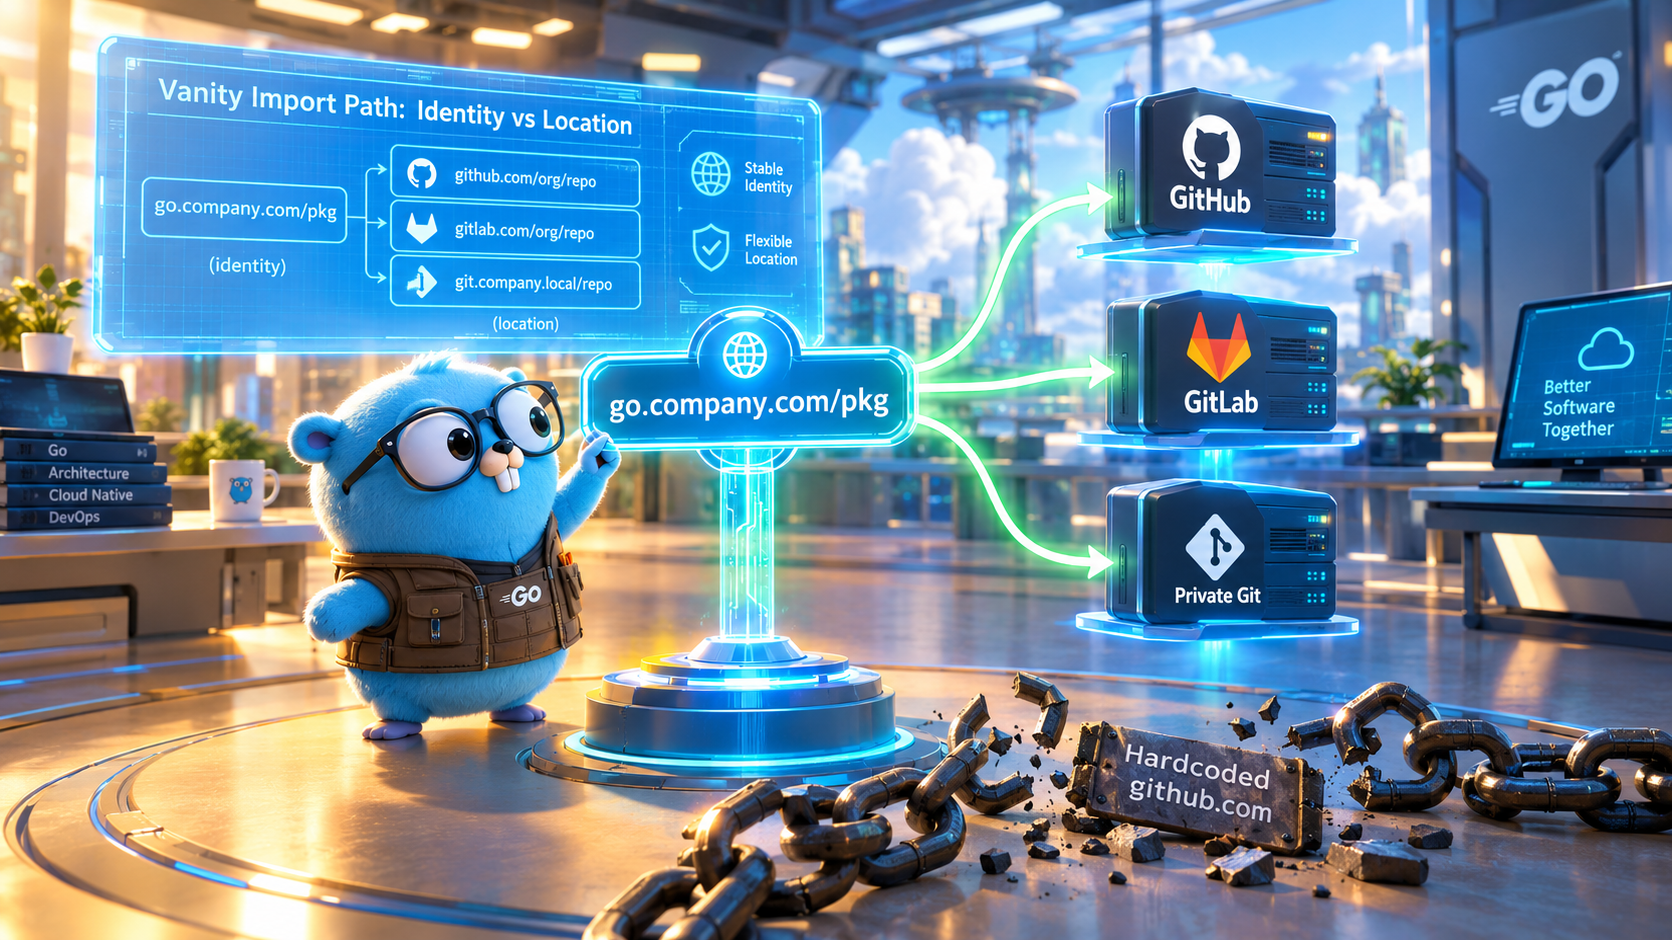
HN 热帖引爆讨论:Go 的 import 路径,为什么不该耦合 github.com?
Go 的 import 路径同时是模块的身份、位置和校验键。一篇 HN 热帖引发了“该不该用自有域名”的激烈争论。本文梳理正反两方的核心论据,解析 `go-import` 机制,并给出不同场景下的选型与迁移建议。
Go与Rust同日交卷:一场关于“可移植SIMD”的路线之争
2026年9月,Go 官方与 Rust 社区几乎在同一天发布了关于 SIMD 向量化编程的年度长文。Go 1.27 带来了旨在抹平架构差异的实验性 simd 包,通过编译器 AST 特化与软件模拟兜底践行“极简统一”;而 Rust 社区则在官方 std::simd 迟迟未转正的背景下,展现出以 fearless_simd、pulp 等为代表的百花齐放与类型系统证明尝试。本文深度对比两大语言阵营在解决硬件碎片化、抽象层级取舍以及性能与可移植性平衡上的不同哲学,全面拆解现代系统语言进军向量计算的演进图谱。
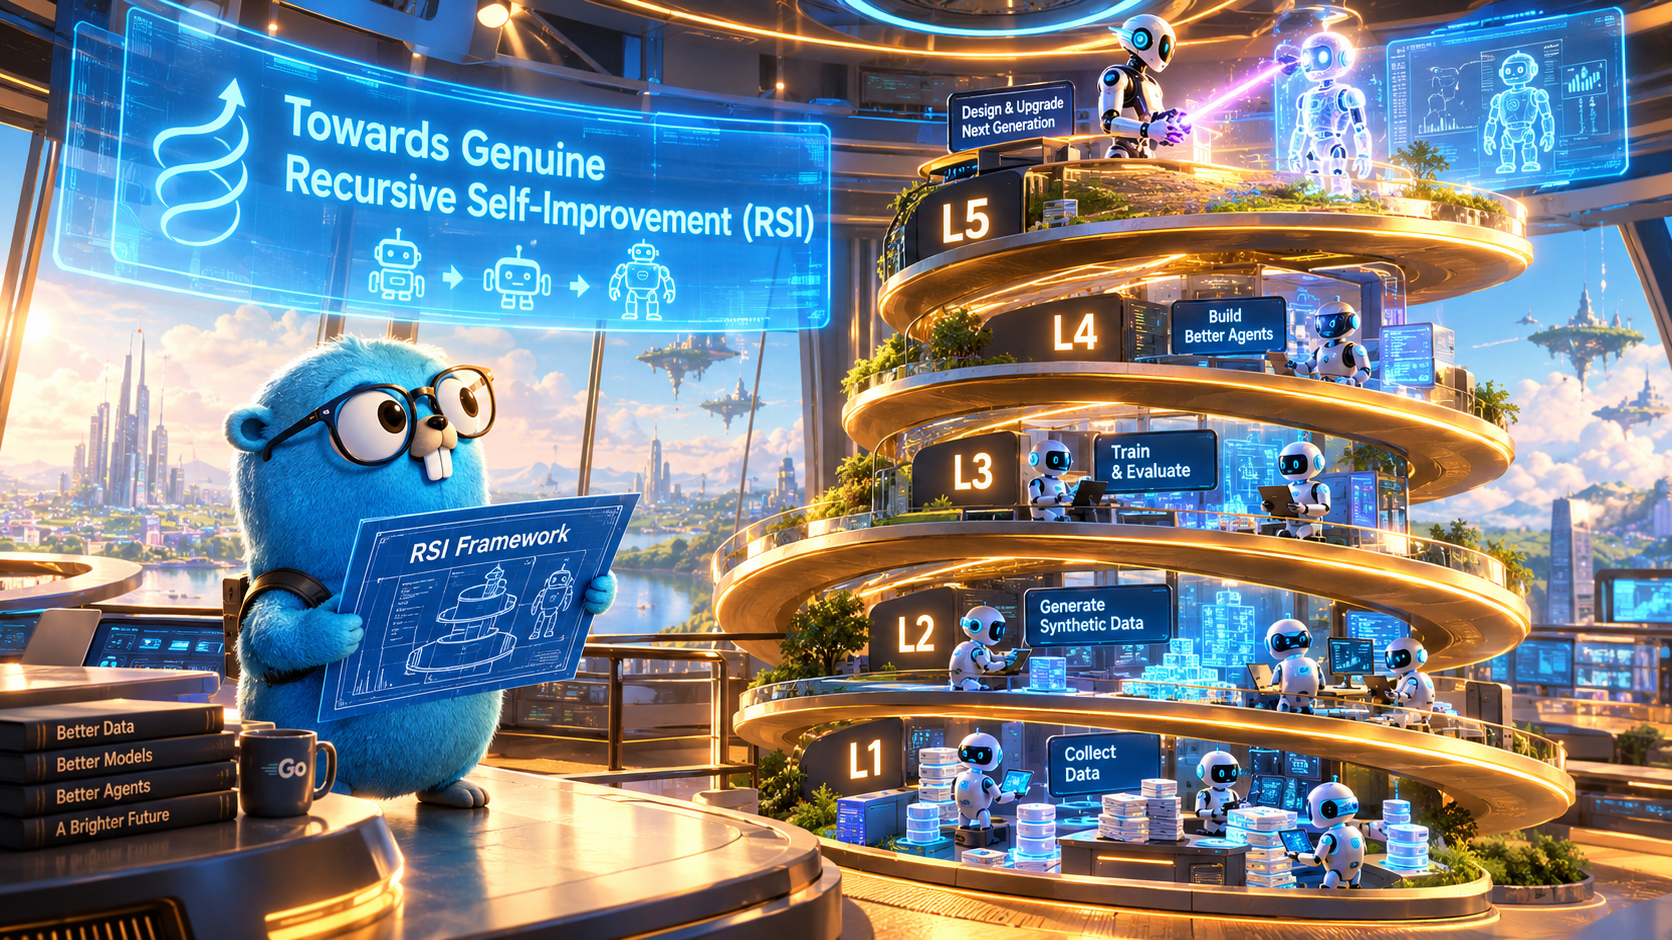
人类打造的最后一个AI?国内顶尖学者联合发文,把“AI自我进化RSI”拆成了五个等级
递归自我改进(Recursive Self-Improvement,RSI)指的是AI系统能够把与环境、任务、其他智能体交互中获得的经验和反馈,自主转化为对自身的持久性改变,并且这种改变还能进一步影响未来生成、评估、筛选和沉淀改进的机制本身。这篇综述首先通过Headroom-Closed Index(HCI)指标,系统梳理了当前大模型在十个能力域的进展现状,指出软件工程、工具使用等交互式能力的提升明显滞后于数学、科学等可验证领域。在此基础上,论文提出了一套以“AI承担了多少改进责任”为核心标准的自主性五级框架——从执行既定改进(L1),到自主选择改进策略(L2),到自主获取未来学习经验(L3),到在部署环境中自适应(L4),最终到能够递归地改进“改进机制”本身(L5)。论文进一步在科学发现、具身智能、软件工程、医疗四个应用场景中比较了RSI的落地条件,并结合多家产业实验室的一手实践,指出了实现“真正的RSI”仍需跨越的三大挑战:改进的安全继承、自主性的准确归因,以及验证机制的可靠性。
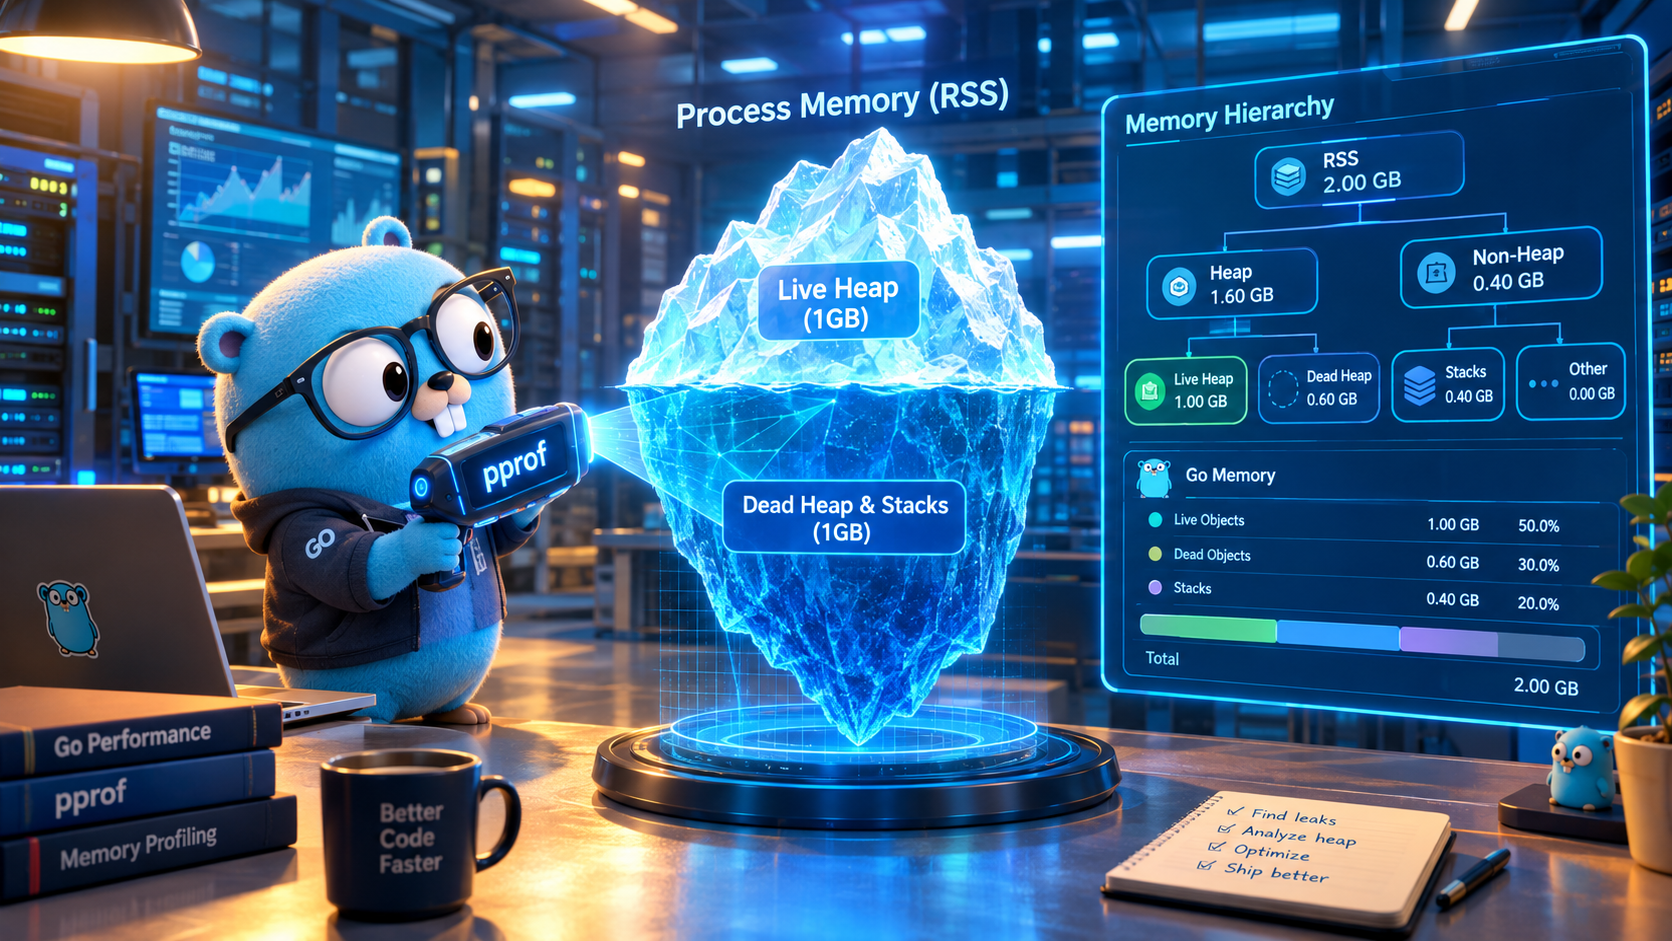
Go 内存分析要“动大手术”了:pprof 提案拟为 heap profile 补上失踪的另一半
Go 语言的 `runtime/pprof` 长期以来只能展示“存活堆(live heap)”,但在默认 `GOGC=100` 设置下,这部分内存通常不到进程真实内存占用(RSS)的一半,导致开发者不得不手动拼凑 RSS、runtime/metrics、heap profile 三份数据才能理解内存全貌。由 Felix Geisendörfer 提出的 proposal #79179 计划在现有 `heap`/`alloc` profile 中新增一个 `memory_space` 采样类型,并将其设为 `pprof.Lookup(“heap”)` 的默认输出,从而在一份 profile 中完整呈现「RSS → Go 内存 / 非 Go 内存 → 堆 / 栈 / 运行时」的分层视图。该提案已在最新一轮评审中被标记为 active,且获得 Austin Clements 等核心成员的原则性认可。