本文永久链接 – https://tonybai.com/2026/09/26/go-pprof-heap-profile-memory-space-rss-proposal
大家好,我是Tony Bai。
【导读]
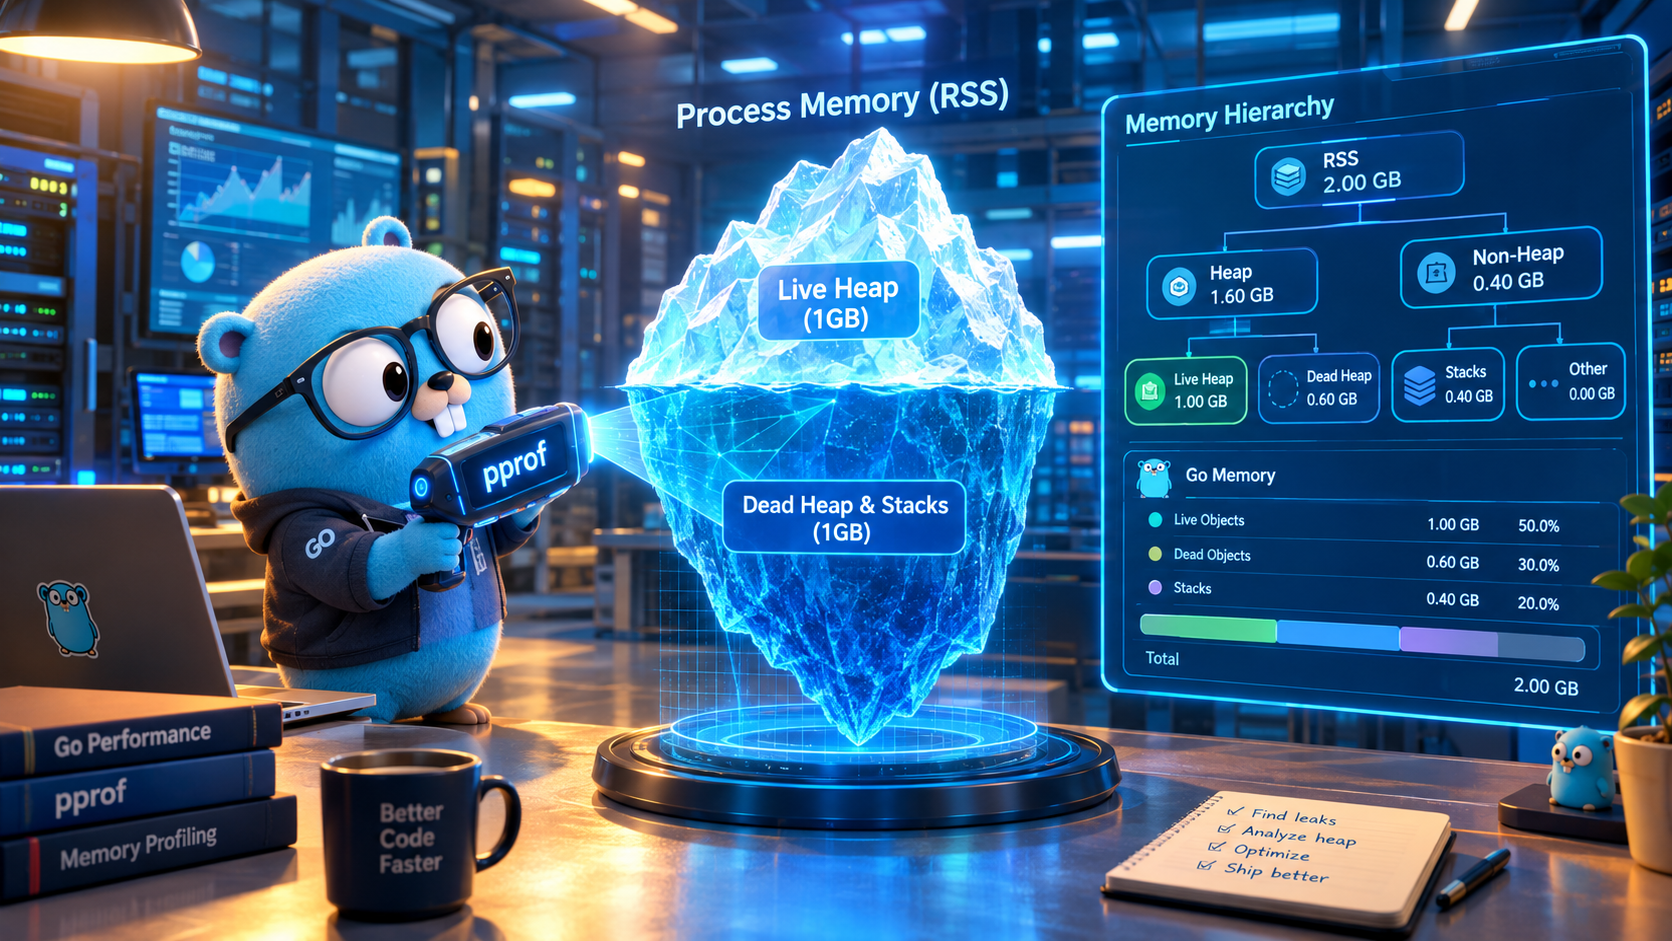
排查 Go 服务内存超标时,你是不是也遇到过这种“灵异事件”:容器监控显示 RSS 已经吃到 2GB,可 pprof.Lookup("heap") 抓出来的堆快照却只有不到 1GB?这中间“消失”的内存去哪了?Go 团队最新一期 proposal review 会议纪要显示,一份旨在彻底终结这一困惑的提案——为 heap profile 新增 memory_space 采样类型——已被“临时通过(provisionally accepted pending implementation)”。这可能是近年来 Go 内存诊断工具链最重要的一次升级。
【文章要点】
- 痛点:默认配置下,存活堆常常占不到进程真实内存的 50%,“死堆”、协程栈、运行时开销、非 Go 内存都被排除在外;
- 方案:不新建独立 profile,而是给已有
heap/allocprofile 加一个memory_space采样类型,兼顾发现性与兼容性; - 结构:RSS → Go Memory / Non-Go Memory → Heap(Live / Dead)/ Stack / Runtime 的完整层级树;
- 权衡:profile 体积预计增大约 30%(未压缩)/ 10%(压缩后),社区正讨论是否需要 GODEBUG 开关;
- 命名之争:从最初的
“rss”改为“memory”,容器化时代术语习惯是重要理由; - 进展:评审意见为“临时通过,等待正式实现验证”,尚未合入主线。
开场:一个每个 Go 运维都遇到过的“灵异事件”
深夜,告警响了:某 Go 微服务容器 RSS 突破 2GB 限制,即将被 OOM Kill。你熟练地打开 /debug/pprof/heap,抓下堆快照,扔进 go tool pprof 里一看——
不到 1GB。
另外一半内存,去哪了?
如果你也曾在这个问题上抓耳挠腮,那么恭喜,你不是一个人。Go 核心团队成员、可观测性领域老兵 Felix Geisendörfer 最近提交的一份提案,正是要终结这个困扰 Go 社区多年的“内存罗生门”。在最新一期 proposal review 会议纪要中,这份编号为 #79179 的提案已被标记为 active,并获得“临时通过(provisionally accepted pending implementation)”的评审结论。
真相:为什么 inuse_space 只讲了一半的故事
要理解这份提案,得先搞懂 Go 内存诊断的“三件套”以及它们为什么互相“对不上账”:
- 进程 RSS:操作系统内核给出的物理内存占用,是运维和 K8s OOM Killer 最关心的数字;
- runtime/metrics:Go runtime 暴露的一堆细粒度内存计数器,专业但零散;
- heap profile(
inuse_space):pprof.Lookup("heap")默认给出的存活堆快照。
问题在于,inuse_space 只统计“当前仍被引用、尚未被判定为垃圾的对象”。而在默认 GOGC=100 的设置下,堆内存会在触发下一轮 GC 前持续膨胀到存活对象的两倍左右——这意味着,有大量已经“死亡”但还没被清扫的内存(dead heap),根本不会出现在 heap profile 里。再加上协程栈、mspan/mcache 等运行时元数据、可执行文件本身、共享库、mmap 区域、cgo malloc 等“非 Go 内存”,真实的 RSS 往往是 heap profile 数字的两倍以上。
提案原文直言不讳:
在默认设置(GOGC=100)下,存活堆通常占不到 Go 程序内存使用量的 50%。
于是开发者只能求助于篇幅冗长的博客文章,手动去“对账” RSS、runtime metrics 和 heap profile 这三份数据——这本身就是一种反人类的工程体验。
提案核心方案:给 heap profile 装上“上帝视角”
提案最初的方案是新增一个独立的 “rss” profile 类型,但经过多轮 runtime 诊断会议和 proposal review 的打磨,方案演化为:不新建 profile,而是给现有 heap/alloc profile 追加一个新的采样类型 memory_space,并将其设为默认展示类型:
pprof.Lookup("heap").WriteTo(f, 0)
这样设计有两个直接好处:
- 发现性拉满:用户不需要知道有个新 profile 存在,只要照常调用现有 API,看到的就是升级后的完整视图;
- 不破坏现有生态:持续性能剖析(continuous profiling)客户端通常不依赖
default_sample_type字段,因此这一改动理论上只影响 pprof UI 的交互式使用者,不会打破已有的自动化采集链路。
新增的 memory_space 采样类型要回答的核心问题是:在最近一次标记终止(mark termination)时刻,进程的内存到底花在哪了?
内存全景图:一张图看懂 memory_space 的层级结构
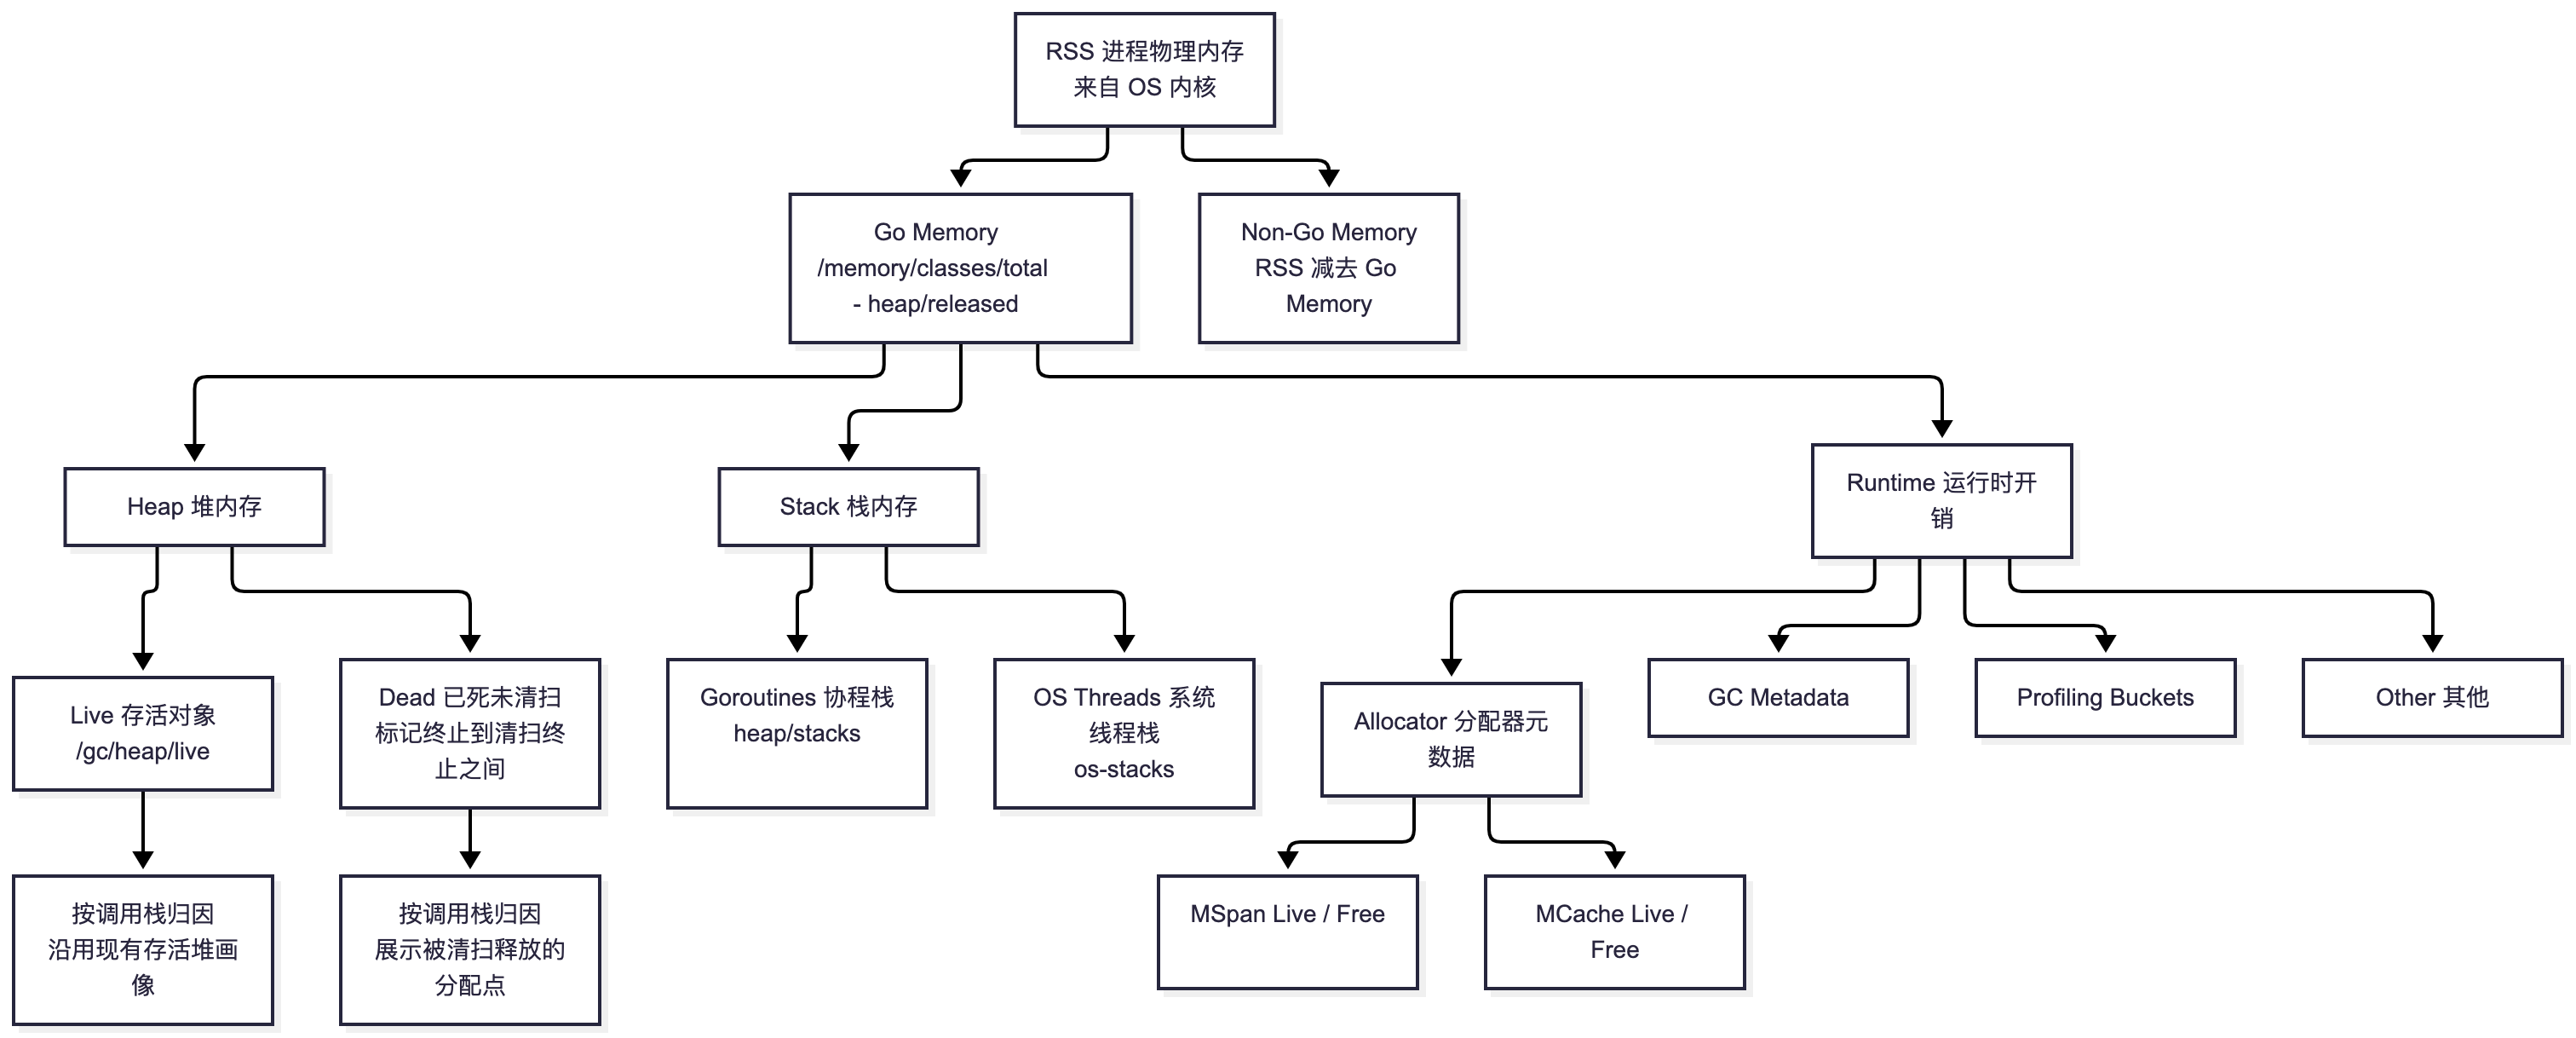
提案给出的分层结构相当细致,基本上是把 /memory/classes/... 运行时指标体系和 pprof 的调用栈归因能力做了一次“缝合”。整体逻辑可以用下图概括:
有几个关键点:
- 如果 OS/内核能读到 RSS,且 RSS ≥ Go Memory,才会显示顶层的 RSS 帧,并把 Non-Go Memory 计算为
RSS - Go Memory; - 如果 RSS 不可用,或者出现
Go Memory > RSS的反常情况(比如使用了内存“压舱石”技巧,或者虚拟内存被大量预留但未真正触碰),profile 会退而求其次,只展示 Go Memory 部分,并在根节点用一条明确的警告说明原因,例如:
[WARNING: RSS not supported on GOOS=X]
[WARNING: Go Memory (X MiB) > RSS (Y MiB)]
这种“宁可明确告警、也不给出误导性数字”的设计思路,贯穿了整个提案。
三个值得细品的设计细节
1. “死堆”不是无用信息
有人可能会问:都已经判定为垃圾了,看它的调用栈归因还有什么意义?提案的回答是——大多数请求驱动型服务(request-oriented services)中,一次请求内的临时分配既可能落在存活堆里,也可能落在死堆里,取决于 GC 触发的时机。因此死堆和存活堆往往指向相似的分配热点,优化死堆同样能有效降低整体内存占用;即便在长生命周期对象为主的极端场景下,减少短生命周期分配的“抖动”也能降低 GC 频率,从而让更激进的 GOGC、GOMEMLIMIT 设置成为可能。
2. 一致性快照,STW 影响可控
提案作者提供的早期原型已经验证:在标记终止阶段,可以拿到一份内部一致的 runtime 指标快照,与存活堆/死堆的调用栈画像对齐。
这部分逻辑对 STW(Stop-The-World)延迟的影响预计很小,且没有开启内存剖析时,编译器可以直接裁掉相关代码路径。相对棘手的是 RSS 读取——它依赖系统调用,不适合放进 STW 窗口,所以方案选择在标记终止结束后尽快读取 RSS,接受一定程度的“尽力而为”式时间偏差。
3. 体积代价:一次坦诚的成本核算
Austin Clements 在评审中提出了一个很现实的问题:pprof 格式要求同一份 profile 里所有采样都携带全部采样类型的字段(哪怕是零值),如果新旧两类采样类型的调用栈集合不完全重合,实际上会让样本数量翻倍。作者的回应也很坦率:预计未压缩体积增加约 30%,压缩后增加约 10%,并考虑通过 GOEXPERIMENT 或 GODEBUG 开关提供退出通道,长期方案则寄望于配套的 Recorder 提案(#74545)。
社区评审:认可、追问与命名之争
从会议纪要来看,这份提案的评审过程很能体现 Go 团队“谨慎但不保守”的风格:
- 态度积极:Austin Clements 明确表示“这确实能解决长期以来大家对 heap profile 的困惑”;
- 追问细节:是否包含 data segment(文件映射但私有可写的内存)?作者确认在 Linux 上会包含在 RSS 统计中(对应
/proc/self/statm的第二个字段); - 虚拟内存 vs 物理内存的老生常谈:Go runtime 主要统计的是虚拟内存,而 RSS 是物理内存,两者天然存在语义鸿沟,评审中特别讨论了这一点,最终方案选择用“警告帧”的方式坦承这种局限,而不是假装两者完全等价。
最有意思的是一场关于命名的争论。提案最初打算叫 “rss”,后来改成更中性的 “memory”。
核心开发者担心的是:会不会显得“含糊其辞,回避了到底测的是什么”?但社区反馈(尤其是来自容器化基础设施背景的开发者)给出了很有说服力的理由:Kubernetes 的 resources.limits.memory、cgroup v2 的 memory.current、docker stats 的 MemUsage、container_memory_working_set_bytes 等主流指标体系,全部以“memory”作为统一术语,再从中细分出具体口径。既然 Go runtime 自己的指标体系也是 /memory/classes/... 的命名风格,用 “memory” 反而与整个生态语言习惯一致——而 “heap” 这个名字,早已被业界默认用来指代存活堆,不会因为新 profile 的加入而产生混淆。
这对 Go 开发者意味着什么
如果这份提案最终落地,日常的内存排查工作流可能会发生实质性变化:
- 不再需要手动拼凑 RSS、runtime/metrics、heap profile 三份数据做“三方对账”;
- 一次
pprof.Lookup(“heap”).WriteTo(f, 0)调用,就能拿到从 RSS 到具体调用栈的完整归因链路; - 容器化环境下的成本优化和事故排查(incident response),可以直接在火焰图层面看到“非 Go 内存”占了多大比例,而不必再去猜测是不是 cgo、mmap 或者共享库在“背锅”;
- 对于持续性能剖析(continuous profiling)平台和 APM 厂商而言,需要提前评估 profile 体积增加带来的存储和传输成本。
需要提醒的是,目前该提案处于“临时通过,等待正式实现验证”阶段——评审委员会明确表示,希望看到一份“非 vibe-coded”(即非 AI 辅助草率生成、而是经过正规工程打磨)的实现,确认没有隐藏的坑之后,才会真正定案。感兴趣的开发者可以持续关注 issue #79179 以及作者早期提交的原型 CL。
小结
从 2015 年 Dmitry Vyukov 提出“展示 GC 周期开始时的堆状态”(#13463),到 2016 年 Austin Clements 呼吁 pprof 展示不止于存活堆的内存信息(#15848),再到今天这份综合了 RSS、死堆、运行时开销的完整方案——Go 团队用了整整十年,一点点补齐内存诊断工具链上最后一块拼图。这也是 Go 语言一贯的工程哲学:不追求一步到位的“大而全”,而是在充分讨论、反复打磨之后,再谨慎地把复杂度引入标准库。
对于每天和内存告警打交道的 Go 开发者来说,这或许是今年最值得期待的一次 pprof 升级。
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。