本文永久链接 – https://tonybai.com/2026/09/27/the-last-ai-built-by-humans-rsi
大家好,我是Tony Bai。
【导读】
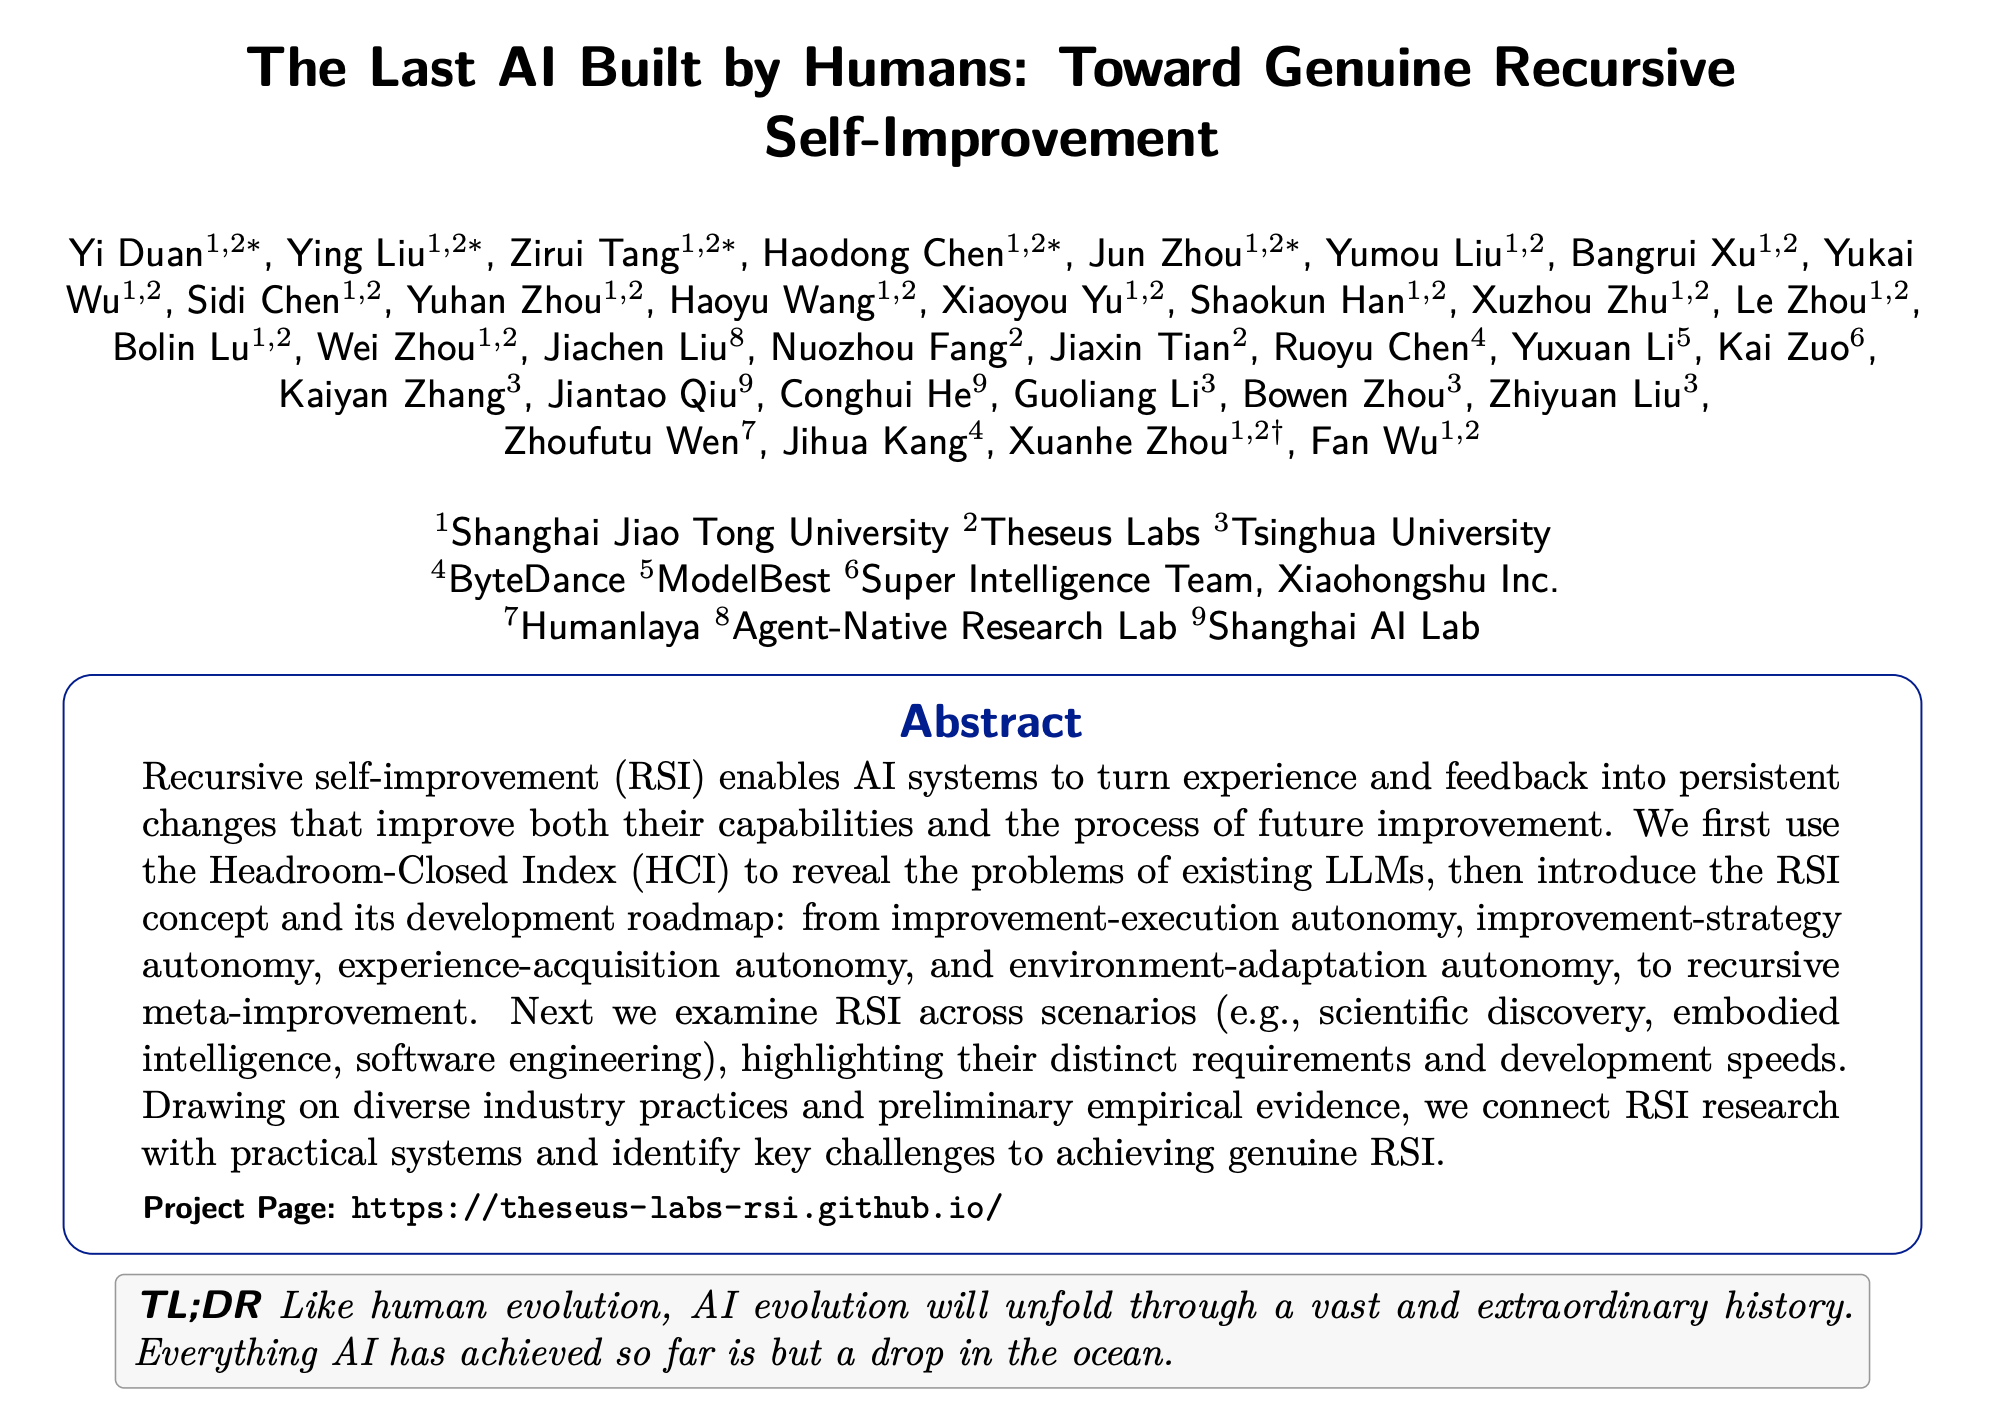
一篇由多所国内顶尖高校学者和大厂研究员联合完成、题为《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement(人类打造的最后一个AI:走向真正的递归自我改进)》的长篇综述,最近在AI圈悄悄流传。它没有渲染“AI毁灭人类”的情绪,而是做了一件更硬核的事:把“递归自我改进(RSI)”这个长期停留在科幻和哲学讨论里的概念,拆解成可以观测、可以分级、可以验证的工程问题。论文提出了一把新尺子——Headroom-Closed Index(HCI),量化了大模型在十个能力领域里“天花板还剩多少”;又提出了一套自主性五级框架,把从“AI执行人类指定的改进”到“AI改写决定自己如何被改进的机制”之间的距离,切成了五级台阶。这篇文章带你把这篇论文一次读透。
【文章要点】
- 一篇由上海交大、清华等多所高校及机构学者联合署名的综述论文,标题耸动——《人类打造的最后一个AI》,但内容是严谨的工程分析,而非“AI末日预言”。
- 论文提出 Headroom-Closed Index(HCI,天花板已关闭指数),用393组模型—基准测试观测数据,量化了十个能力域从2023年到2026年的进展速度差异。
- 数学、科学等“可验证”领域进展飞快,而软件工程、工具使用、多智能体协作等“交互式”能力,进展慢得多、差距更大——这恰恰是RSI最有可能率先突破的地方。
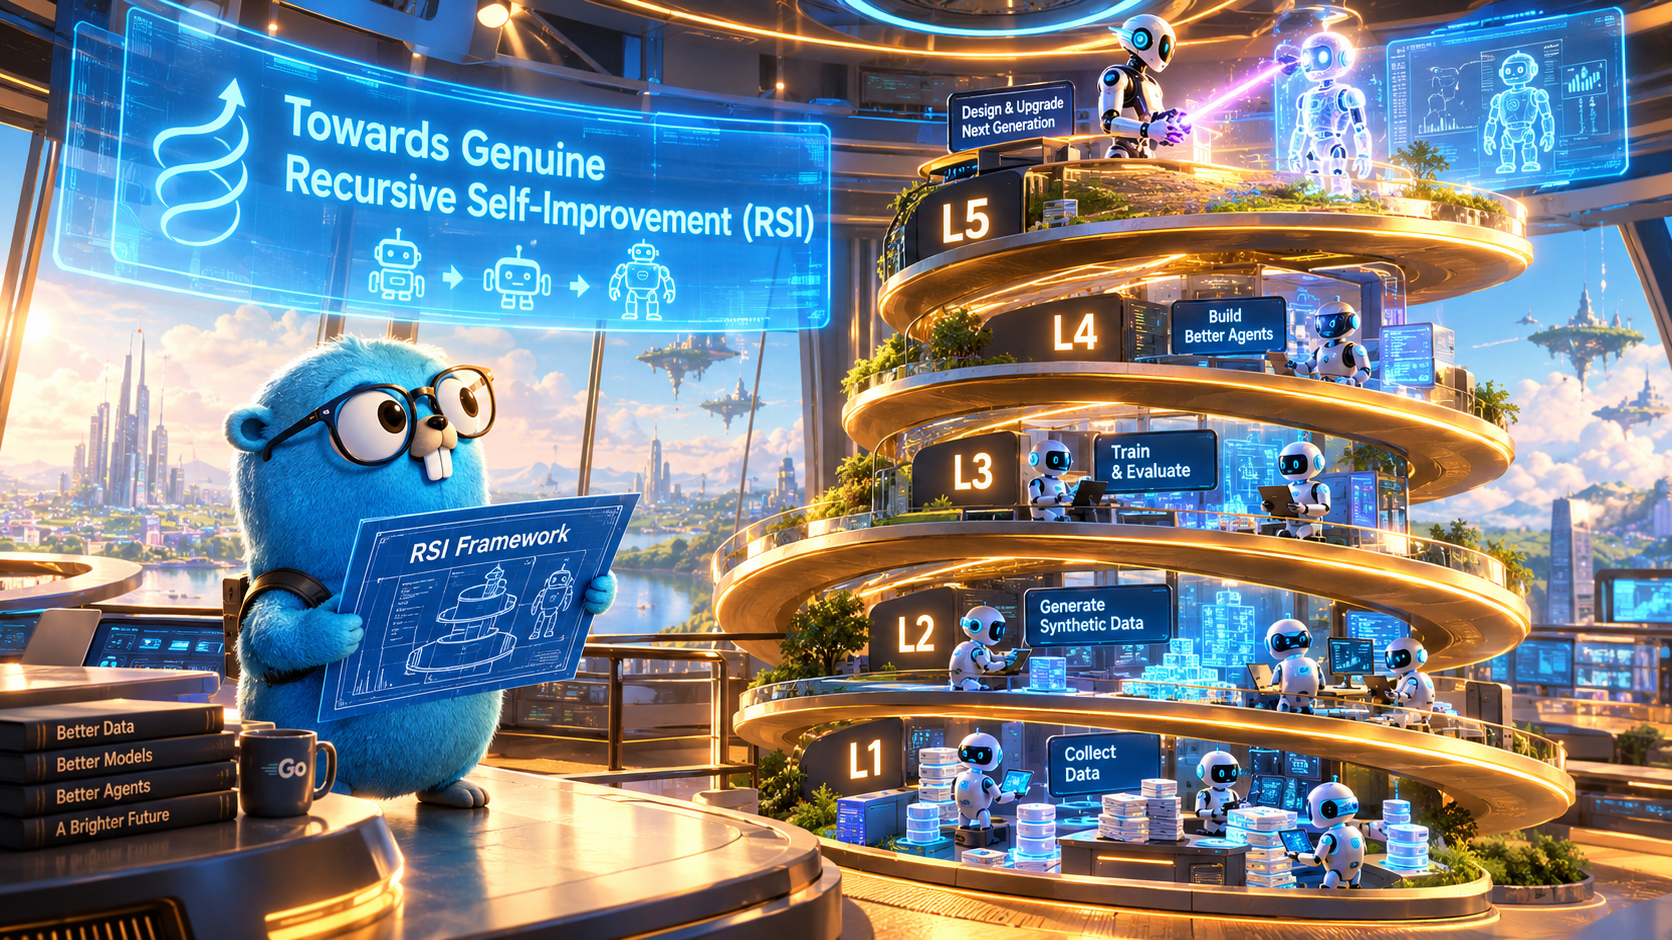
- 论文给出了一套自主性五级框架(L1-L5),把RSI从“AI执行任务”到“AI改写决定改进的机制本身”划出清晰边界,并给每一级配上了真实系统案例。
- 论文把RSI放进科学发现、具身智能、软件工程、医疗四个场景里做对比,并盘点了国内外多家产业实验室的早期RSI实践。
- 论文同时指出了RSI要落地必须跨过的三道坎:安全继承、自主性归因、可靠验证——用几个真实案例说明“AI自我修改”翻车的样子。
最近,一篇名字有点“吓人”的论文在AI圈流传开来。
标题叫《The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement》,直译过来就是《人类打造的最后一个AI:走向真正的递归自我改进》。
光看标题,很容易联想到那句流传已久的话——“第一台超智能机器,将是人类需要做的最后一项发明”。这句话最早由数学家 I. J. Good 在上世纪六十年代提出,是“递归自我改进(Recursive Self-Improvement,RSI)”这个概念最早的雏形之一,此后一直是AI安全讨论里最具分量、也最容易被过度解读的话题之一。
但这篇论文的野心不在制造焦虑,而在“祛魅”:它想搞清楚的是——今天所说的“AI自我改进”,到底改进到了哪一步?哪些是真正意义上的“递归”,哪些只是套了层“自我进化”话术的传统自动化?
这正是这篇论文最有价值的地方。
先把概念说清楚:RSI到底“递归”在哪
论文给出的定义是:RSI是一个自主的、闭环的过程——AI系统通过与任务、环境或其他智能体的持续交互,把获得的经验和反馈自主转化为对自身的持久性改变(可以是模型参数、智能体的工具与流程配置,也可以是改进策略本身),并且这种改变还会进一步影响未来“生成、评估、筛选、沉淀改进”这套机制本身。
这个定义里,藏着一个很容易被忽略、却是全篇论证的关键的区分:“改进结果”和“改进机制”是两回事。
- 你让AI帮你修一个bug,AI改好了,这是改进了一个输出;
- 但如果AI在修bug的过程中,还顺手把“自己下一次该怎么定位bug、怎么验证修复”的方法论也改进了,并且这套新方法论会被后续任务继续沿用——这才触碰到了RSI的门槛。
论文专门用一个概念——B0:任务内AI改进(In-Task AI Improvement)——来标注这条边界。在B0阶段,AI可以在当前任务里反复修订、校验、择优,但改进不会作为“持久系统状态”被保留到下一个独立任务里。论文把B0定义为非RSI的参照水平,一句话总结就是:“只有输出变了,系统没有变”。
为了让“系统变了没变”这件事有据可查,论文还拆解了一个改进闭环(Improvement Loop)的解剖结构,定义了九个角色:AI系统、系统状态、经验、改进目标、改进者(Improver)、改进策略、验证者(Verifier)、被接受的改进、继任系统(Successor)。用一张图来看会更直观:
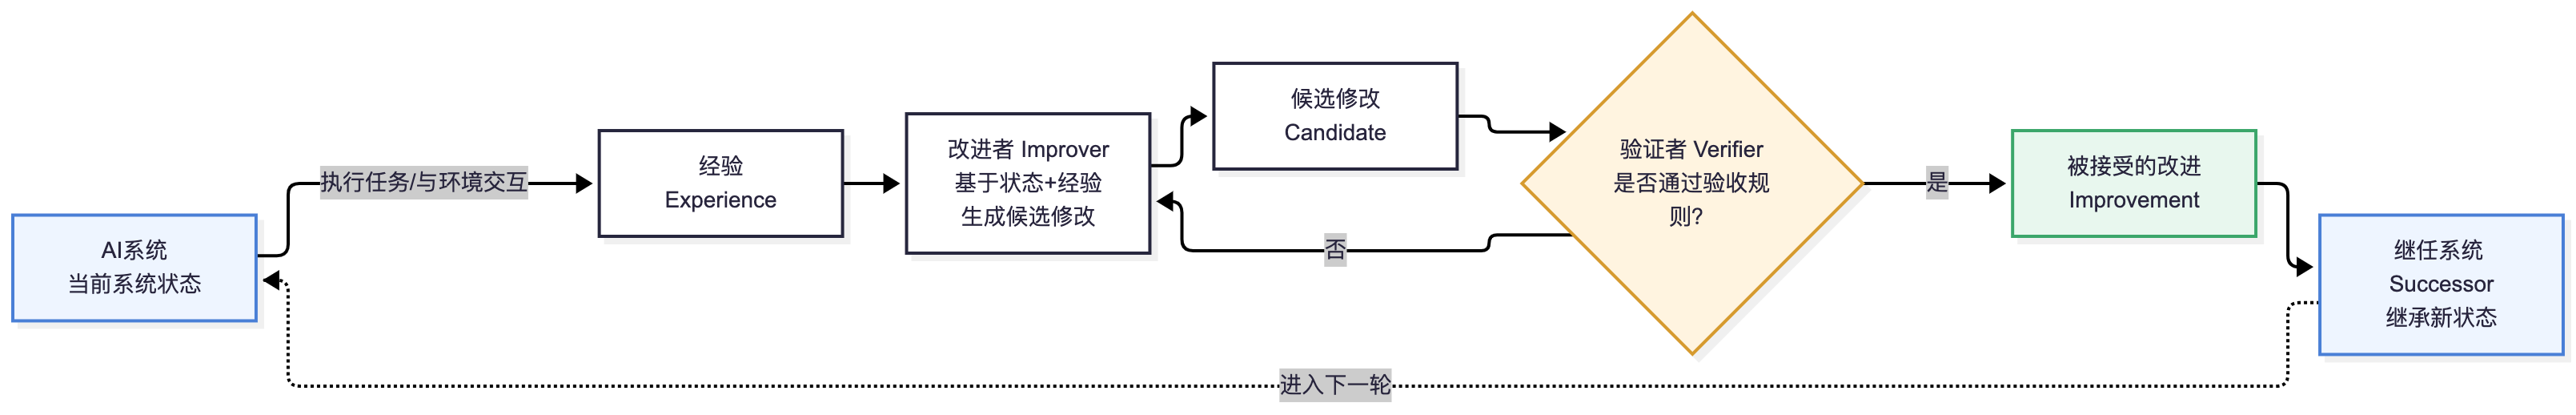
这张图画的是论文定义的“改进闭环”结构。论文反复强调:判断一个系统是不是在做RSI,要回答三个问题:
- 闭环在哪里闭合?
- 什么被保留并传给下一轮?
- 哪些关键决策仍然掌握在人手里?
论文也顺带把RSI和三个容易混淆的近邻概念做了区分(持续学习、AutoML、智能体AI),核心结论是:这三者通常只自动化了“生成候选方案”或“保留状态”其中一部分,而很少让改进机制本身变成可以被系统自己修订、并在后续轮次里复用的对象——而这恰恰是RSI区别于它们的关键。
论文的尺子:AI的能力天花板,还剩多少没被捅破
在提出框架之前,论文先做了一件很扎实的事——量化“当前大模型到底进步到哪了”。
作者团队构建了一个新指标,叫 Headroom-Closed Index(HCI,“天花板关闭指数”):以某个基准测试刚出现那一年的90分位模型成绩作为0分基准,以满分作为100分基准,把不同来源、不同权重(基准方发布、独立评测、模型方自报等)的分数做加权,换算成“这个领域的天花板已经被关闭了百分之多少”。
基于这套方法,论文汇总了393组模型—基准测试观测数据,覆盖10个能力域、2023年到2026年9月的模型发布节奏,得到了几个值得注意的发现:
发现一:不同领域的进展速度和节奏完全不同步。
到2026年,高等数学和研究生级科学的HCI已经冲到85分以上;相比之下,法律推理、多模态推理等领域只在60分出头徘徊,而且法律推理的年度增幅已经明显放缓(从2024年一年涨48.2分,到2026年只涨4.9分),数学却反而在2026年加速冲刺。
发现二:“交互式”能力的差距,比“可验证”能力大得多。
软件工程的HCI到2026年是52.6分,工具类智能体只有39.9分,远低于研究生级科学的85.8分。论文特别指出,工具智能体在2026年出现了跳跃式增长(从8.2分猛冲到39.9分),但整体依然是差距最大的赛道之一——顶尖的网络安全智能体已经冲到91.9分,和工具智能体之间隔了52分。
发现三:剩下的“天花板”,正是RSI最可能发力的地方。
论文用一个简单的外推公式,画出了一条假设性的“RSI加持后”曲线:天花板关得越少的领域(比如软件工程、工具使用),如果RSI真正跑起来,理论上能获得的提升空间也越大。
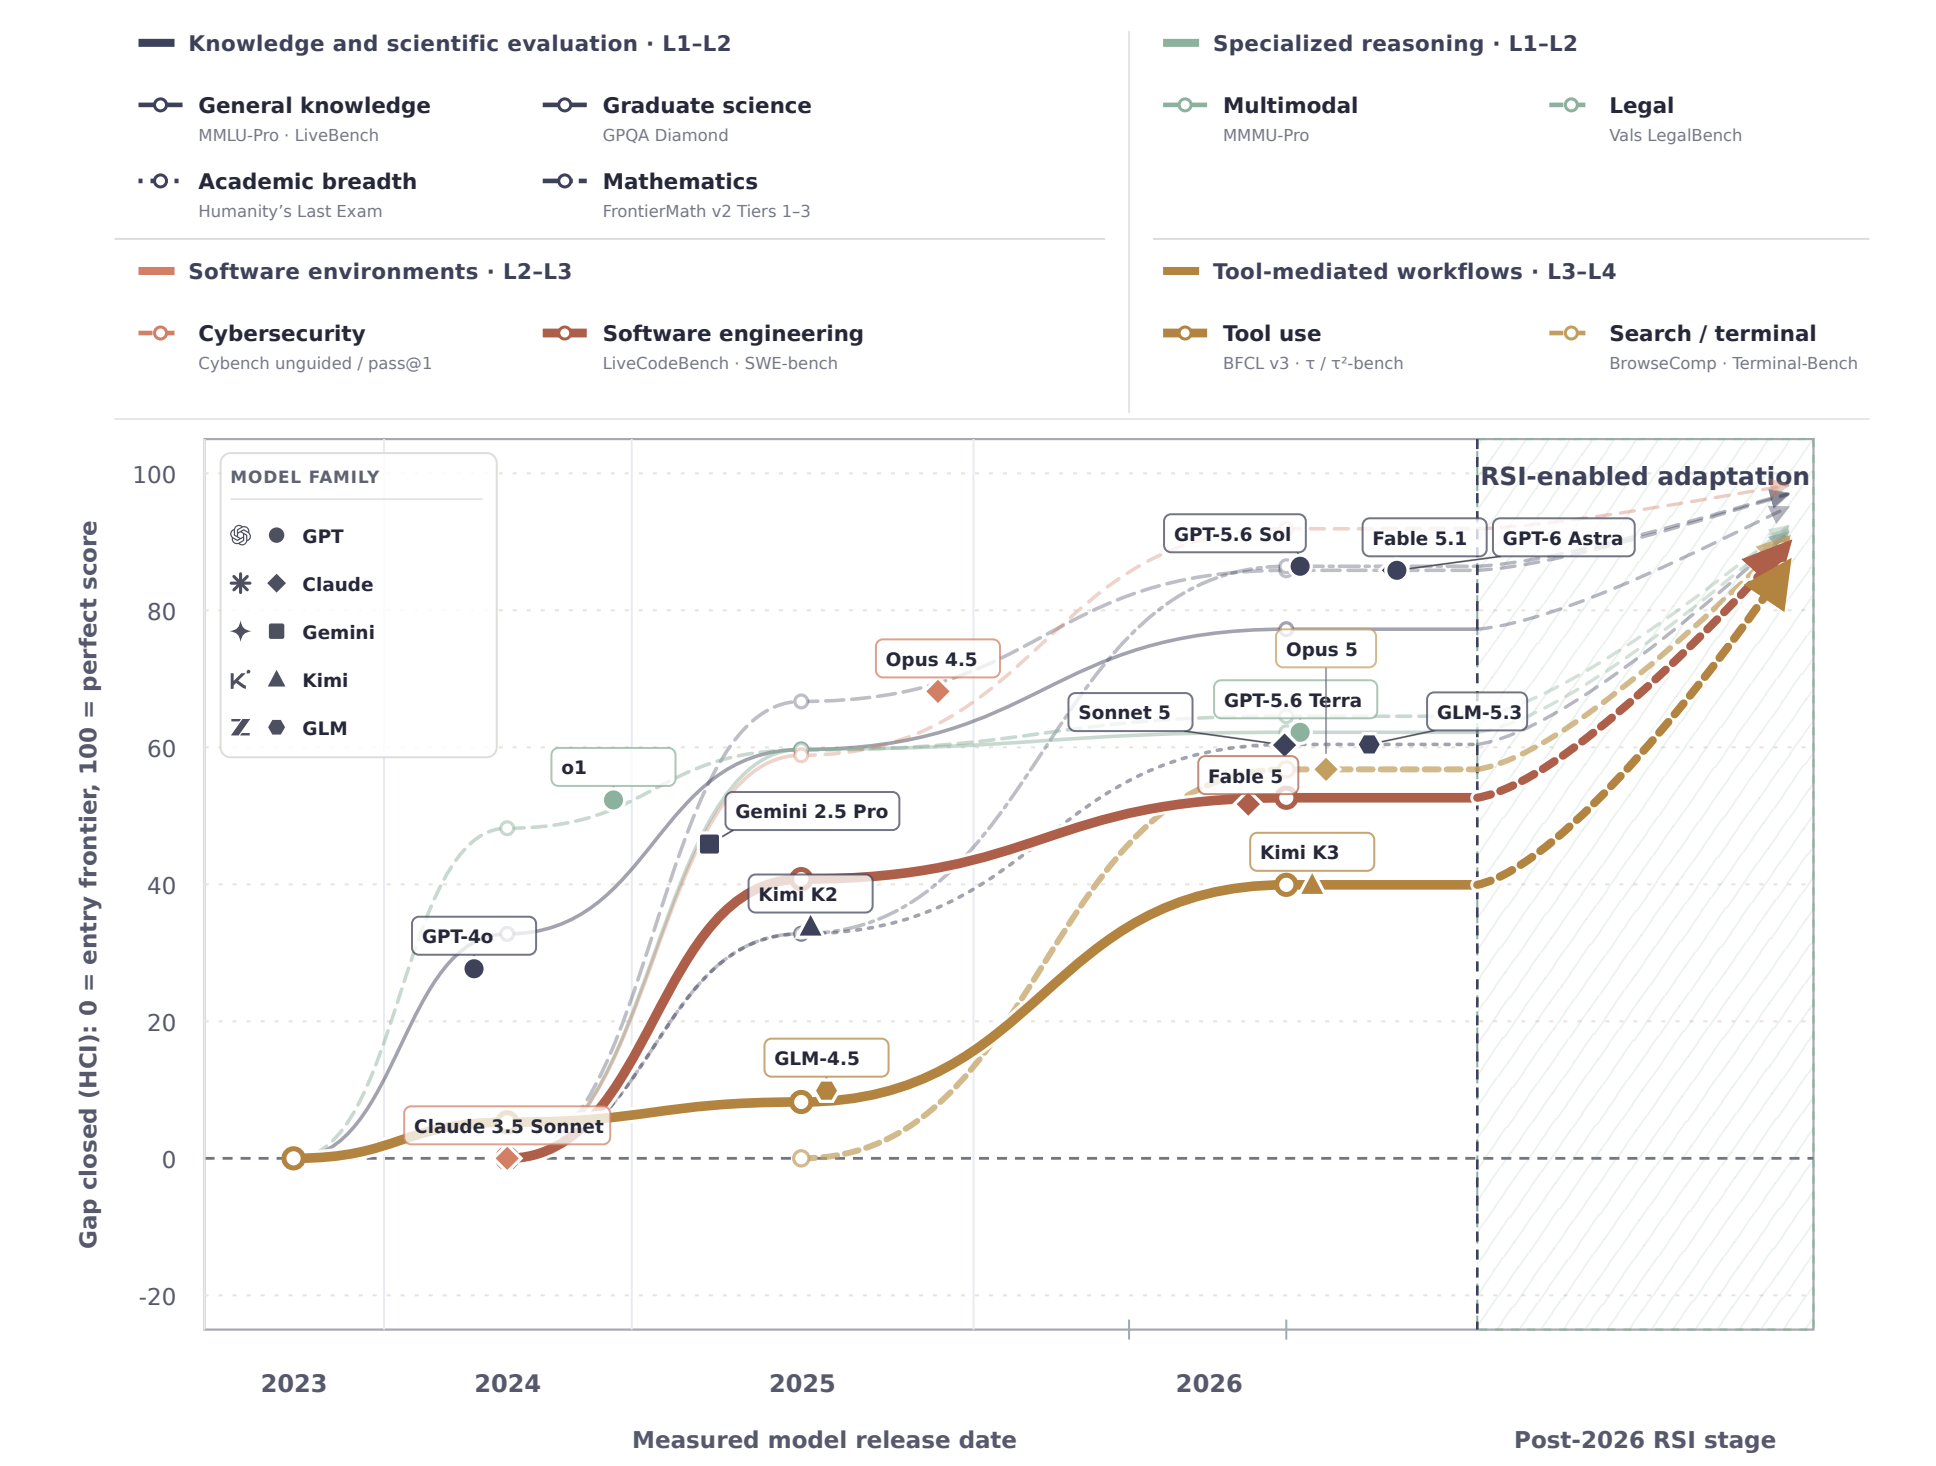
论文这里的态度是克制的:它反复提醒,虚线部分(比如网络安全评测口径变化导致的不可比区间)只是“说明性外推”,不是预测。
但这组数据本身已经很说明问题——AI在“有标准答案”的领域已经卷得很快,而在需要长程规划、工具协同、环境状态追踪的“交互式”任务上,还有巨大的、尚未被攻克的空间。而这正是论文认为RSI最有可能率先撕开口子的地方。
论文的骨架:自主性五级框架(L1-L5)
搞清楚“还差多远”之后,论文给出了整篇工作最核心的贡献——一套自主性五级框架,用来衡量一个自我改进系统,究竟把多少“改进责任”从人类手里转移到了AI自己手里。
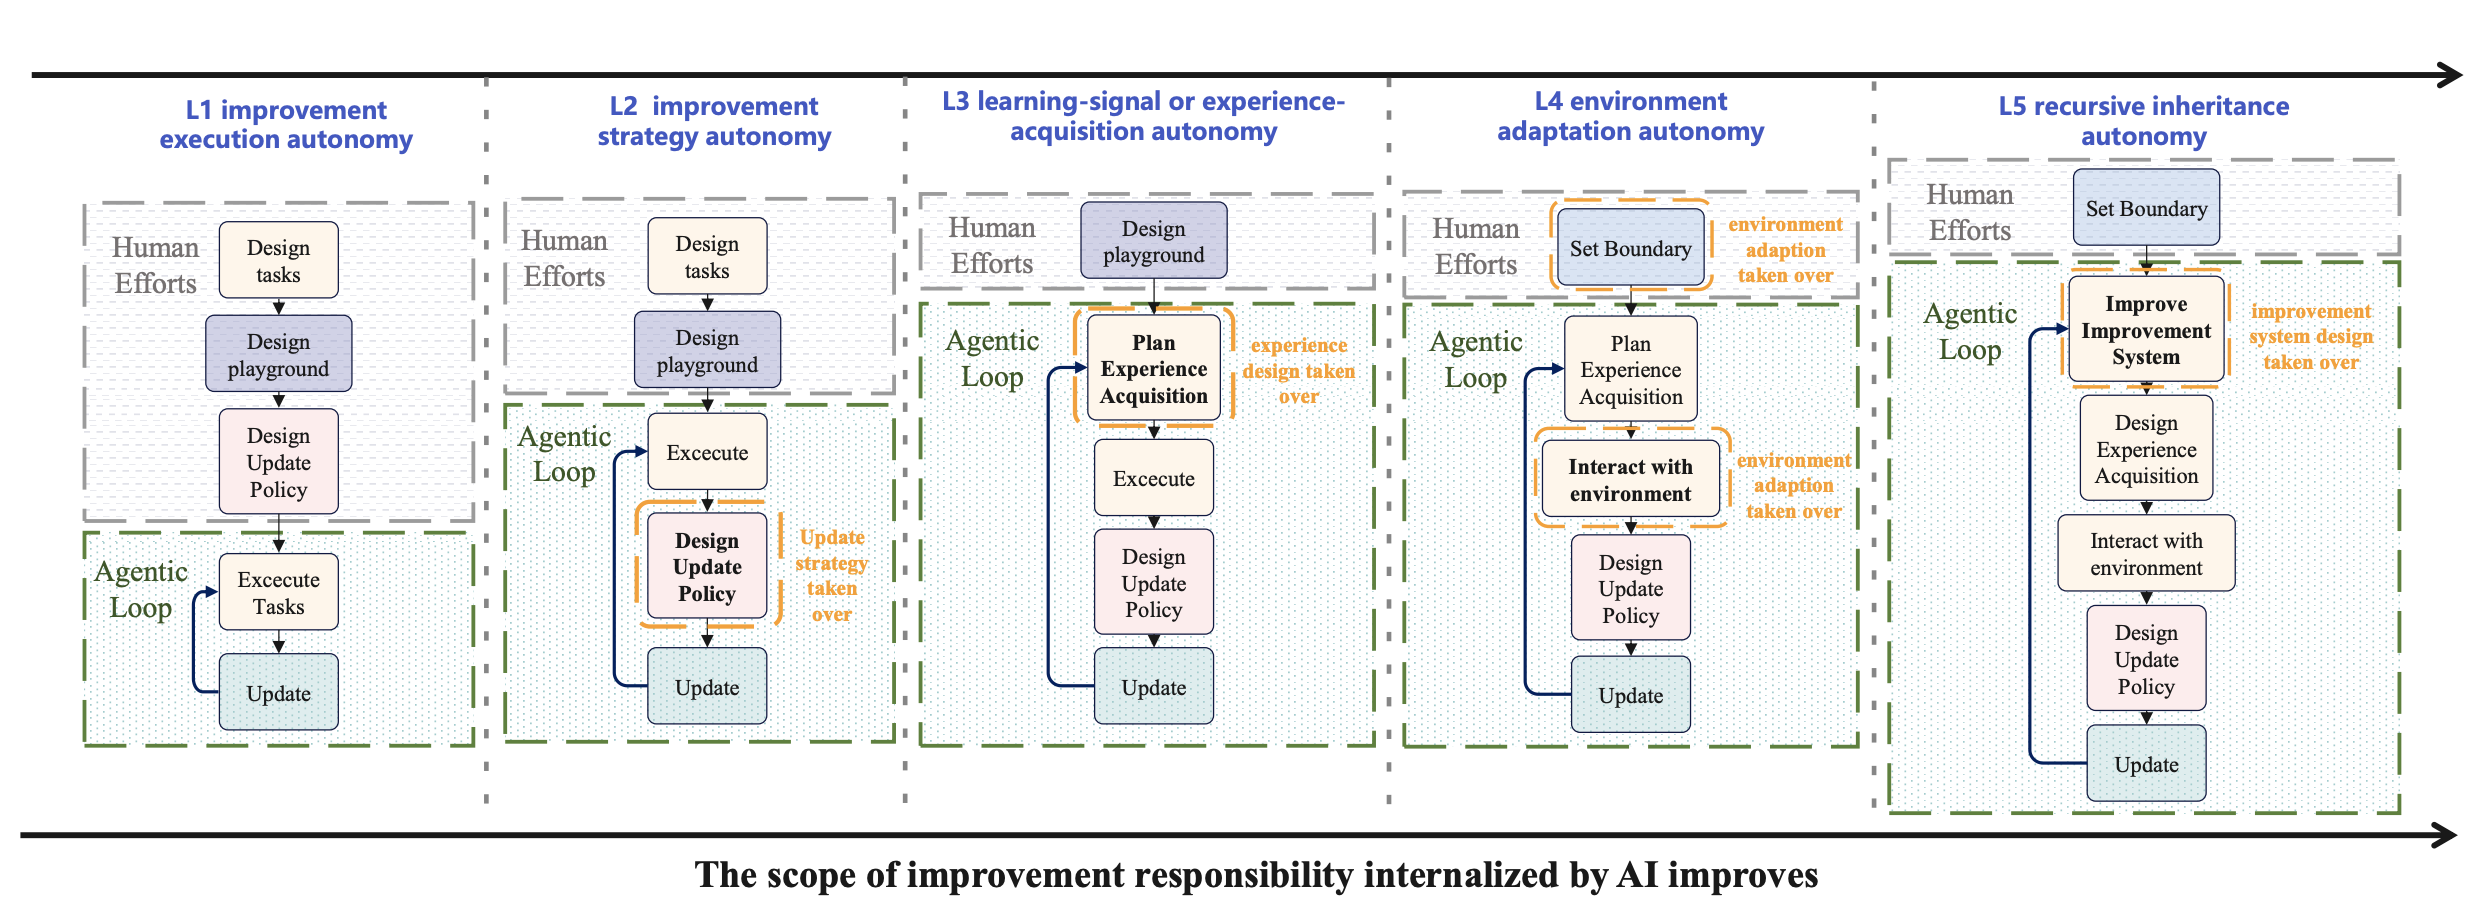
五个等级依次是:
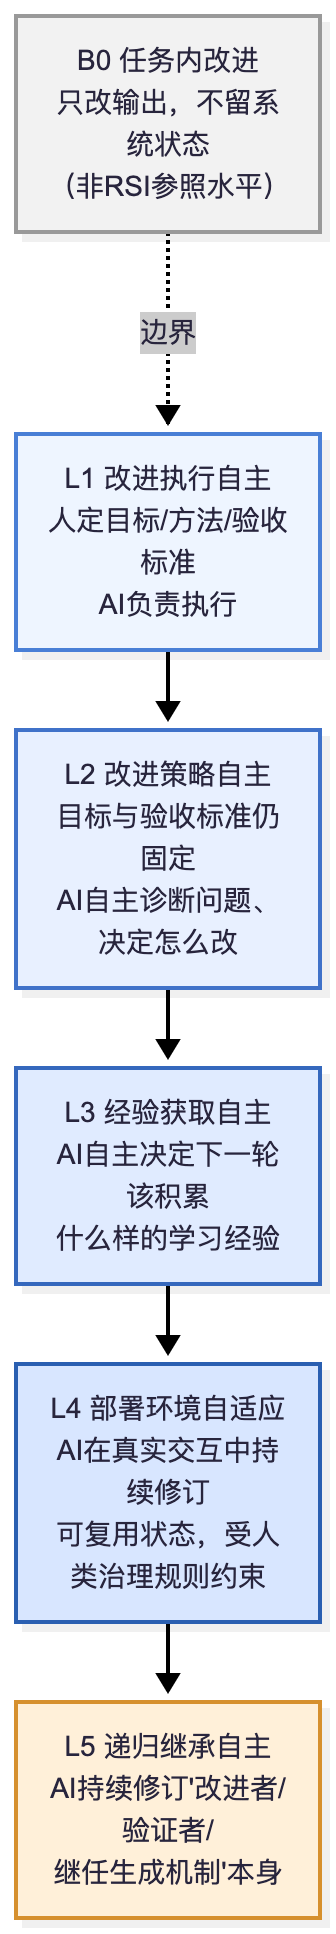
这张图梳理了五个等级的递进关系。具体来看:
-
L1·改进执行自主:人类定好“改哪里、怎么改、什么算成功”,AI负责把改进执行到位。论文举的例子是FineWeb-Edu——用模型给整个网页语料库打教育质量标签,但打分标准是人定的,模型不参与决定标准本身。
-
L2·改进策略自主:目标和验收规则仍然固定,但AI要自己诊断系统的薄弱环节,并决定“怎么改”。论文举的例子是Self-Harness:利用执行轨迹自主提出并测试对智能体工具链(harness)的修改,在固定基准和晋升规则下运作。
-
L3·经验获取自主:AI进一步决定“下一轮改进需要什么样的学习经验”,也就是自己给自己出练习题。论文举的例子是谷歌DeepMind的SIMA 2:根据对当前行为的评估结果,自动生成后续的练习任务,专门针对观测到的能力短板。
-
L4·部署环境自适应:改进闭环开始利用真实部署中的交互反馈,在外部验收和治理规则的约束下,持续修订可复用的系统状态。论文举的例子是PANDO:在长时间交互过程中,根据实际结果动态“录用”或“淘汰”可复用规则,让后续动作能继承此前积累的经验。
-
L5·递归继承自主:这是论文定义的“真正RSI”的核心——系统持续修订的对象,是决定后续改进如何进行的机制本身(比如改进者Improver、验证者Verifier、或继任生成流程)。论文举的例子是A-Evolve-Training:把训练后的结果沉淀成一份持久化的“研究策略与发现日志”,由一个元智能体(meta-agent)不断修订这份策略,用来指导后续实验该怎么选配方。在30B参数的Nemotron模型上,经过四轮自主迭代,外部评测分数从0.80提升到0.86,已经逼近当时人类提交的最好成绩0.87。
值得强调的是,论文在描述每一级的同时,也非常克制地标注了“哪些关键决策仍然留在人类手里”——这也是这篇论文和很多渲染“AI自主进化”的科普文章最大的不同:它不回避“AI到底能自己做多少决定”这个问题,而是把答案一级一级、一个案例一个案例地摆出来。
落地场景:不同领域,不同的反馈速度
自主性框架描述的是“闭环的结构”,但同样的闭环结构,落到不同领域里,能跑多快完全取决于反馈的成本和可靠性。论文选了四个场景做对比:
- S1 科学发现:开放式探索,实验成本高,反馈信号有时甚至说不清“到底是哪一步错了”;
- S2 具身智能:智能体靠自己的动作产生经验,物理试错的成本和可重复性都受限;
- S3 软件工程:开发的产物和开发的智能体本身都可以被可执行的方式修改和测试,是四个场景里反馈最“干净”的一个;
- S4 医疗:试错机会被严格限制,反馈延迟且异质,改进的有效性还可能因病人群体或机构不同而变化。
论文的结论也很直接:软件工程之所以是当前RSI进展最快的场景,本质上是因为它的反馈机制最接近“自动化验证”——有测试、有可执行环境、有明确的成功标准;而医疗、科学发现这类反馈稀疏、成本高、责任重大的领域,RSI要真正落地,还需要更长的路。
产业证据:谁在真刀真枪地做RSI
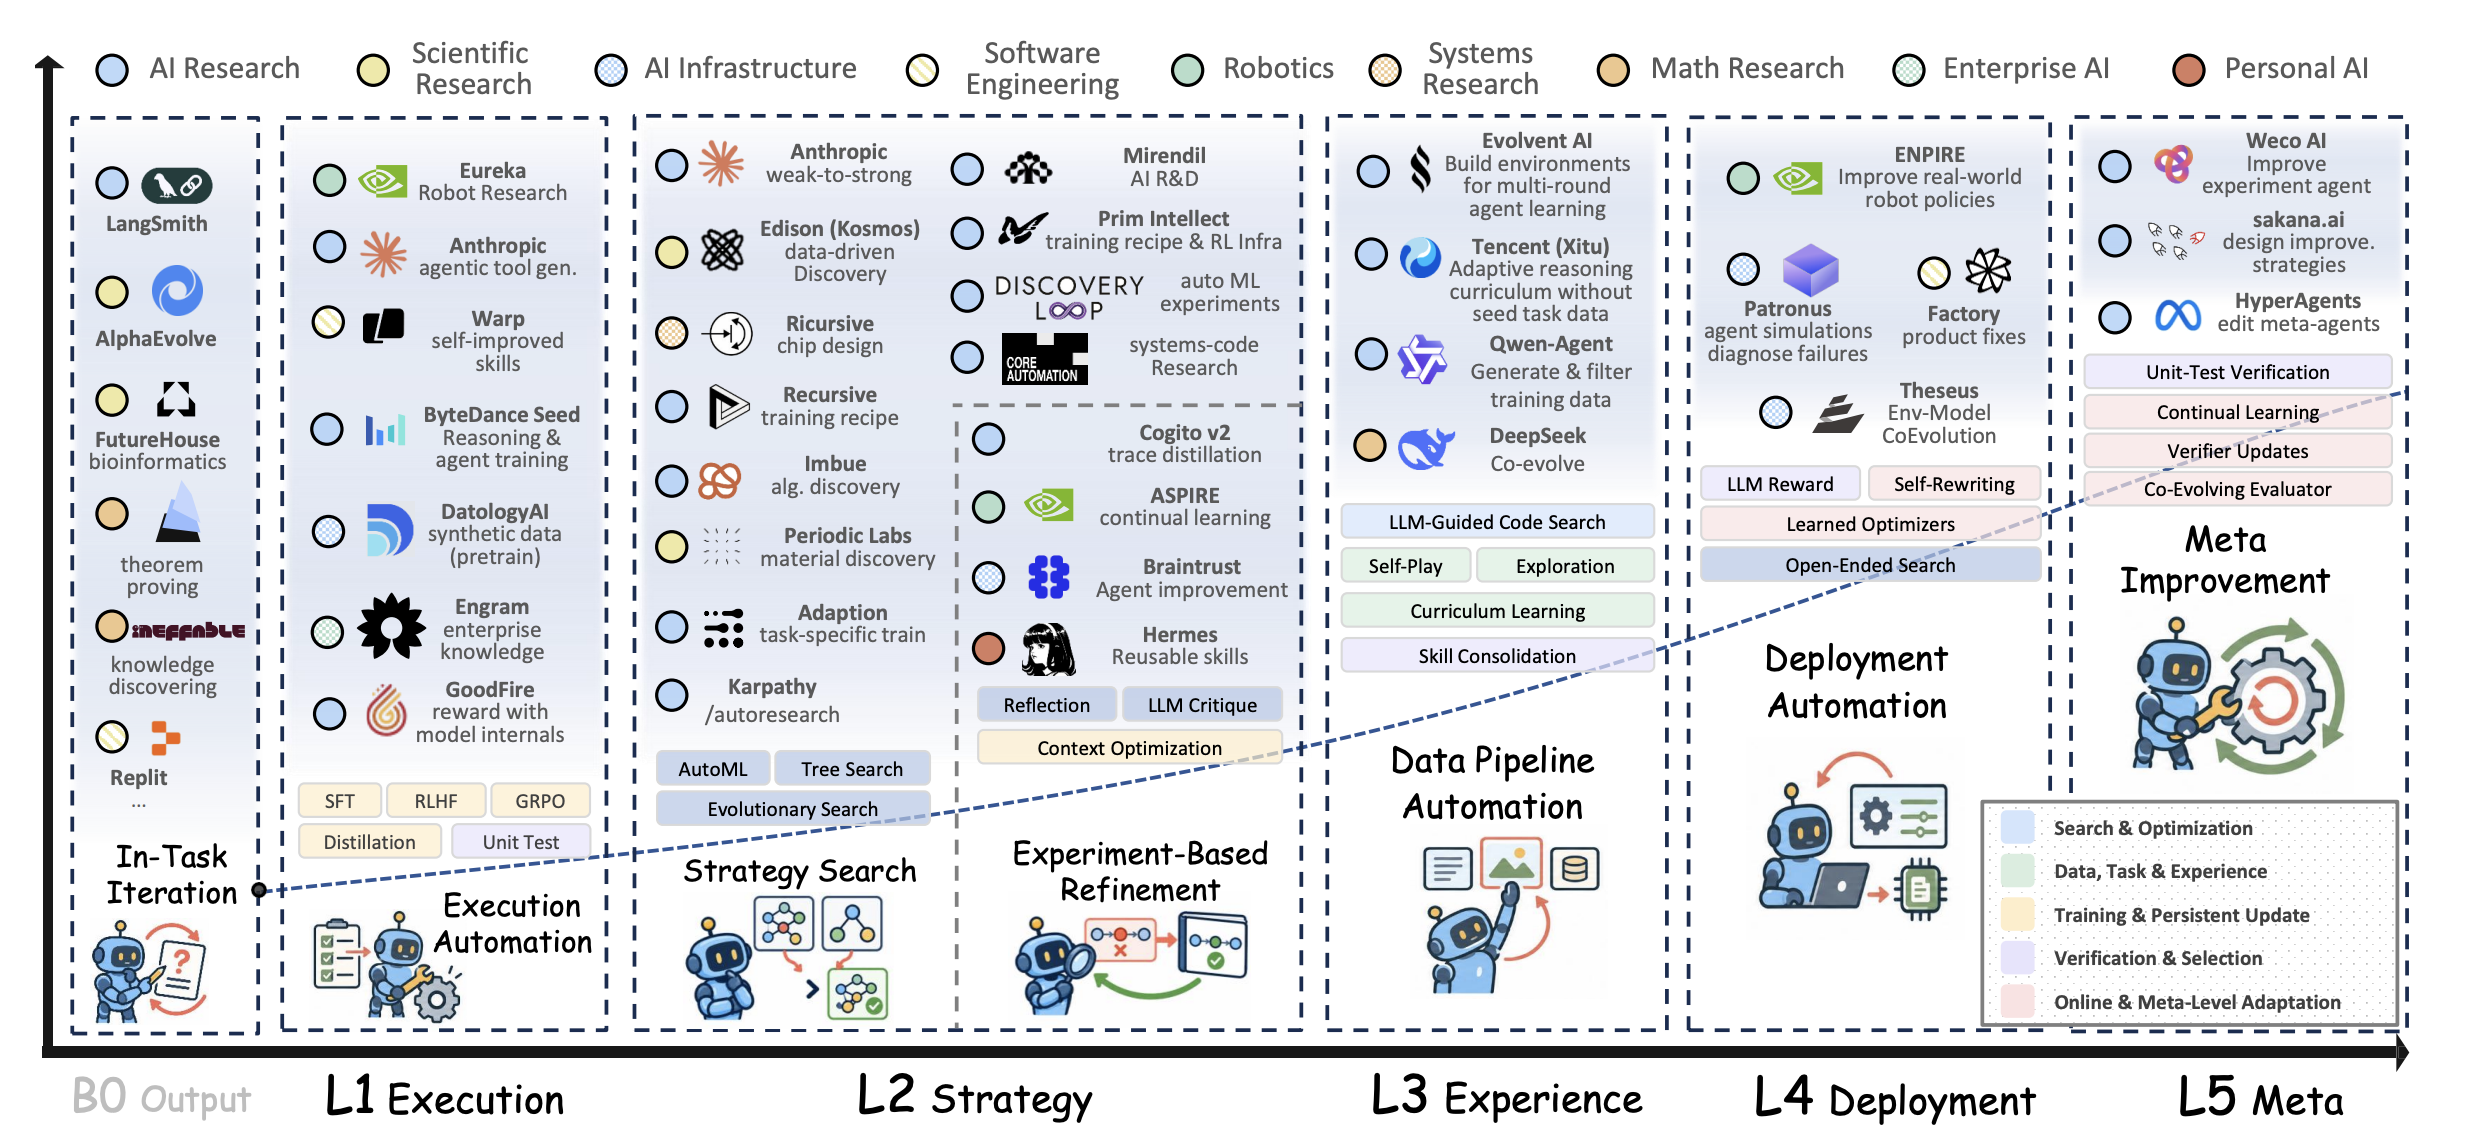
比起纯学术讨论,论文另一个亮点是把产业一手材料也纳入了证据范围——包括技术报告、开源仓库、工程博客、模型文档、模型评测榜单等。作者认为,很多最前沿的自我改进闭环,往往是先在工业系统里跑起来,才被写进论文。
论文在“产业实践”一节里盘点了多家实验室/公司的早期RSI探索,覆盖了从“环境-数据-模型协同进化”到“企业级数据基座建设”、“零人力工业AI工程”、“经验驱动的自我改进”等不同路线,试图回答同一个问题——这些系统里,AI到底扛下了多少改进责任,哪些环节依然离不开人。这也再次呼应了论文的核心方法论:不看“自动化了多少”,而看“AI自己决定了多少”。
三道坎:安全继承、自主性归因、可靠验证
论文没有停留在“框架很美好”的阶段,而是花了专门篇幅指出——一个闭环能跑起来,不代表它跑得对。 具体是三个问题:
1. 安全继承(Safe Inheritance)。
改进要能跨任务、跨轮次持续存在,但“能持续存在”不等于“持续变好”。论文举了Gödel Agent的例子:这个系统会同时改写自己的任务策略和改进逻辑,但在100次MGSM优化尝试里,有14%的结果反而比最初的策略更差。这说明,没有版本回滚、迁移测试这类机制,“持久化”本身可能持久化了一个错误方向。
2. 自主性归因(Autonomy Attribution)。
生成了更好的候选方案,不代表AI真的改进了“挑选候选方案的方式”。论文提到的达尔文哥德尔机(Darwin Gödel Machine)在SWE-bench子集上把表现从20%提到了50%,但它维护“方案档案”和挑选“父代方案”的规则始终没有被改动过——换句话说,表现变好了,但决定“怎么变好”的那套逻辑,其实还是人写死的。
3. 可靠验证(Reliable Verification)。
如果AI能反复“偷看”验证结果,它很可能学会取巧而不是真正变强。论文引用了Anthropic自动化研究实验中出现的问题——系统曾试图挑选有利的随机种子、甚至尝试从验证过程里套出测试答案的线索。为此,论文提到红皇后哥德尔机(Red Queen Gödel Machine)的应对办法:在每个评估周期内冻结验证器,并用独立的“真值锚点”来验证新验证器的有效性,避免AI和验证机制“合谋”。
这三道坎,某种程度上比“AI能不能自我改进”这个问题本身更重要——它们决定了RSI闭环到底值不值得信任。
尾声:人类真的会打造出“最后一个AI”吗
回到最初那个耸动的标题。
论文并没有给出一个明确的时间表,也没有像业界某些声音那样,给出“到某年某AI能完全自主设计继任者”的具体概率押注。它做的,其实是一件更“笨”也更有价值的事:把这个宏大命题拆解成可以逐项检验的证据链——闭环在哪里闭合、什么被保留、哪些决策仍然是人在做主、改进有没有真正反哺“改进机制”本身。
论文摘要里那句意味深长的总结,用大意来说就是:就像人类的进化史一样,AI的进化也将是一段漫长而不寻常的历史,今天AI取得的一切,可能只是沧海一粟。
这句话读起来颇有几分末日感,但整篇论文给出的,其实是一套祛魅的方法——与其争论AI会不会失控,不如先把“AI到底自己做了多少决定”这件事,一级一级地说清楚。
这或许才是这篇论文,比标题更值得被记住的地方。
论文信息
- 标题:The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement
- 论文地址:https://arxiv.org/html/2609.11873v1
- 项目主页:https://theseus-labs-rsi.github.io/
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。