本文永久链接 – https://tonybai.com/2026/10/11/go-benchmark-every-release-since-2013
大家好,我是Tony Bai。
【导读】
Go 到底比 13 年前快了多少?每次升级,是真有收益,还是心理安慰?一位开发者用同一批程序、同一台机器,把 Go 1.2 到 Go 1.27 共 26 个版本完整测了一遍。结果出人意料:数值计算十年没变,真正的红利全在 runtime。
【文章要点】:
- 13 年 26 个版本大摸底:Praneos Labs 使用完全相同的硬件与源码,对 Go 1.2 到 Go 1.27 的每个版本进行了无缓存严格压测:Go 1.27 比 1.23 整体提速 11.5%,比 13 年前的 Go 1.2 提速约 41%;
- 三段式演进规律清晰:性能跃迁主要发生在 Go 1.5
1.7 的编译器大换血(自举重构与 SSA 后端)和 Go 1.241.27 的 runtime 集中发力;中间 7 年(Go 1.8~1.23)吞吐量趋于平稳,技术精力主要用于攻坚亚毫秒级 GC 低延迟; - 业务收益冰火两重天:高频使用 map、重内存分配、依赖 GC 的业务型代码提升惊人(如 Swiss Table 让 map 密集程序耗时腰斩 57.5%);而纯数值计算循环自 Go 1.7 引入 SSA 之后机器码几乎原地踏步;
- 跑得快比“用的核少”更省电:基于物理能耗模型计算,Go 1.27 比 1.23 省电 11.5%;程序的绝对运行时长对服务器总能耗的影响远高于占用了多少个核心;
- Go vs C 的真实差距剖析:官方排行榜上 Go 落后 C 语言数倍的表现,绝大部分源自 C 程序依赖手写的平台级 SIMD 向量化指令;在纯标量代码对比下,Go 的性能与 C 的差距已大幅收敛至 0%~30%,个别任务甚至反超。

升级 Go 版本,到底值不值?
官方 Release Notes 里的数据,多是小范围测试。网上的博客,大多只对比两个版本。想看完整的 13 年历史,一直没有现成的答案。
最近,Praneos Labs 做了一件“笨功夫”:用同样的程序、同样的源码,在同一台机器上,把 Go 1.2 到 Go 1.27 的每个版本都跑了一遍。
先说结论:
- Go 1.27 比 Go 1.23 快 11.5%,比 Go 1.2 快约 41%。
- 提升集中在两个阶段:Go 1.5 到 1.7 的编译器变革,以及 Go 1.24 到 1.27 的 runtime 优化。
- 数值计算类程序,从 Go 1.7 之后基本没有变化。
- Go 与 C 的差距,大部分来自手写 SIMD 指令。
下面逐一拆解。
这个 Benchmark 是怎么测的?
先看测试方法,因为数据可信不可信,全看这里。
测试程序:取自 Benchmarks Game 的 10 个任务,每个任务选用最快的 Go 程序。pidigits 和 regex-redux 的最快版本依赖 C 库(GMP 和 PCRE),所以额外加入了纯 Go 版本,合计 12 个程序。
源码处理:有 5 个程序用到了 Go 1.2 里没有的函数,例如 strings.Builder 和 sort.Slice。作者在每个程序里改了一行。改后的程序输出一致,在 Go 1.27 上的速度也与原版相同。
测试版本:每个小版本的最新补丁,从 go1.2.2 到 go1.27.1,共 26 个版本。安装包来自 Go module proxy,并与 Go 校验和数据库做了比对。
测试机器:GCP c3-standard-8 虚拟机,关闭 SMT,4 个物理核心(Xeon Platinum 8481C),32 GB 内存。
测试轮次:5 轮,每轮每个程序在每个版本上各跑一次,每轮之前清空页缓存。
数据质量方面,作者做了三项检查:
- 全部 26 个版本的完整输出,与参考输出逐字节一致。
- 共 1,560 次计时运行,虚拟机 steal time 为 0 秒。
- 多次运行之间的波动,中位数仅 0.29%。
整套测试脚本、原始数据和流程都已开源(github.com/nrnjn42/go-bench),完整跑一遍约 5 小时,成本约 2 美元。这意味着你也可以自己复现。
13 年三段式演进:Go 的性能是怎么变快的?
作者把所有版本的耗时,统一换算成相对 Go 1.27 的倍数(1.00 代表与 Go 1.27 相同,数字越大越慢):
| 版本 | 1.2 | 1.4 | 1.5 | 1.6 | 1.7 | 1.8 | 1.10 | 1.13 |
|---|---|---|---|---|---|---|---|---|
| 相对耗时 | 1.69 | 1.83 | 1.42 | 1.39 | 1.21 | 1.16 | 1.16 | 1.12 |
| 版本 | 1.16 | 1.20 | 1.23 | 1.24 | 1.25 | 1.26 | 1.27 |
|---|---|---|---|---|---|---|---|
| 相对耗时 | 1.14 | 1.14 | 1.13 | 1.06 | 1.04 | 1.01 | 1.00 |
把这条曲线画成时间线,可以清楚地看到三个阶段:
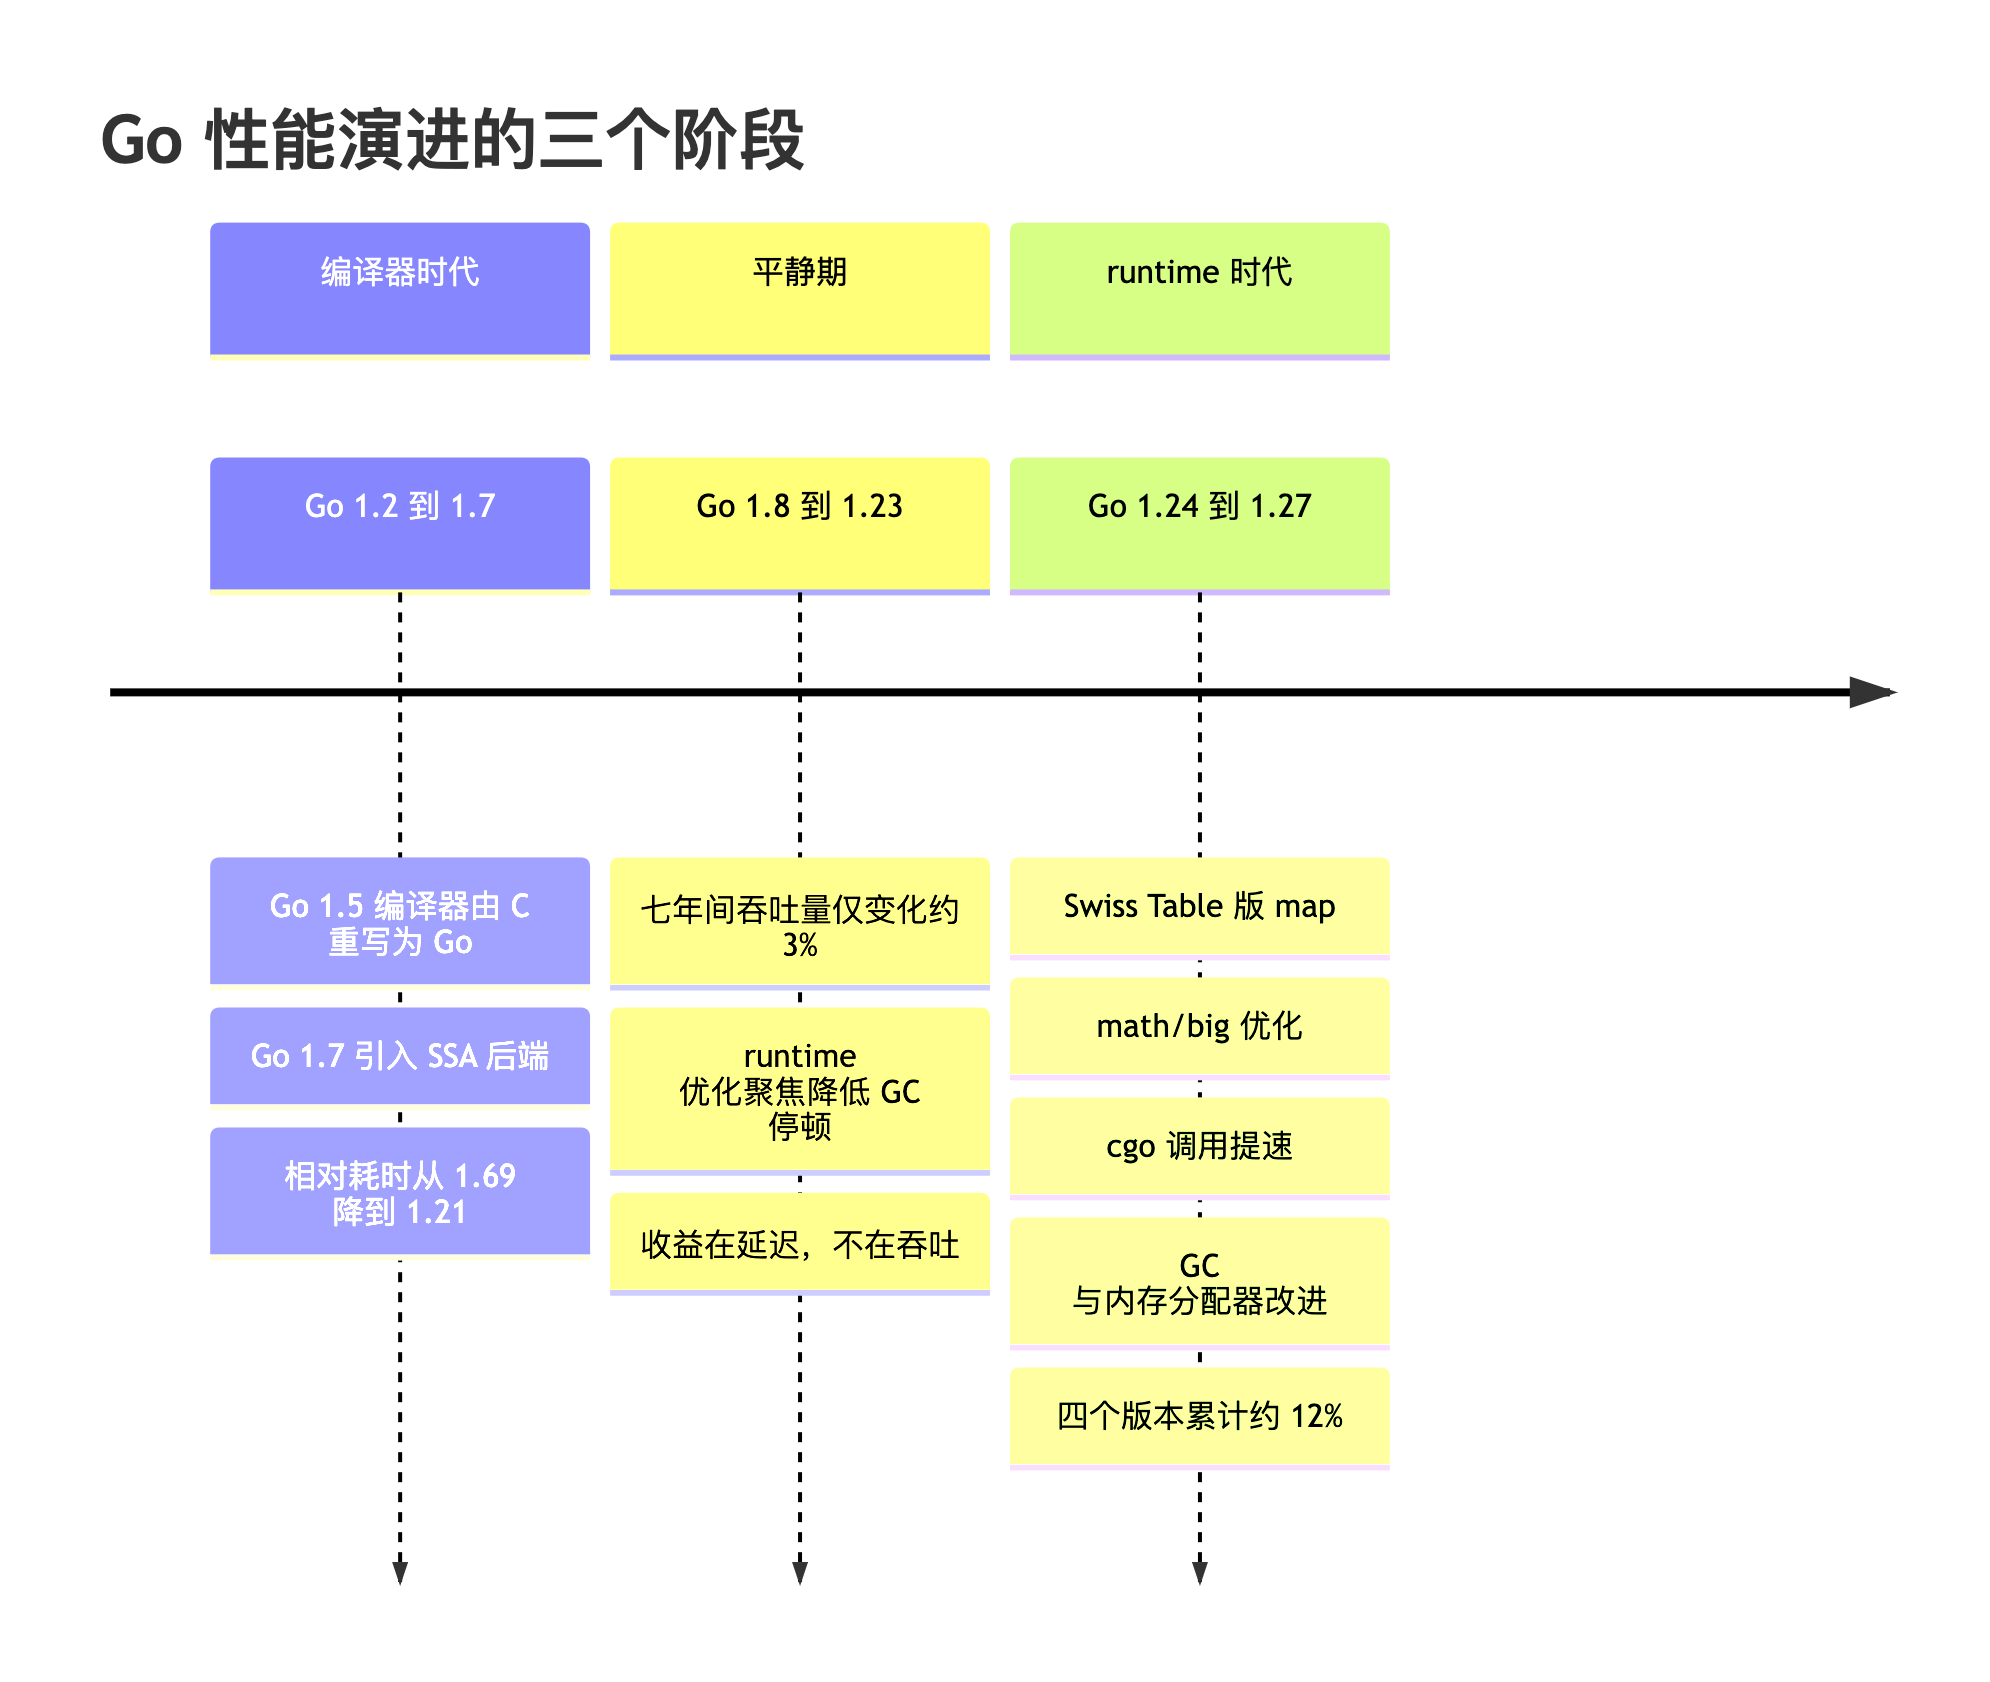
第一阶段(Go 1.2 到 1.7):编译器大换血。
Go 1.5 把编译器从 C 重写为 Go,Go 1.7 引入 SSA 后端。收益立竿见影:n-body 的 CPU 时间直接减半,fannkuch-redux 的耗时下降约 30%。
顺带一提:Go 1.4 到 1.5 之间,曲线其实是先升后降的(1.83 → 1.42),编译器重写的“阵痛期”也体现在了构建时间上,Go 1.5 和 1.6 的编译明显更慢。
第二阶段(Go 1.8 到 1.23):七年平静期。
吞吐量只变化了约 3%。这不代表 Go 团队在偷懒,这几年 runtime 的主要工作是降低 GC 停顿,收益体现在延迟上。而这个 Benchmark 测的是吞吐量,看不到这部分价值。
第三阶段(Go 1.24 到 1.27):runtime 全面发力。
Swiss Table 版 map、math/big、cgo、GC 和内存分配器相继优化,四个版本累计提升约 12%。
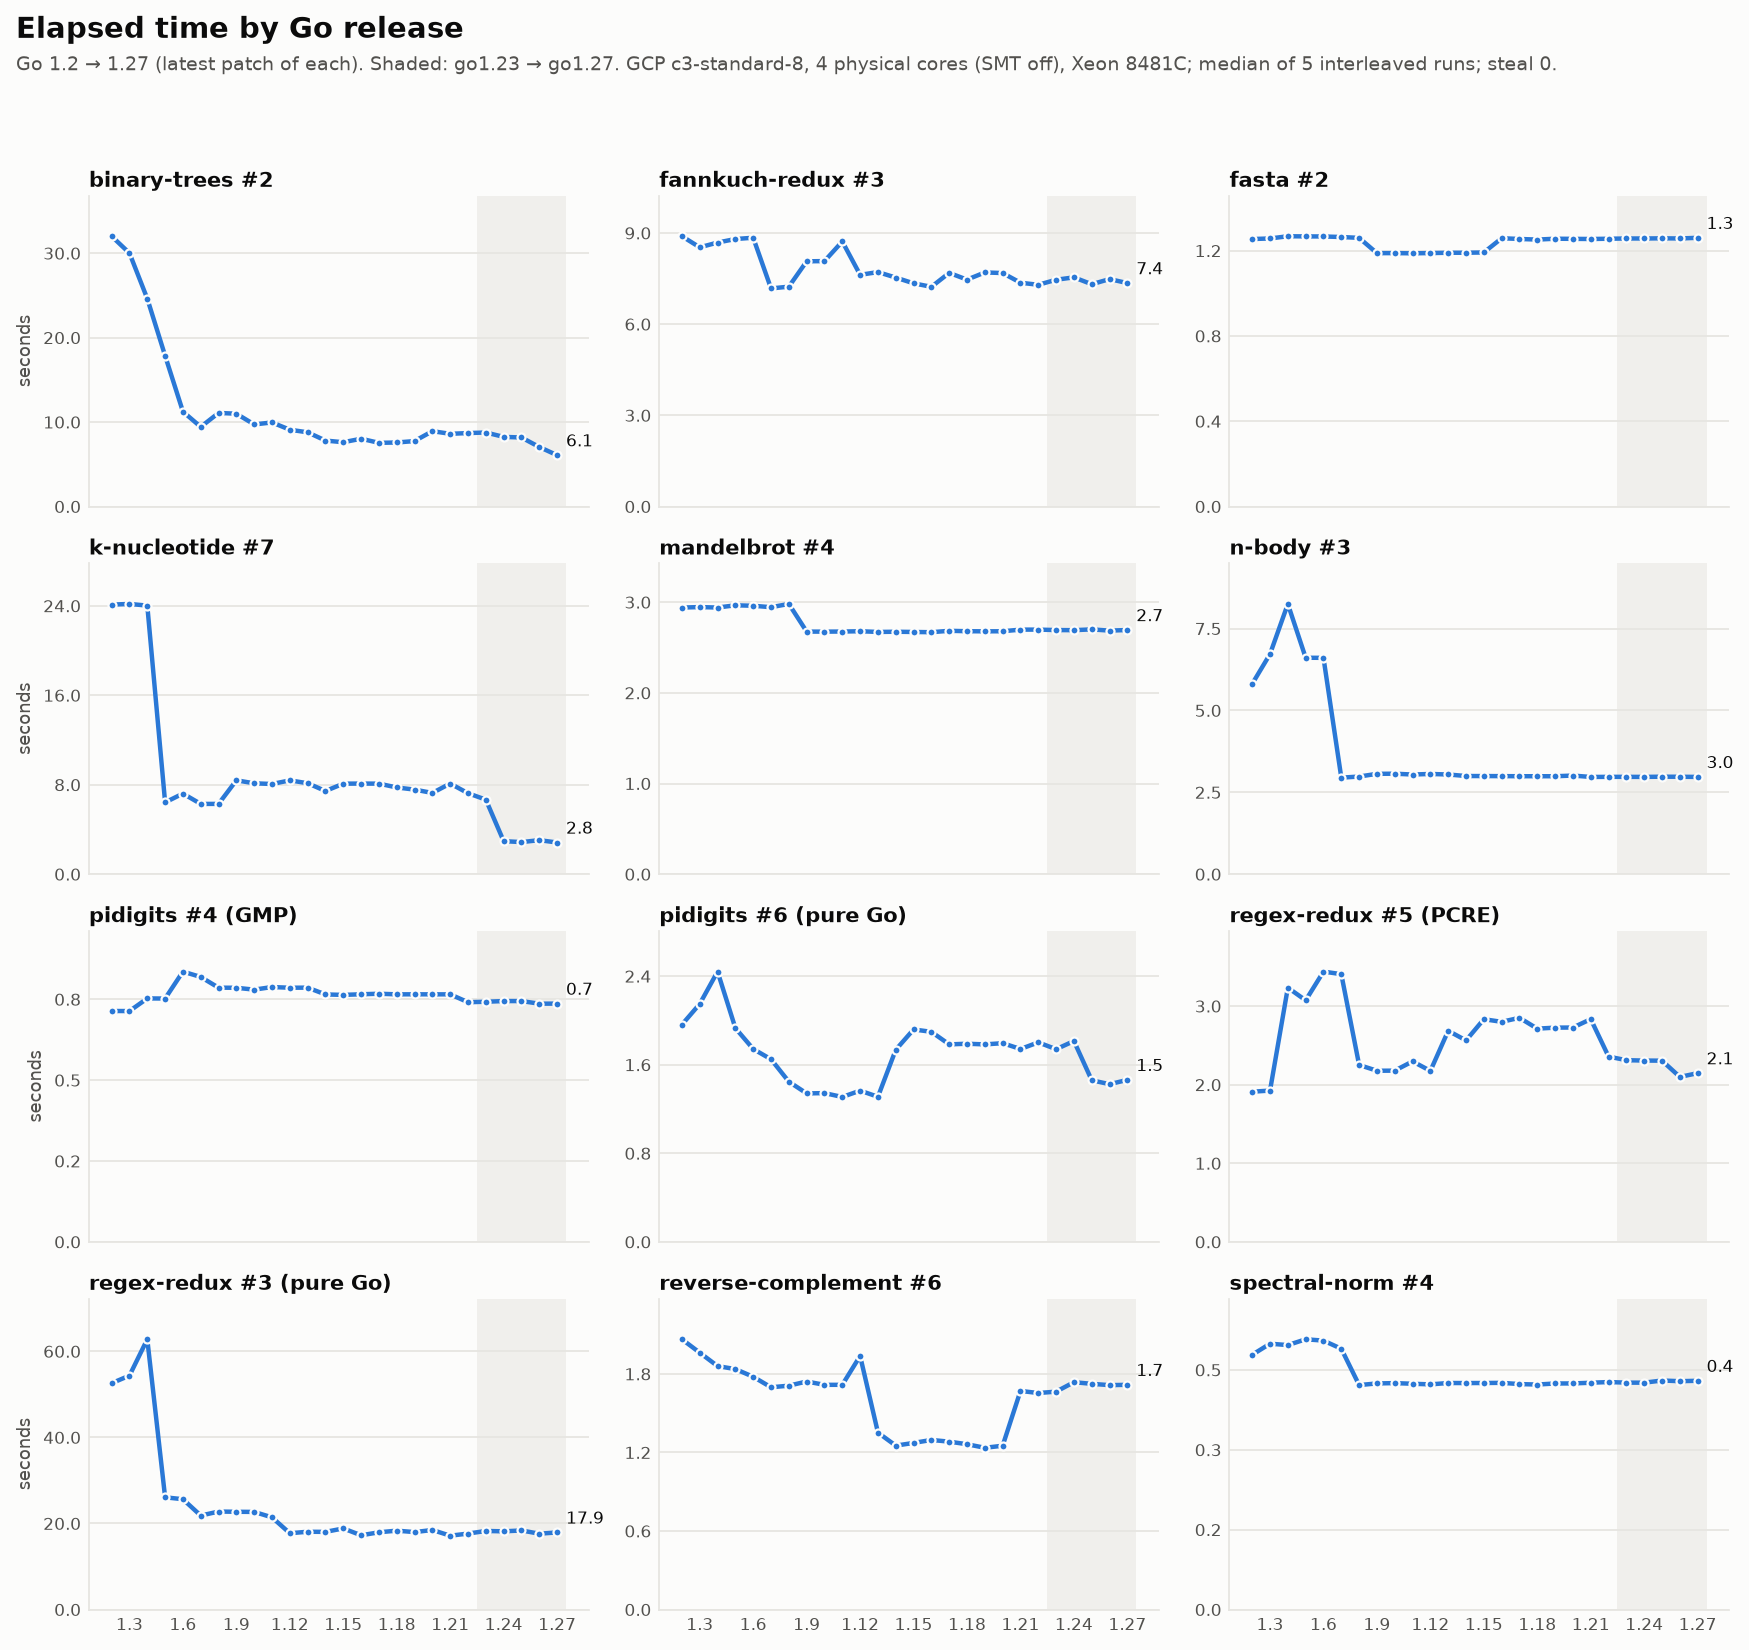
Go 1.23 vs Go 1.27:谁变快了,谁没动?
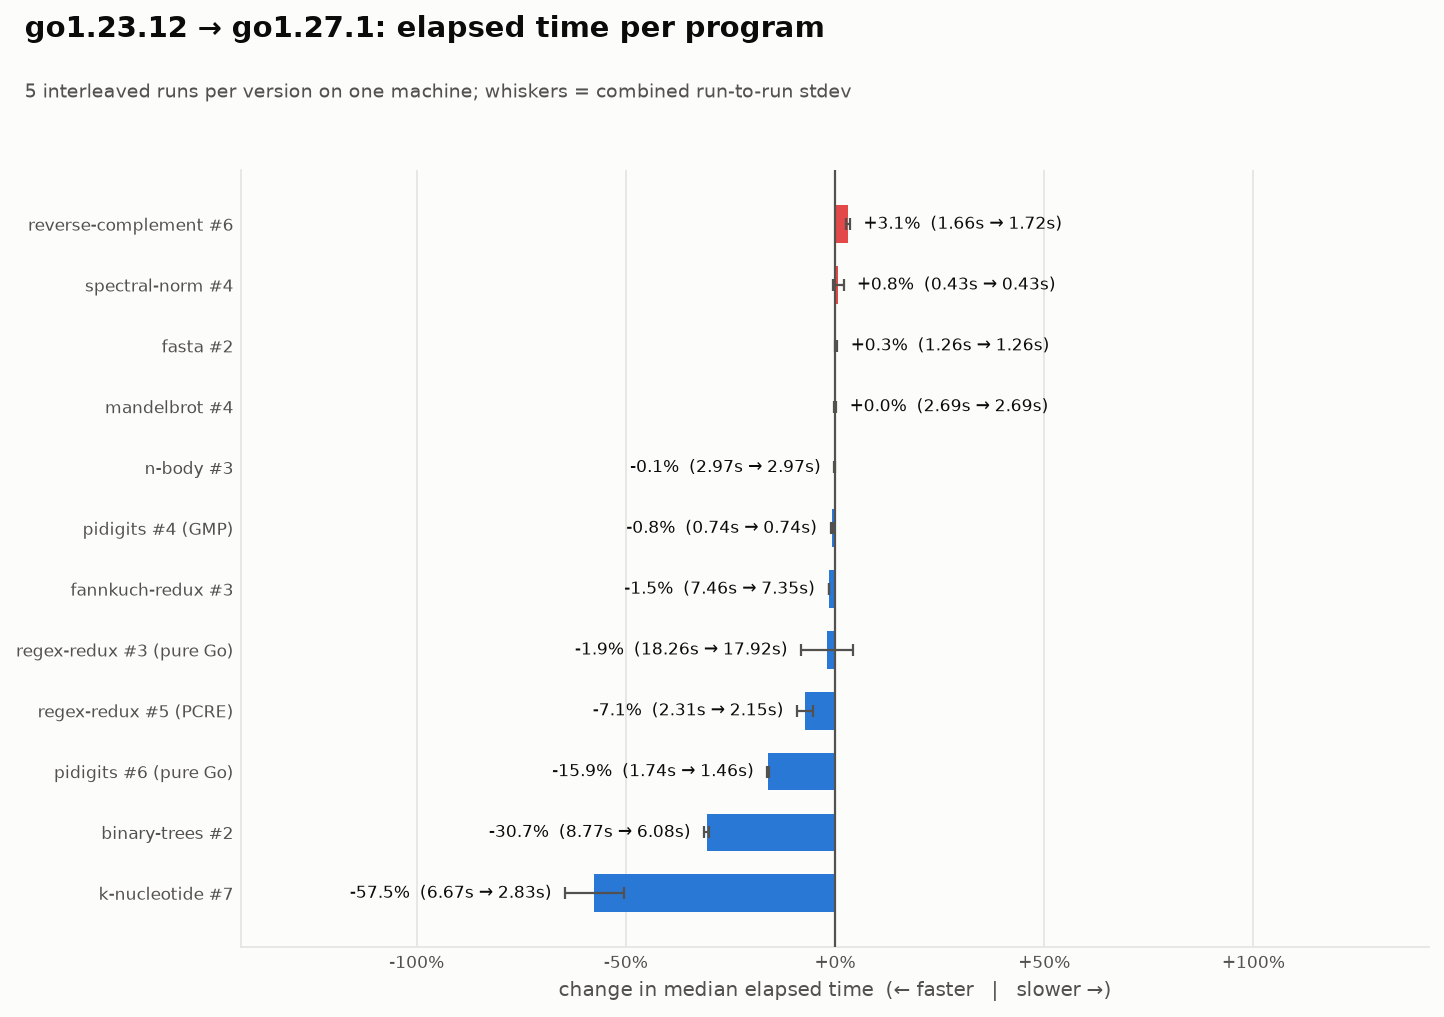
整体 11.5% 是几何平均值,具体到每个程序,差异非常大:
| 程序 | Go 1.23.12 | Go 1.27.1 | 变化 | 原因 |
|---|---|---|---|---|
| k-nucleotide | 6.67 s | 2.83 s | −57.5% | Swiss Table map(Go 1.24) |
| binary-trees | 8.77 s | 6.08 s | −30.7% | GC 与内存分配器,仅 Go 1.27 就贡献 14% |
| pidigits(纯 Go) | 1.74 s | 1.46 s | −15.9% | math/big(Go 1.25) |
| regex-redux(PCRE) | 2.31 s | 2.15 s | −7.1% | cgo 调用提速(Go 1.26) |
| regex-redux(纯 Go) | 18.27 s | 17.92 s | −1.9% | — |
| fannkuch-redux | 7.46 s | 7.35 s | −1.5% | — |
| n-body、mandelbrot、fasta、spectral-norm、pidigits(GMP) | — | — | ±1% | 基本不变 |
| reverse-complement | 1.66 s | 1.72 s | +3.1% | 峰值内存增加 29% |
| 几何平均 | −11.5% | CPU 时间 −12.3% |
这张表可以浓缩成一句话:
用 map、重分配、重 GC 的程序,快了很多;纯数值循环,原地踏步。
n-body、mandelbrot、spectral-norm 生成的机器码,和老版本几乎一样,编译器在这方面已经很久没有大动作了。
另外要留意一个"副作用":reverse-complement 变慢了 3.1%,峰值内存增加了 29%。性能提升并非没有代价,升级后建议关注自己服务的内存曲线。
能耗:跑得快,比“用的核少”更省电
作者没有直接测功耗,而是采用了 van Kempen 等人 2024 年论文《It’s Not Easy Being Green》中的模型,并用其公开的 RAPL 原始数据(3,192 次运行,13 种语言)重新拟合:
energy ≈ 1.99 J × CPU-seconds + 286.6 J × elapsed-seconds (R² = 0.97)
关键点在于:只看 CPU 时间,完全解释不了能耗(R² ≈ 0)。原因是那台服务器空闲时就有约 287 W 的基础功耗。
所以结论很反直觉:程序的运行时长,对能耗的影响远大于它占用了多少个核。
按这个模型计算:
- Go 1.27.1 比 Go 1.23.12 省电 11.5%
- Go 1.27.1 比 Go 1.8 省电 14%
需要强调:这是模型估算,不是实测。
Go 到底比 C 费多少电?2017 年那张表该更新了
2017 年,Pereira 等人发表了《Energy Efficiency across Programming Languages》,那张“语言能耗排行表”被广泛转发。在那张表里,Go 的能耗是 C 的 3.23 倍,排在 27 种语言中的第 14 位。
这项研究没有写明 Go 的版本,但作者通过线索做了推断:
- 测试机器用的是 Ubuntu 16.10
- 代码发布于 2017 年 8 月 28 日,距 Go 1.9 发布仅四天
- Go 1.10 要到 2018 年 2 月才发布
因此,研究大概率使用的是 Go 1.7 或 Go 1.8。
作者用原研究中的 Go 程序,在 Go 1.8 和 Go 1.27 上重新测了一遍,再对原始结果做缩放,得到下面的对比(C = 1.00):
| Go 的综合得分 | 能耗 | 时间 | 能耗排名(约) |
|---|---|---|---|
| 2017 年原研究 | 3.25 | 2.83 | 14 / 27 |
| 同样程序,Go 1.27 | 约 2.25 | 2.07 | 约第 8 |
| Go 1.27 + 预分配 binary-trees | 约 1.57 | 1.56 | 约第 4 |
注意:其他语言的数据仍沿用 2017 年的结果,没有重测,所以排名只是大致位置。
10 倍提速:把 GC 从 binary-trees 里拿掉
binary-trees 是个“GC 压力测试”:它会分配数百万个小节点。作者专门写了一个不吃 GC 的版本:
- 每个 worker 把节点放进预分配的 slice
- 节点之间用
int32下标而不是指针互相引用 - GC 不需要扫描这些节点
- 程序启动后不再分配内存
结果非常惊人:
| Go 1.27 | Go #2(原版) | 预分配版本 |
|---|---|---|
| 耗时 | 11.28 s | 1.09 s |
| CPU 时间 | 42.85 s | 3.41 s |
| 峰值内存 | 594 MB | 131 MB |
提速约 10 倍,速度基本追平 C。
需要说明的是,Benchmarks Game 的规则不允许这类自定义内存池方案,所以这个版本不能参与官方榜单。但 C 版本同样使用了 APR 内存池库,所以它也并非“不公平”。
这里还有个有意思的坑:作者的第一版程序,4 核竟然比单核还慢。罪魁祸首是伪共享(false sharing):4 个 slice header(每个 24 字节)挤在同一条缓存行里,多核互相抢占。把每个 header 填充到 128 字节后,耗时从 8.3 秒直接降到 1.09 秒。
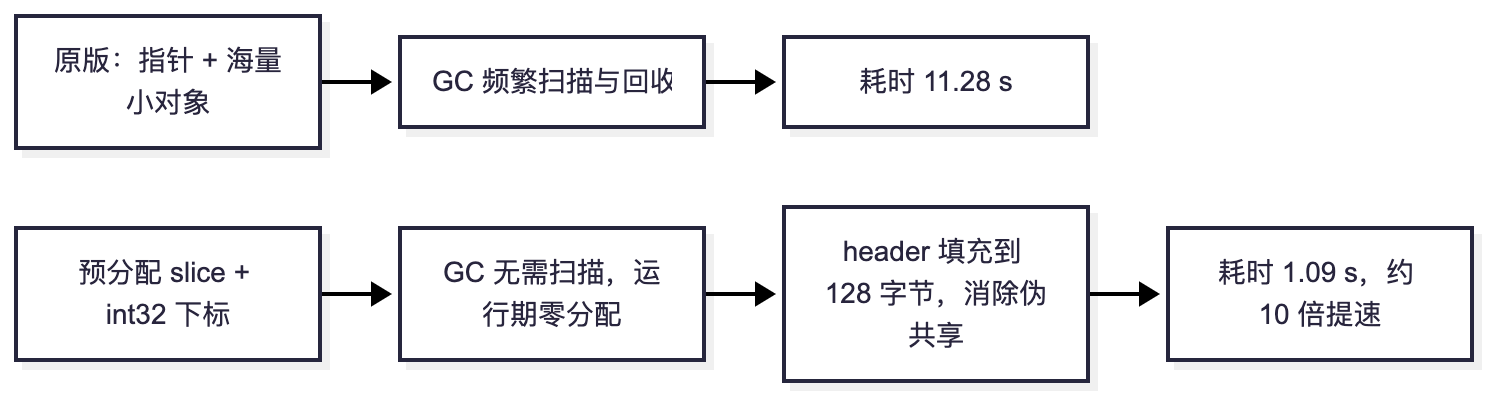
这个实验最有价值的启示是:对于重分配型程序,改内存布局带来的收益,远大于升级 Go 版本本身。
Go 为什么比 C 慢?罪魁其实是 SIMD
一个常见的疑问:Go 是不是因为要清零内存,才比 C 慢?
作者的答案是:不是。这些循环几乎不分配内存,清零的开销可以忽略。
真正的主因是手写 SIMD 指令。在 Benchmarks Game 榜单上,10 个任务中有 5 个的最快 C 程序,标注了“可能含手写向量指令”。源码中可以看到:
- n-body、spectral-norm 使用 AVX(
__m256d) - mandelbrot 使用 SSE2
- fannkuch-redux、reverse-complement 使用
_mm_shuffle_epi8字节混洗
把 Go 分别和“最快 C”与“最快的无 SIMD 标量 C”对比:
| 任务 | Go ÷ 最快 C(含 SIMD) | Go ÷ 最快标量 C |
|---|---|---|
| n-body | 3.0× | 1.28× |
| spectral-norm | 3.6× | 1.00× |
| mandelbrot | 2.9× | 0.93× |
| fannkuch-redux | 3.9× | 1.15× |
一旦去掉 SIMD 的加成,Go 与 C 的差距缩小到 0%~30%,个别任务甚至略快。
当然,剩下的差距也有来源:
- Go 编译器为了追求编译速度,做的优化更少
- C 程序使用
-march=<cpu>,Go 程序使用GOAMD64=v2 - Go 带有边界检查
- 重分配的程序要承担 GC 开销
- 部分 C 程序依赖 C 库,如 PCRE2-JIT 和 khash
所以下次看到“Go 比 C 慢 3 倍”的说法,不妨先问一句:对方比的是什么 C?
给开发者的四条建议
- 用最新版本。不改一行代码,Go 1.27 比 1.23 快 11.5%。map 密集和分配密集的程序,收益更大。
- 期待 runtime,别期待编译器。近几年的红利来自 map、GC、
math/big和 cgo。数值代码的速度,自 Go 1.7 起基本没变。 - 重分配场景,优先改内存布局。无指针的 arena 之类的设计,收益可达 10 倍,远超升级版本。
- 看“Go vs C”的榜单要多留个心眼。很多差距实际上是 SIMD 之差,不是语言之差。
小结:注意这份数据的边界
结论虽然漂亮,但有几点必须交代:
- 这些都是小型基准程序,测的是吞吐量,不涉及延迟和 GC 停顿。
- 所有结果来自一台机器(Intel Sapphire Rapids)。相对变化大概率可迁移,绝对耗时不能直接套用。
- 能耗是模型估算,不是实测。
- Pereira 对比与预分配 binary-trees 这两部分,来自共享开发 VM,精度略低于 GCP 机器上的主测试。
真实业务,请务必用自己的负载压测一遍。
原文链接:https://praneos.com/blog/go-performance-1-2-to-1-27/
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。