本文永久链接 – https://tonybai.com/2026/09/21/go-testing-goroutine-labels-proposal
大家好,我是Tony Bai。
【导读】
多测试并发跑、CI 超时、goroutine 堆栈刷屏——这大概是每个 Gopher 都经历过的噩梦。Go 团队最新一期 proposal review 会议纪要显示,一个专治“测试卡死排查难”的提案 #75047:testing: add goroutine labels to tests 已经正式进入 active(活跃评审) 阶段。它想做的事情很简单:让每一个 goroutine,从出生那一刻起就自带“工位牌”,写清楚“我是哪个测试造出来的”。
【文章要点】
- Go 测试超时排查的老大难问题:知道“有哪些测试还没跑完”,但不知道“这些卡住的 goroutine 分别属于哪个测试”
- 提案核心方案:为每个测试 / 基准测试 / 模糊测试自动打上
test(或test.name)与test_iter(或test.iter)两个 goroutine label - 已有配套 CL:CL 696117、CL 696595(实现提案),以及关联的 CL 694119(让 runtime 崩溃回溯打印 label)
- 社区争论焦点:一个 label 还是两个 label、label key 怎么命名、分隔符用什么字符、迭代号要不要在第一次也打印
- 提案评审委员会(aclements 等)已明确表态:“方向没问题,剩下的都是命名细节”
- 这类“看似很小”的提案,其实揭示了 Go 团队一贯的工程哲学:先解决真实痛点,再抠字段命名

测试卡死,却不知道该杀哪个 goroutine
写 Go 的人大概都遇到过这种场景:CI 跑到某个包突然卡住,几分钟后被 go test -timeout 无情终止,日志里甩出一大坨 goroutine 堆栈。Go 1.21 之后,测试框架已经能贴心地打印出“当前还有哪些测试函数尚未结束”,这确实比过去“一片死寂”要好太多。
但一个新问题随之而来:知道有 10 个测试没跑完,和知道这几十个 goroutine 各自属于哪个测试,完全是两回事。尤其是那些喜欢在内部疯狂开 goroutine 的测试用例,一旦卡死,留给你的就是几百行看不出归属的堆栈——排查效率约等于大海捞针。
这正是 Go 官方 issue #75047:proposal: testing: add goroutine labels to tests 想解决的问题。根据 Go 团队最新一期 proposal review 会议纪要,这个提案已经被评审负责人 aclements 正式移入了 active(活跃)列,意味着它将进入每周例行评审流程,离落地又近了一步。
Go 早就有“标签”机制,只是测试没用上
要理解这个提案,得先回顾一个 Go 老功能:goroutine profile label。
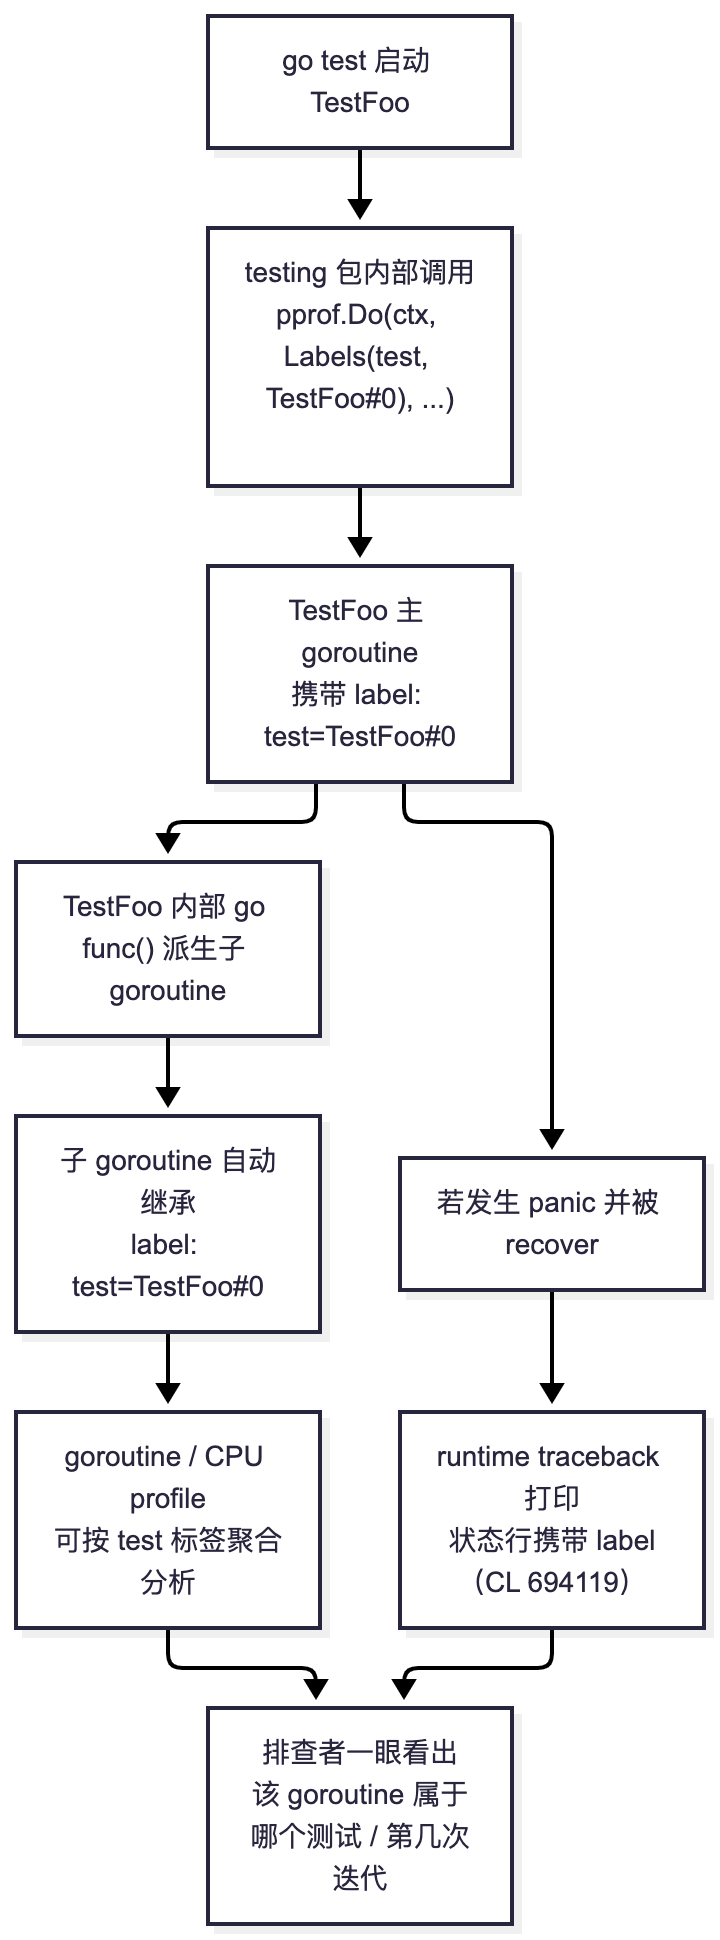
早在 Go 1.9 时代(提案 #17280),Go 就为 runtime/pprof 引入了 pprof.Do / pprof.Labels 这套机制:可以给当前 goroutine 挂上若干个 key-value 标签,而且子 goroutine 会自动继承父 goroutine 的标签。这些标签会出现在 CPU profile、goroutine profile 里,方便你按标签聚合分析。
pprof.Do(ctx, pprof.Labels("subsystem", "admin"), func(ctx context.Context) {
    // 这个函数以及它派生出的所有子 goroutine,
    // 都会带着 subsystem=admin 这个标签
    runAdminServer(ctx)
})
问题在于:go test 在调用每个测试函数时,并没有默认给它套上任何标签。也就是说,虽然基础设施早就有了,但测试框架自己没用起来。#75047 提案要做的,本质上就是“让 testing 包自己吃自己的狗粮”。
提案原文:两个 label,解决定位问题
提案作者给出的“稻草人方案”(straw-man proposal)很直接,为每一次测试调用打上:
- 一个 key 为
test、value 为完整测试名(等价于t.Name(),模糊测试则是f.Name())的标签; - 一个 key 为
test_iter的标签,记录该测试在-count参数下是第几次运行(用于反复执行以复现偶发问题的场景)。
配合另一个已经在路上的改动——CL 694119(关联 issue #23458,让 runtime 在打印 panic 恢复后的 traceback 时,把 goroutine label 直接显示在状态行里)——最终效果大概是这样:
goroutine 36 gp=0x33789cd803c0 m=0 mp=0x6d37e0 [running] {test: TestWithPanic#0}:
一眼就能看出:这个 goroutine 是 TestWithPanic 这个测试跑出来的,而且是第 0 次迭代。相比过去一堆裸堆栈,排查效率的提升是肉眼可见的。
下面用一张图还原一下“打标签 → 继承 → 展示”这条链路:
社区的“命名之战”:一个 label 够不够?
提案一发布,讨论很快就从“要不要做”转向了“具体怎么做”——这几乎是所有 Go 提案的标准剧情。
焦点一:一个 label,还是两个?
评审者之一 neild 提出了一个更极简的方案:干脆只用一个 test label,把测试名和迭代号拼在一起,比如 TestWithPanic#0;对于模糊测试,再加一段变成 TestFuzz#0#3(第 3 次模糊输入迭代)。
但 proposal作者马上指出了这个方案的代价:做性能分析(profiling)时,如果一个测试跑了几十上百次(-count 100),你往往只关心“这个测试整体消耗了多少 CPU”,而不关心每一次具体是第几轮——把迭代号拼进同一个字符串,会让 profile 工具里同一个测试的样本被拆散成几十条记录,反而不利于聚合查看。虽然 pprof 工具本身有 -taghide 可以做一定程度的模糊聚合,但终归不如“迭代号单独成一个 label”来得干净。
焦点二:分隔符用什么字符?
如果真的采用“单 label 拼接”方案,分隔符也有讲究。# 看似顺手,但 t.Run() 生成的子测试名本身就可能用 # 来区分重名用例(例如 TestWithPanic/Foo#1),如果再叠加迭代号,就会出现 test: TestWithPanic/Foo#1#0 这种容易看错的“双井号”局面。因此 proposal作者建议改用 @、+ 或 * 之类不那么容易混淆的符号。
焦点三:label key 该叫什么?
test / test_iter 这种下划线命名,还是 test.name / test.iter 这种点分命名,看起来是小事,但一旦定下来就要向后兼容很多年,社区里为此也做了专门讨论。
评审委员会的态度:方向没问题,剩下的是打磨
在最新的 proposal review 会议纪要中,评审代表 aclements 给出了相对清晰的表态,可以概括为几点:
- 方向完全认可:团队“完全支持做这件事”,唯一悬而未决的是标签具体长什么样;
- 迭代号应当“从第一次就打印”:与其只在第 2 次及以后才显示
test_iter(省去-count 1这种默认场景下的视觉噪音),委员会更倾向于统一规则——不管第几次,都打印迭代号,避免“第 1 次不标、第 2 次突然冒出来”这种不一致的体验; - 基准测试的迭代号有历史包袱:传统基准测试的自动扩容循环(auto-scaling loop)会重复执行 setup 代码本身就带来了“迭代号语义模糊”的问题,好在新式
b.Loop写法不存在这个问题,委员会认为不必为旧模式过度设计,直接用最外层-count驱动的迭代号即可; - 命名倾向已经浮现:从讨论走向看,
test.name/test.iter这种点分风格,可能更贴合委员会的口味。
也就是说,这个提案目前处于“大方向已经拍板、具体命名仍在打磨”的阶段——这也正是它被列入 active、进入常规评审节奏的原因。
配套工程:一条已经铺好一半的路
值得一提的是,这不是一个“空谈提案”,proposal作者已经把配套代码基本写好了:
- CL 694119:解决“标签怎么显示”的问题,让 runtime 在打印 panic 恢复后的 traceback 时,把 label 直接嵌入 goroutine 状态行;
- CL 696117 / CL 696595:解决“标签怎么打”的问题,在
testing包内部为每次测试 / 基准测试调用套上pprof.Do。作者也坦言这两个 CL “还需要一些打磨”(need a little work),意味着最终合入的实现细节,很可能会随着提案里 label 命名方案的敲定而调整。
另外一个值得关注的细节是性能敏感路径的取舍:目前 context.Context 每次设置 / 更新 label 都会分配一个新对象,这对普通测试函数没什么影响,但如果放到 benchmark 的内层循环里,就会带来不可忽视的分配开销。所以提案里也明确提到,不打算在压测的高频路径上做实时打标签,而是维持在测试 / 基准测试的外层粒度上打一次。
这对日常开发意味着什么
如果这个提案顺利落地,对日常工作流至少有三点直接影响:
- CI 超时排查效率提升:面对成百上千行的 goroutine dump,可以直接搜索
test: TestXxx定位相关堆栈,而不用凭经验猜测调用关系; - 压测 / 混沌测试更好归因:结合
runtime/pprof的 profile 聚合能力,你可以直接按test标签查看“到底是哪个测试贡献了最多 CPU 或者最多 goroutine 数量”; - 生态已经在朝这个方向收敛:值得一提的是,社区里已经有项目(例如 grpc-go)在给自己的服务端流 goroutine 打类似风格的 label(如
grpc.method),并且明确提到参考了 #75047 里讨论的命名思路。这说明“goroutine label 规范化”正在成为一种跨项目的共识,而不只是 testing 包自己的事情。
小结
从表面看,#75047 只是给 goroutine 加了一两个字符串标签,技术含量似乎不高。
但仔细读完整个讨论会发现,Go 团队在处理这类“小提案”时的一贯风格依然清晰可见:先确认问题真实存在、方案方向可行,再花大量精力去抠字段命名、分隔符、兼容性和性能代价这些细节。这种“慢工出细活”的评审文化,某种程度上也是 Go 语言 API 十年如一日保持稳定和可预测的原因之一。
对于日常写 Go 测试、经常被 CI 超时折磨的开发者来说,不妨持续关注这个提案的后续进展——它很可能会成为下一个让你“效率暴涨”的小功能。
参考链接
- 提案原文:https://github.com/golang/go/issues/75047
- 关联 issue(runtime traceback 展示 label):https://github.com/golang/go/issues/23458
- CL 694119(runtime traceback 展示 label):https://go.dev/cl/694119
- CL 696117(testing 包实现):https://go.dev/cl/696117
- CL 696595(testing 包实现):https://go.dev/cl/696595
- goroutine profile label 机制原始提案(#17280):https://go.googlesource.com/proposal/+/HEAD/design/17280-profile-labels.md
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。