本文永久链接 – https://tonybai.com/2026/11/04/go-zero-heap-allocation-noalloc
大家好,我是Tony Bai。
【导读】
Go 语言以自动垃圾回收降低了内存管理的复杂度,但在高性能服务、网络处理、实时系统等场景中,频繁的堆分配仍然可能带来 GC 压力、延迟抖动和额外的内存开销。
过去,Go 开发者主要依靠逃逸分析、对象复用、sync.Pool 和性能分析工具来减少分配。但这些手段有一个共同的问题:它们很难保证某段代码在未来的修改中仍然不发生堆分配。
最近,一个名为 noalloc 的 Go 实验项目引起了 Hacker News 社区的关注。它尝试提供一种新的思路:允许开发者声明某个函数必须零堆分配,然后自动检查该函数的整个调用链,把零分配要求作为工程约束持续执行。
从 Go 团队过去对 Arenas 的探索,到正在讨论的 Region 内存管理,再到 noalloc 提出的静态约束,我们或许正在看到 Go 内存管理理念的另一种演进方向。
本文将从 Go 的堆分配机制出发,结合可运行的代码示例,分析 noalloc 的设计、能力和局限。
【文章要点】
- Go 的堆分配为什么值得关注?它与 GC、延迟抖动有什么关系?
- 逃逸分析、对象复用、sync.Pool、Arenas 和 Region 分别解决什么问题?
- noalloc 如何检查一个函数及其整个调用链?
- bounded 库如何通过固定容量的数据结构实现可控内存使用?
- 如何用一个真实的 Go 示例验证 noalloc 的效果?
- 零堆分配是否意味着零 GC、零内存分配和更高性能?
- noalloc 距离生产级的内存安全与实时性保障还有多远?

Go 的一个性能问题:内存分配并不是免费的
Go 有一个非常重要的设计哲学:让开发者尽可能少地关心内存管理。
你可以随手创建对象、构造切片、使用 map,甚至在函数中返回局部变量的指针。编译器会通过逃逸分析(Escape Analysis)判断对象应该放在哪里:能够在栈上分配的,就尽量放在栈上;生命周期无法由编译器确定的,则可能逃逸到堆上,由 GC 负责回收。
这种设计极大地提高了开发效率,但也带来了一个问题:堆分配是有成本的。
一次堆分配不仅意味着调用内存分配器,还可能增加 GC 后续需要扫描和管理的对象数量。当一个服务持续产生大量短生命周期对象时,分配速率会直接影响 GC 的触发频率和 CPU 开销。
尤其是在网络服务、序列化、协议解析和高并发请求处理等场景中,频繁的小对象分配可能成为性能瓶颈。
当然,这里需要澄清:Go 的 GC 并不是每次分配都会立即执行,堆分配也不意味着每个对象都会产生相同的 GC 成本。真正值得关注的是分配速率、存活对象规模以及对象中指针的数量。
Go 官方的 GC 指南也明确建议:先通过 CPU Profile、Heap Profile 等工具识别 GC 是否构成实际瓶颈,再考虑消除热点路径上的堆分配。
那么,Go 开发者通常如何减少堆分配?
Go 减少堆分配的几条技术路线
过去这些年,Go 社区已经探索了多种减少内存分配的方式。
逃逸分析:让编译器决定对象的位置
这是 Go 最基础、也是最重要的优化手段。
例如:
type User struct {
    ID   int
    Name string
}

func NewUser(id int) User {
    return User{ID: id, Name: "Tony"}
}
这里返回的是一个值,编译器有机会将其放在调用者的栈帧中,而不必分配到堆上。
但如果我们改成:
func NewUser(id int) *User {
    u := User{ID: id, Name: "Tony"}
    return &u
}
这并不意味着 u 一定会逃逸到堆上。编译器仍然可能通过内联等优化消除堆分配。
可以通过以下命令查看编译器的判断:
go build -gcflags="-m=2" .
逃逸分析的优势是透明、自动,而且与 Go 语言现有的编程模型完全兼容。
但它解决的是编译器能够证明的分配问题,并不能保证整个业务调用链永远不会引入新的分配。
对象复用:sync.Pool 和预分配
另一种常见方式是复用已经分配的内存。
例如:
var bufPool = sync.Pool{
    New: func() any {
        return make([]byte, 4096)
    },
}

func process(data []byte) {
    buf := bufPool.Get().([]byte)
    defer bufPool.Put(buf)

    buf = buf[:0]
    buf = append(buf, data...)

    // 使用 buf
}
此外,还可以通过预分配 slice 容量、复用 bytes.Buffer、使用固定大小数组等方式减少重复分配。
不过,sync.Pool 并不是一个严格的内存保证机制。GC 可以清理其中的对象,下一次 Get 也不保证一定拿到之前放进去的对象。
它更适合降低分配压力,而不是建立零分配约束。
Arenas:一次申请,一次释放
2022 年,Go 团队提出了 Arena 实验方案。
其核心思想是:如果一批对象拥有相同或相近的生命周期,就没有必要逐个等待 GC 回收,可以把它们统一分配到一个 Arena 中,在任务结束时整体释放。
例如,一个 HTTP 请求在处理过程中可能创建大量临时对象。当请求结束时,这些对象通常也不再需要。
Arena 就是为这种场景设计的。
a := arena.New()
defer a.Free()

user := arena.New[User](a)
_ = user
这项实验在一些真实应用中取得了不错的效果。
Go 团队后续的 Memory Regions 设计文档提到,Arena 在实际应用中曾带来约 10%~15%的性能提升,收益主要来自更早地复用内存、减少 GC 执行。
但 Arena 的标准库提案(Go issue #51317)在 2023 年被无限期搁置。
原因并不是它没有性能价值,而是 API 设计存在较大问题:
- 很多标准库 API 如果要支持 Arena,都需要增加额外的 Arena 参数。
- 这会造成大量 API 变体,影响现有生态的组合能力。
- 显式指定 Arena 还可能阻止编译器原本可以完成的栈分配。
- 对象生命周期管理也增加了复杂性。
因此,Arena 实验并没有成为 Go 标准库的正式能力,不建议在生产代码中依赖它。
Memory Regions:更进一步的探索
2024 年出现的 Go Memory Regions 讨论(#70257),试图解决 Arena 的组合性问题。
它提出了一种不同的思路:不再要求开发者显式指定每个对象应该分配到哪个 Arena,而是通过一个函数作用域,隐式地将该作用域及其调用链中的部分堆分配归入一个 Region。
设想中的 API 类似这样:
region.Do(func() {
    data := new(MyBigComplexProto)
    _ = data
})
当 region.Do 返回时,仍然属于该 Region、且不再被外部引用的对象可以被提前回收。
如果某个对象被外部引用,运行时则会将其从 Region 中解除绑定,避免发生悬空引用。
这项设计的核心是:通过编译器和运行时协作,自动识别对象生命周期,而不是让开发者手工管理每一块内存。
它希望同时实现:
- 与现有 Go API 更好的组合性。
- 与逃逸分析、栈分配兼容。
- 与 sync.Pool 等现有机制协作。
- 在 goroutine 局部范围内复用内存。
需要强调的是,Memory Regions 目前仍然是设计讨论,并不是 Go 已发布的标准库功能。
从 Arena 到 Region,可以看到 Go 团队一直在探索一个问题:能否在不牺牲 Go 易用性的前提下,让运行时更了解对象的生命周期,从而减少 GC 的工作量?
但今天要介绍的 noalloc,走的是另一条路线。
noalloc:不只是减少分配,而是禁止分配
noalloc 的 README 开头有一个很有意思的观点:写出一段没有堆分配的代码是一回事,让这段代码在后续修改中始终没有堆分配,则是另一回事。
这正是它要解决的问题。
传统的 Go 性能优化通常是这样的:
- 使用 pprof 找到分配热点。
- 使用逃逸分析查看分配原因。
- 修改代码,消除分配。
- 运行 benchmark,验证优化效果。
- 未来某次代码修改可能又引入新的分配。
noalloc 希望把这个流程改变为:
开发者声明一个函数必须零堆分配,工具自动检查这个函数及其整个调用链。
例如:
//noalloc:root
func (c *Counter) Add(name string, n int) string {
    c.counts[name] += n
    return name + "=" + strconv.Itoa(c.counts[name])
}
这里有两个容易被忽略的分配问题:
- map 写入可能触发新的内存分配。
strconv.Itoa和字符串拼接可能产生堆分配。
运行 noalloc 后,它可以报告具体的分配位置:
counter.go:11: (*example.com/counter.Counter).Add: map write
counter.go:12: (*example.com/counter.Counter).Add: calls strconv.Itoa;
string concatenation; escapes: name + "=" + ~r0 escapes to heap
这就很有意思了。
它不仅告诉你某个函数存在分配,还能进一步追踪调用链,解释分配是从哪里传递过来的。
noalloc 的工作机制
noalloc 主要结合 Go 编译器的逃逸分析信息和静态调用关系分析来完成检查。
其工作流程可以概括为:
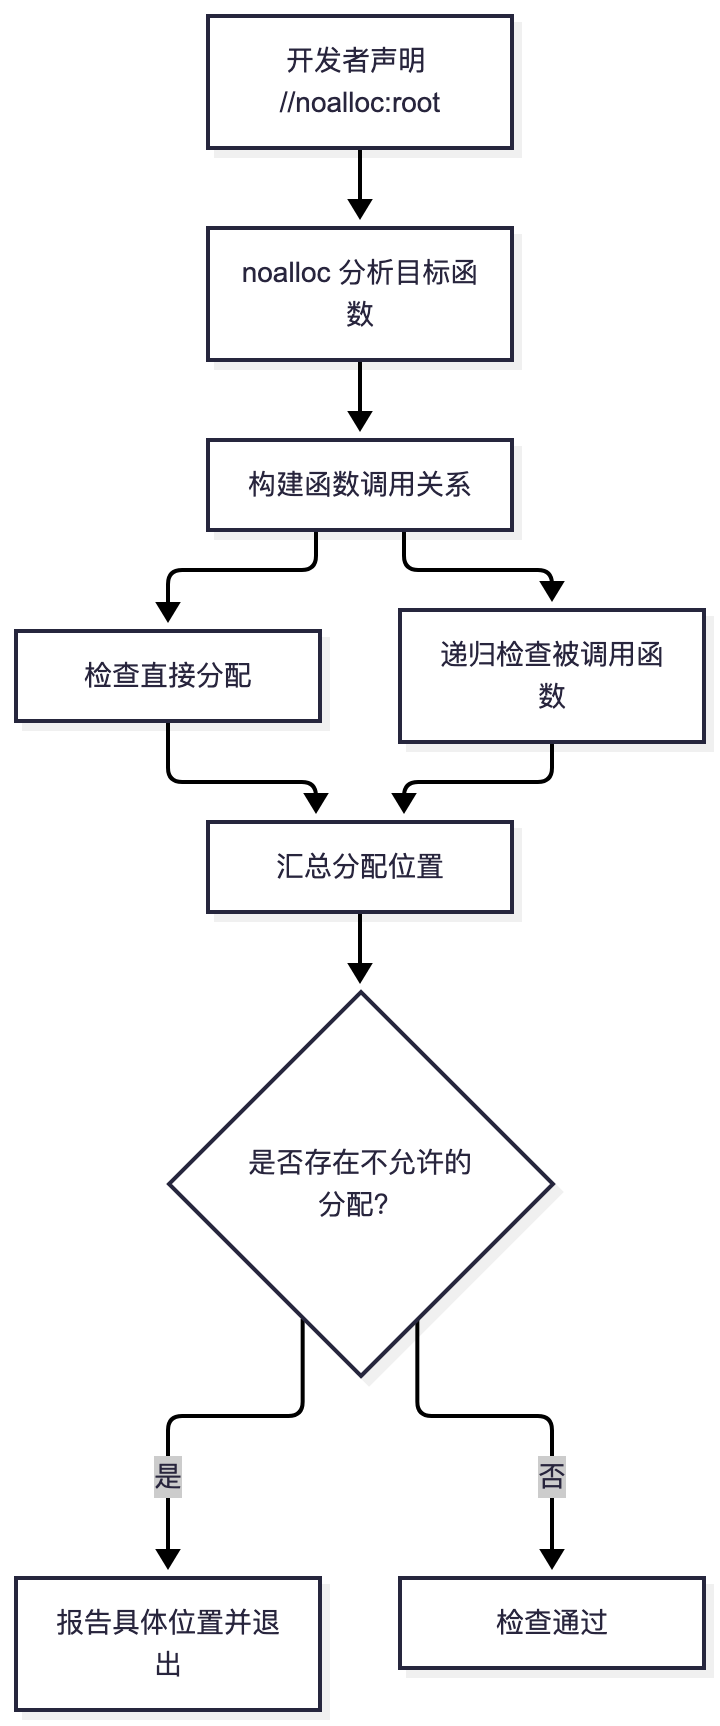
它支持几种重要的指令:
| 指令 | 作用 |
|---|---|
//noalloc:root |
检查当前函数及其调用链 |
//noalloc:exempt |
对特定代码行及其调用链设置例外 |
//noalloc:fixed |
声明类型的方法不会扩容其 slice |
//noalloc:append |
声明函数具有类似 append 的行为 |
其中,exempt 值得特别关注。
现实中的系统不一定能做到所有路径都零分配。例如,错误处理、日志记录等路径可能允许分配。
noalloc 允许开发者明确设置例外,同时保留例外对应的分配记录,避免性能约束变成一刀切。
它还可以分析模块外部的依赖,并检查其中的函数是否可能分配。
这意味着它关注的不是单个函数,而是一个完整的执行路径。
noalloc 不只是检查工具:bounded 内存管理库
如果 noalloc 只负责报告问题,它的价值还不算特别大。
真正让我感兴趣的是,它同时提供了一个名为 bounded 的库,试图让开发者更容易编写具有固定内存预算的代码。
它提供了四种核心数据结构:
Buf:固定容量的字节缓冲区。Vec:固定容量的泛型向量。Slice:支持分级容量扩展的连续切片。Map:固定容量的 Map。
这些容器有一个共同特点:容量耗尽时,不会像普通 slice 或 map 那样自动申请更多内存。
例如:
var v bounded.Vec[int]
v.Reset(make([]int, 0, 3))

for i := range 5 {
    v.Push(i * i)
}

fmt.Println(v.Items(), v.Full())
输出:
[0 1 4] true
当容量达到上限时,后续写入不会继续扩容,而是将容器标记为 Full。
这种设计看起来有些反直觉,但它非常重要。
在传统 Go 编程中,我们经常使用 append,让容器根据需要自动扩容。
而在资源受限的场景中,自动扩容恰恰可能是一个问题。
例如,一个网络服务同时处理 1000 个请求,如果每个请求都能无限制地扩大临时缓冲区,那么系统就很难建立可靠的内存预算。
bounded 的设计允许开发者明确规定:
- 单个请求最多使用多少临时内存。
- 某个缓冲区最多保存多少数据。
- 内存耗尽后应该返回错误、截断数据,还是切换到其他处理路径。
Region + Pool:为请求建立内存预算
bounded 还有一个值得关注的设计:Pool 和 Region。
Pool 负责管理固定数量的内存块,Region 则代表一次任务可以使用的内存预算。
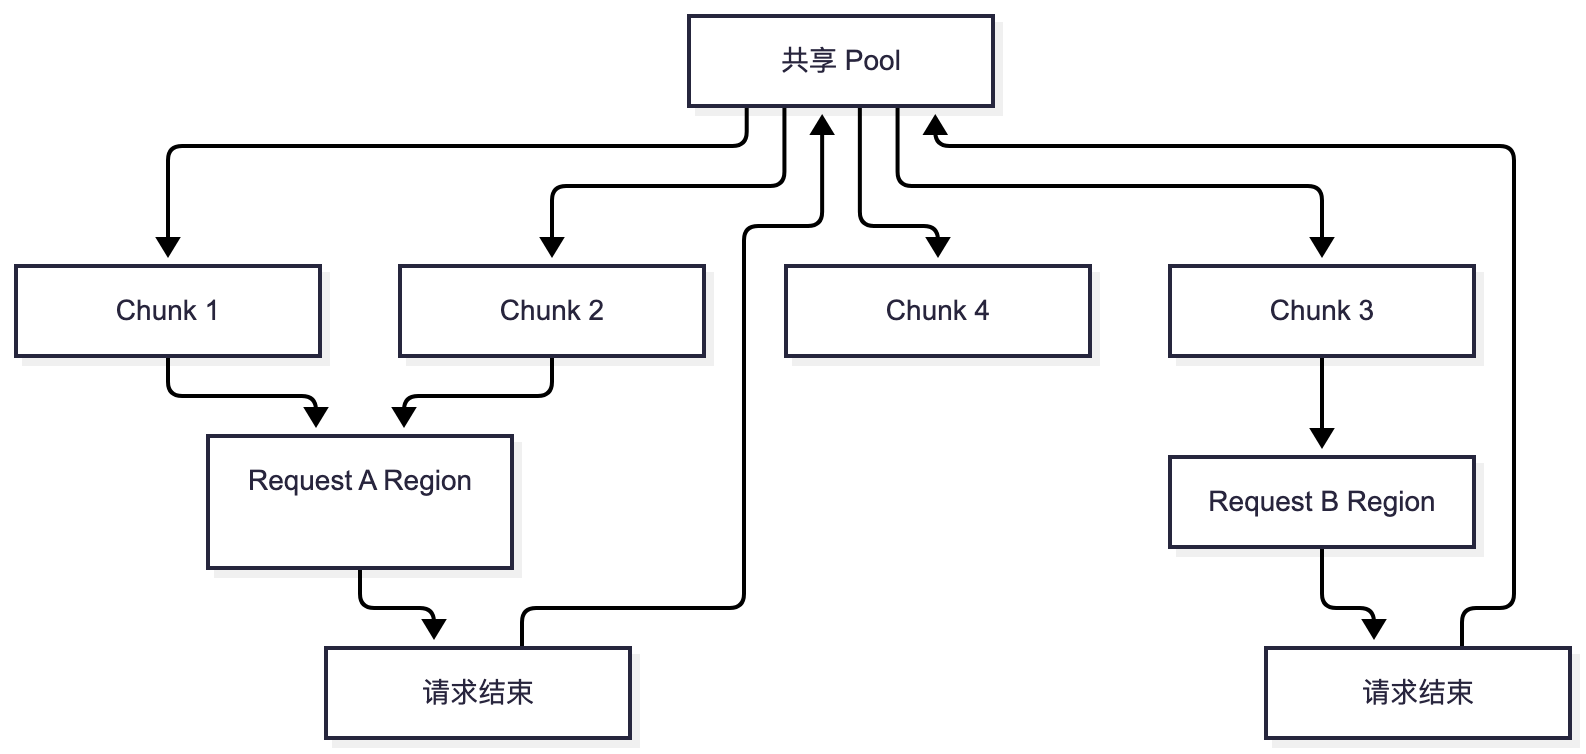
例如:
pool := bounded.NewPool[int](4, 8)

var r bounded.Region
r.Reset(2 * pool.ChunkBytes())
defer r.Release()

var v bounded.Vec[int]
v.ResetFrom(&r, pool)

for i := range 10 {
    v.Push(i)
}

fmt.Println(v.Len(), v.Full(), v.At(6))
输出:
8 true 6
这里,Pool 最多管理 8 个 chunk,每个 chunk 可以容纳 4 个 int。
当前 Region 的预算只允许借用两个 chunk,因此即使继续写入,也不会突破预算。
请求结束时,Release 将借用的 chunk 归还给 Pool,供其他请求复用。
这其实是一种非常实用的设计:把不可预测的动态内存需求,转换为有上限、可复用、可管理的资源预算。
尤其是在 HTTP 服务、协议解析、数据处理等场景中,这种模型具有现实意义。
一个可以运行的例子:让 noalloc 找出隐藏的堆分配
下面通过一个完整示例,看看 noalloc 如何发现 Go 代码中的隐性分配。
我们模拟一个简单的计数器服务。
项目目录:
noalloc-demo/
├── go.mod
└── main.go
go.mod:
module example.com/noalloc-demo

go 1.27.3
main.go:
package main

import (
    "fmt"
    "strconv"
)

type Counter struct {
    counts map[string]int
}

func NewCounter() *Counter {
    return &Counter{
        counts: make(map[string]int),
    }
}

//noalloc:root
func (c *Counter) Add(name string, n int) string {
    c.counts[name] += n
    return name + "=" + strconv.Itoa(c.counts[name])
}

func main() {
    c := NewCounter()

    fmt.Println(c.Add("requests", 10))
    fmt.Println(c.Add("requests", 5))
}
首先安装 noalloc:
go install github.com/theconsensuslabs/noalloc/cmd/noalloc@latest
注意:当前 noalloc 项目 README 要求 Go 1.27 或更高版本。
运行:
$go run .
输出:
requests=10
requests=15
从功能上看,这段代码完全正常。
但现在运行:
$noalloc
main.go:20: (*example.com/noalloc-demo.Counter).Add: map write
main.go:21: (*example.com/noalloc-demo.Counter).Add: calls strconv.Itoa; string concatenation; escapes: name + "=" + ~r0 escapes to heap
noalloc 会发现 Add 中存在两类分配风险:
- map 写入可能需要分配新的桶或扩容。
- 字符串格式化及拼接会产生堆分配。
这说明一个很重要的问题:代码运行正确,不代表它满足零堆分配的性能约束。
如果我们把这个检查放进 CI,那么后续有人修改 Add,即使没有改变函数签名,也可能因为引入新的堆分配而导致检查失败。
这就是 noalloc 与传统 benchmark 的一个重要区别。
Benchmark 告诉你某个版本的性能表现;noalloc 则尝试将内存分配约束持续应用于代码演进过程。
它到底有多快?项目给出的性能数据
noalloc 不仅有静态分析工具,还提供了自己的零分配 JSON 编解码实现。
项目 README 给出了一组值得关注的对比数据。
项目作者的测试环境是 Apple M4、10 核 CPU、Go 1.27.0。
测试对象包括:
- 一个约 130 KB、包含 500 个条目的 Feed。
- 一个类似 Session Cookie 的小对象。
- 编码和解码均采用各库文档中最快的使用方式。
其中,Feed 解码的分配次数和耗时如下:
| JSON 库 | Feed 解码耗时 | 分配次数 |
|---|---|---|
| goccy/go-json | 0.74 秒 | 4 |
| noalloc jsongen | 1.16 秒 | 0 |
| go-faster/jx | 1.54 秒 | 3500 |
| easyjson | 1.77 秒 | 4001 |
| sonic | 1.04 秒 | 3 |
| encoding/json | 2.94 秒 | 1696 |
这里有一个非常值得注意的现象:零分配不等于最快。
noalloc 的 JSON 解码确实实现了零次分配,但在这组测试中,速度仍然落后于 goccy/go-json 和 sonic。
它的价值在于提供了一个不同的优化维度:在接受一定 CPU 开销的前提下,尽可能减少堆分配。
另外,这组数据是项目作者自己公布的实验结果,不是独立第三方基准测试。不同硬件、输入规模、数据结构和使用方式都可能改变结果。
noalloc 的局限:零分配不是银弹
这个项目很有意思,但如果要在真实工程中使用,仍然有几个问题需要认真考虑。
静态分析不等于数学意义上的绝对证明
noalloc 会解析 Go 编译器的逃逸分析输出,并分析函数调用关系。
但它也有无法完全追踪的情况,例如:
- 通过函数值进行的动态调用。
- 部分汇编函数中的间接调用。
- 无法确定具体实现的接口调用。
对于无法追踪的调用,noalloc 通常采取保守策略,将其视为可能分配。
另外,它信任 allowlist、//noalloc:fixed 和开发者声明的例外,并不会自动证明这些声明一定正确。
因此,它更适合被理解为一种严格的静态检查工具,而不是形式化验证系统。
依赖 Go 编译器版本
项目通过解析:
go build -gcflags=-m
获得逃逸分析信息。
但编译器输出并不是稳定的机器接口,Go 版本升级可能改变输出格式和优化行为。
因此,项目建议固定 Go 工具链版本,并在升级后重新运行检查。
零堆分配不等于零内存管理成本
即使某个函数没有堆分配,它仍然可能:
- 操作已有内存。
- 发生锁竞争。
- 访问共享 Pool。
- 产生 CPU 缓存失效。
- 消耗大量栈空间。
例如,bounded 的 Pool 在借出和归还 chunk 时需要加锁。如果每处理一个元素就借还一次,反而可能增加开销。
固定容量意味着必须设计溢出策略
普通 Go 容器可以自动扩容,而 bounded 容器在容量耗尽时必须由业务决定下一步。
这意味着开发者需要处理:
- 输入过大。
- 缓冲区耗尽。
- Pool 资源不足。
- 并发请求之间的资源竞争。
- Region 释放后的内存访问。
尤其需要注意:Region 不是 goroutine-safe 的,不能在多个 goroutine 之间随意共享。释放 Region 后继续访问借用的数据,也可能产生错误甚至数据竞争。
零分配不是免费的,它要求开发者承担更多明确的资源管理责任。
小结:Go 的内存管理,正在走向新的平衡
回过头来看,Go 对内存管理的探索可以分成几个不同层次:
| 技术 | 核心思路 | 解决的问题 |
|---|---|---|
| 逃逸分析 | 编译器决定栈或堆 | 消除不必要的堆分配 |
| sync.Pool | 复用对象 | 降低重复分配 |
| Arena | 显式批量分配和释放 | 管理具有相似生命周期的对象 |
| Memory Regions | 隐式识别作用域内存 | 提高内存复用与 API 组合性 |
| noalloc | 静态检查整个调用链 | 持续约束堆分配 |
这些技术并不是互相替代的关系。
逃逸分析是编译器优化;Arena 和 Region 关注对象生命周期;noalloc 则关注工程约束。
我认为,noalloc 最值得关注的地方,是它让 Go 开发者有机会把性能要求从一句口头约定,变成 CI 中可以执行的规则。
过去,我们经常说:
“这个函数是热路径,不要在里面分配内存。”
现在可以进一步变成:
“这个函数必须零堆分配,任何修改都必须通过自动检查。”
当然,大多数 Go 应用并不需要追求全局零分配。GC 本身就是 Go 生产力的重要来源,盲目追求零分配可能让代码变得复杂,甚至降低整体性能。
但对于网络协议处理、序列化、数据库引擎、低延迟服务以及资源受限的系统而言,能够精确地约束少数关键路径,显然是一种很有价值的能力。
Go 不一定需要变成 Rust,但 Go 开发者确实需要更多工具,来精确控制那些不希望发生的事情。
noalloc 还很年轻,甚至项目作者也明确说明,整个仓库主要由 AI 编写,仍处于实验阶段。但它提出的问题值得整个 Go 社区认真思考:
当自动垃圾回收已经足够成熟,我们是否也应该拥有一种工程化的能力,来保证关键代码不再产生不必要的垃圾?
这或许是 Go 性能工程下一阶段值得探索的方向。
参考资料:
- noalloc 项目:https://github.com/theconsensuslabs/noalloc
- Hacker News 关于 noalloc 项目的讨论:https://news.ycombinator.com/item?id=50278645
- Go Arena 提案:https://github.com/golang/go/issues/51317
- Go Memory Regions 讨论:https://github.com/golang/go/discussions/70257
- A Guide to the Go Garbage Collector:https://go.dev/doc/gc-guide
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。