本文永久链接 – https://tonybai.com/2026/10/09/ts-rust-ai-ported-typescript-compiler
大家好,我是Tony Bai。
【导读】
一个人,一个 AI 智能体,一份不读的代码。Theo 刚刚在 X 上扔下一枚“炸弹”:用 Rust 重写 TypeScript 编译器、类型检查器和 LSP,全程让智能体干活,自己“一行代码没看”。同一个任务,OpenAI 模型烧了 40 万美元仍卡在 84%,Opus 5.5 只用 2 周、约 2.4 万美元就把事办成。帖子 24 小时内破 52 万浏览,评论区从“So sick”吵到“谁来维护”。这个可能没人维护的项目,到底证明了什么?
【文章要点】
- 事件:开发者 Theo 发布 tsc-rs,Rust 编写,兼容 tsc 命令行、语言服务器与 API,MIT 协议,npm 可装。
- 数据:六个真实项目上几何平均比 tsc 6 快 11.4 倍,比 tsc 7(Go 版)快 1.61 倍;但 Bun 新发布的
bun check更快,约 20.9 倍。 - 成本:OpenAI 路线超过 40 万美元,1.3M 行 Rust,卡在约 84% 兼容;Opus 5.5 路线约 2.4 万美元,2 周,10 小时出可运行的 v0。
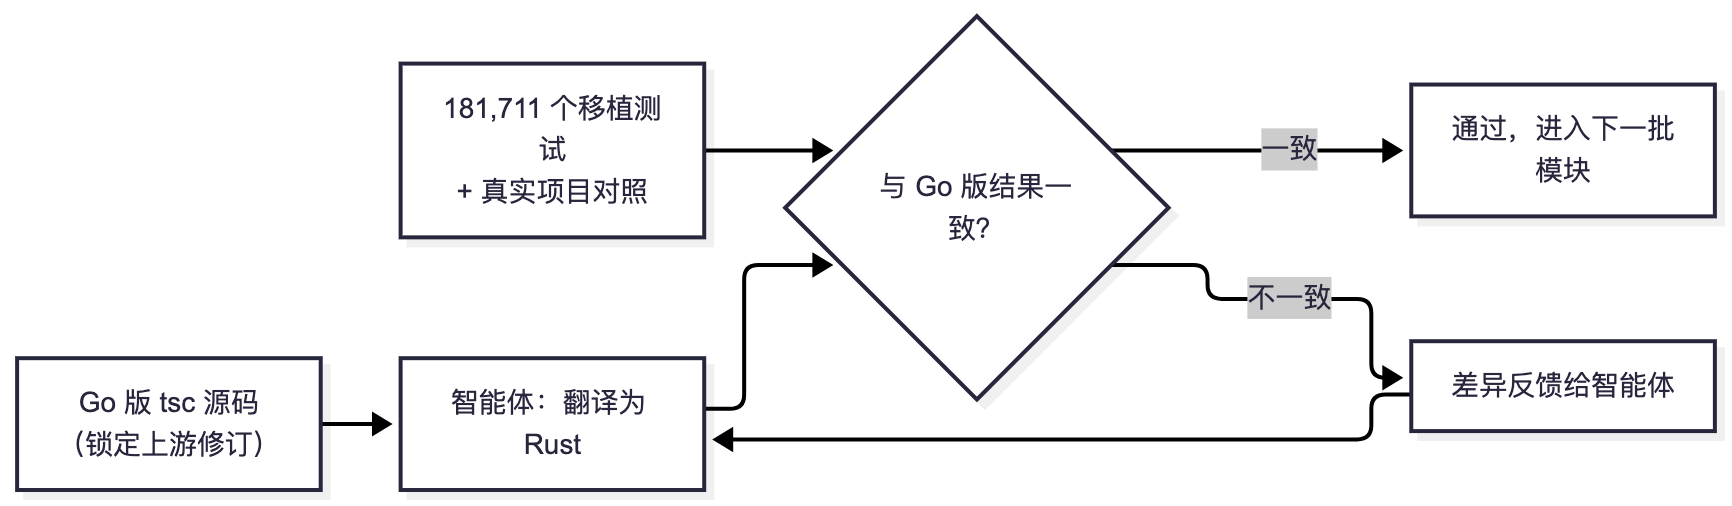
- 本质:它不是“从零发明”,而是对 Go 版 tsc 的直接移植,背后有 181,711 个移植过来的测试做“标准答案”。
- 争议:没人读过代码、是否会被维护、Go 的并发模型被原样搬进 Rust、仍有已知问题。
- 意义:当任务有明确的“判分器”,AI 智能体已经能完成工业级编译器的移植;瓶颈正在从“写代码”转向“定义验证”和“长期维护”。

开篇:一行代码没看,却造出了编译器
2026 年 10 月 7 日晚上 7 点 07 分,开发者 Theo(@theo,T3 Chat、T3 Code 的创始人)发了一条帖子:
宣布 tsc-rs(又名 ts-rust),我对 TypeScript 编译器、类型检查器和 LSP 的完整 Rust 重写。
紧接着是三句让整个开发者圈子坐不住的话:
- 这个项目,他让智能体干了 5 个月;
- 烧了约 40 万美元的 Codex 令牌,一无所获;
- 换成约 2 万美元的 Opus,2 周就做成了。
最后一句更狠:“我一行代码都没读过。”
截至截图时,这条帖子已有 52.7 万次浏览、5100 个赞、1400 次收藏、377 次转发、329 条回复。
热闹是热闹,但热闹背后有三个问题值得认真回答:
- 它到底有多快?数据站得住吗?
- 同一个任务,为什么两条路线的结果差了一个数量级?
- 一个“没人读过代码”的项目,究竟证明了什么?
这篇文章就按这三个问题展开。
刚刚发生了什么
先把事实摆清楚。
tsc-rs(仓库名 ts-rust)是 pingdotgg 组织下的开源项目,MIT 协议,定位是“TypeScript 7 编译器(tsc)的实验性 Rust 移植版”。它包含编译器、类型检查器和语言服务器,命令行参数与 tsc 保持一致。
安装方式很简单:
npm install -D tsc-rs
npx tsc-rs -p tsconfig.json
目前提供 Linux x64 和 macOS arm64 两个平台,Windows 和 Linux arm64 暂未支持。
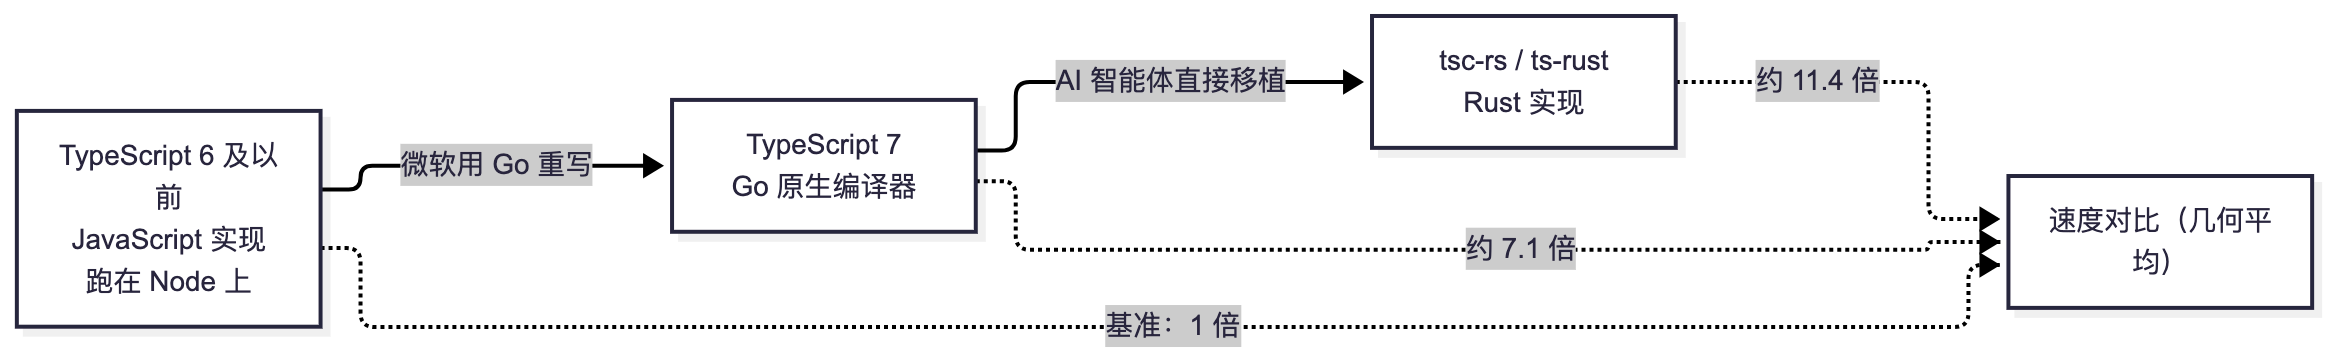
这里需要先澄清一个容易被标题带偏的细节:Theo 在推文里说的是“完整重写”,但仓库 README 写得很清楚,ts-rust 是对微软原生 TypeScript 编译器(Go 实现)的直接移植,保留了 Go 版的算法和行为,同样提供 tsc 命令行、语言服务器和 API。
也就是说,这条路径是:
作者在 README 里坦率列出了做这个项目的动机:测试模型能力、做一个快的 TypeScript 类型检查器、做一个能在 WASM 里高性能运行的检查器,以及——“整活”。
成绩单:到底有多快
1. 六个真实项目的基准测试
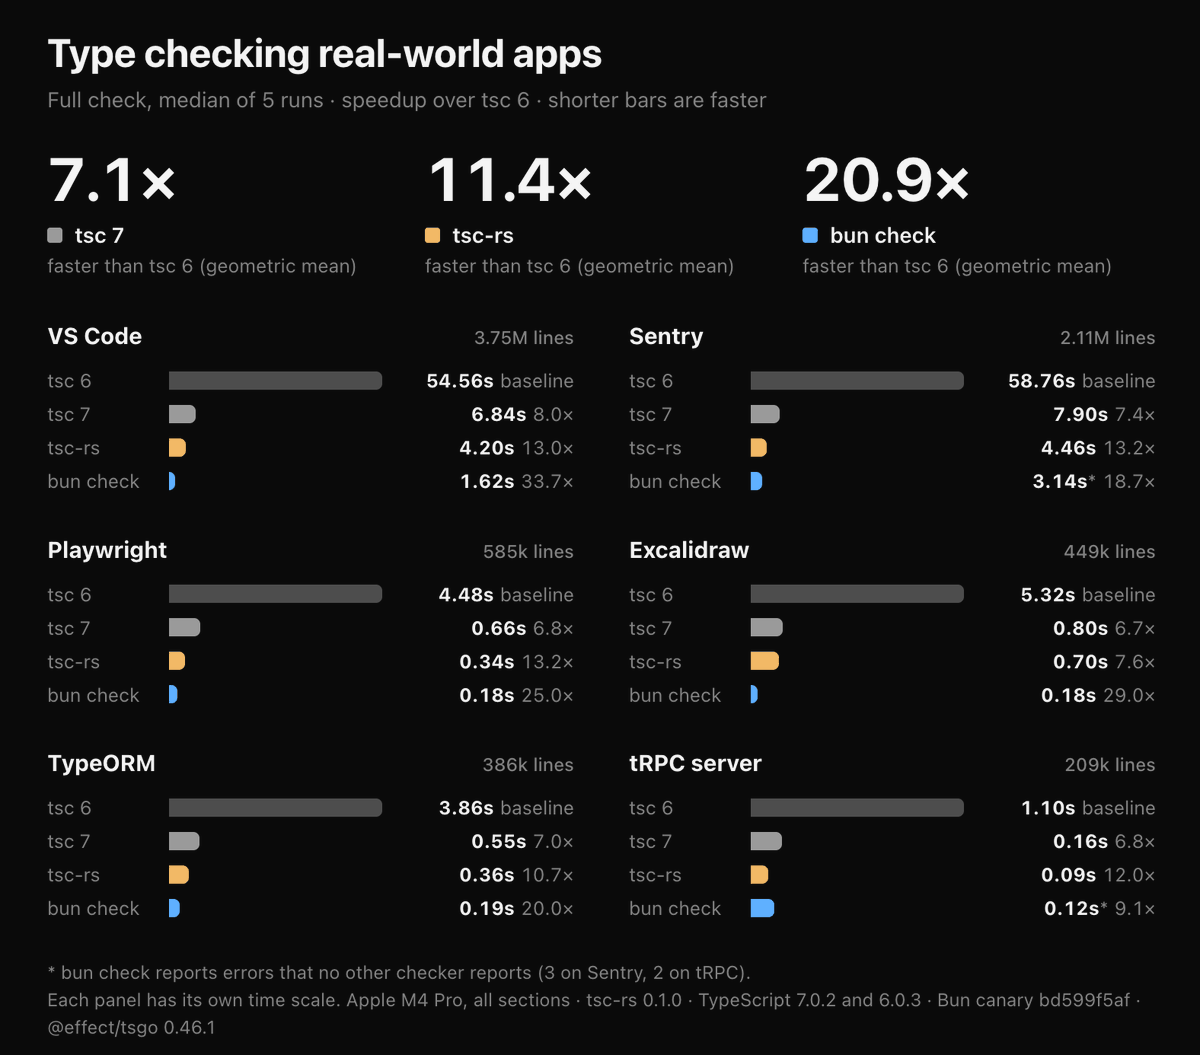
作者选了六个开源项目做完整类型检查,每个跑 5 次取中位数,机器是 Apple M4 Pro(12 核 48GB):
| 项目 | 代码行数 | tsc 6 | tsc 7(Go) | tsc-rs | bun check |
|---|---|---|---|---|---|
| VS Code | 375 万 | 54.56 秒 | 6.84 秒(8.0 倍) | 4.20 秒(13.0 倍) | 1.62 秒(33.7 倍) |
| Sentry(前端) | 211 万 | 58.76 秒 | 7.90 秒(7.4 倍) | 4.46 秒(13.2 倍) | 3.14 秒(18.7 倍)* |
| Playwright | 58.5 万 | 4.48 秒 | 0.66 秒(6.8 倍) | 0.34 秒(13.2 倍) | 0.18 秒(25.0 倍) |
| Excalidraw | 44.9 万 | 5.32 秒 | 0.80 秒(6.7 倍) | 0.70 秒(7.6 倍) | 0.18 秒(29.0 倍) |
| TypeORM | 38.6 万 | 3.86 秒 | 0.55 秒(7.0 倍) | 0.36 秒(10.7 倍) | 0.19 秒(20.0 倍) |
| tRPC(server) | 20.9 万 | 1.10 秒 | 0.16 秒(6.8 倍) | 0.09 秒(12.0 倍) | 0.12 秒(9.1 倍)* |
| 几何平均 | 7.1 倍 | 11.4 倍 | 20.9 倍 |
标 * 的数据:bun check 报出了其他检查器都没有报出的错误(Sentry 上 3 个,tRPC 上 2 个)。
几个关键结论:
- tsc-rs 比 tsc 6 快约 11.4 倍,比微软的 Go 版 tsc 7 快约 1.61 倍;
- 在作者用 60 个开源项目做的另一轮测试中,tsc-rs 的类型检查耗时约为 Go 版的一半;
- 值得注意:Bun 刚发布的
bun check更快,几何平均达到 20.9 倍,比 tsc 7 快约 2.95 倍。
Theo 在帖子里对此毫不回避:他写了一句“Full transparency(完全透明)”,说明 bun check 同时发布,Jarred 很早就把数字分享给了他,而且“非常惊艳”。
2. 加上 Effect 诊断之后
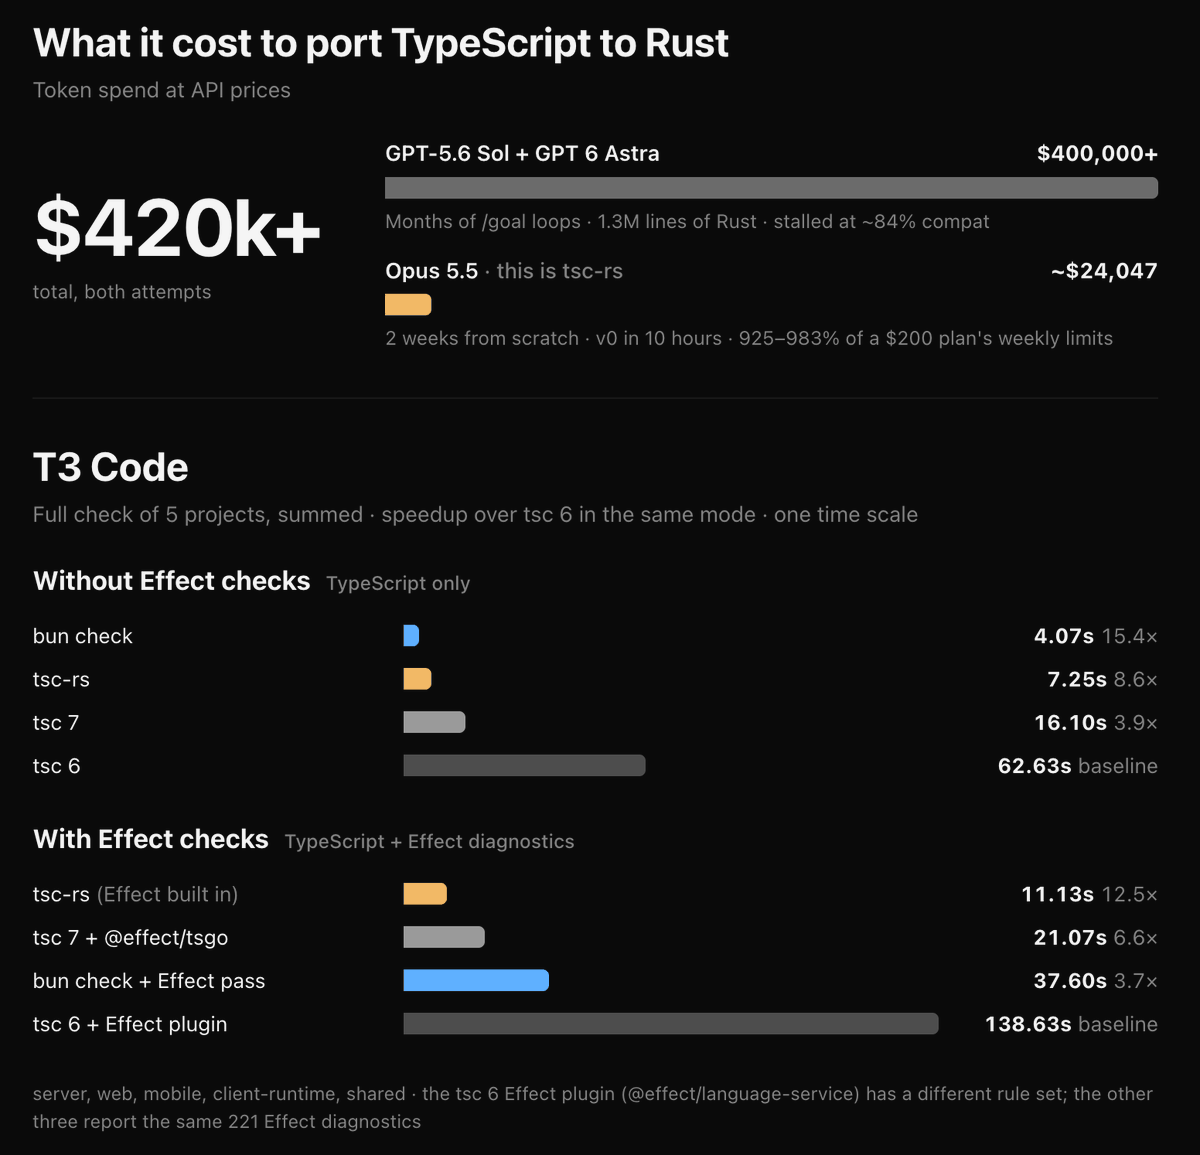
T3 Code 使用了 Effect 生态,因此作者还测了“带 Effect 诊断”的场景。tsc-rs 把 Effect 语言服务诊断(错误码 377xxx)内置了进去,一次检查同时得到 TypeScript 与 Effect 的诊断:
| 检查方案 | 耗时 | 相对 tsc 6 |
|---|---|---|
| tsc-rs(内置 Effect) | 11.13 秒 | 12.5 倍 |
| tsc 7 + @effect/tsgo | 21.07 秒 | 6.6 倍 |
| bun check + Effect 诊断(两遍) | 37.60 秒 | 3.7 倍 |
| tsc 6 + Effect 插件 | 138.63 秒 | 基准 |
在这个场景里,tsc-rs 比 tsc 7 方案快约 1.89 倍,而且不需要第二遍。
40 万美元 vs 2.4 万美元:同一个任务,两种结局
这是整件事里最具戏剧性的部分。
根据作者在 README 和推文里给出的数字:
- OpenAI 路线:GPT-5.6 Sol 加 GPT 6 Astra,按 API 价格花了超过 40 万美元,写出 130 万行 Rust,历经数月的
/goal循环,始终没能超过约 84% 的兼容率; - Opus 5.5 路线:10 小时得到可运行的 v0,总共约 24,047 美元,历时 2 周。
作者还特意提到一个细节:他原以为 Opus 会沿用之前 Codex 模型写的代码,结果不是,它从零开始,却用了十分之一的时间走得比前者更远。
另外,作者用的是 Claude 订阅账号,消耗量折算下来是 200 美元套餐每周额度的 925% 到 983%。
但我们要冷静地看这组对比。
这是一个人、一个任务、一次实验,样本量为 1。两条路线用的是不同的工具链(/goal 循环对 Claude Code)、不同的提示和不同的时间点,模型之外的变量非常多。把它理解为“某个具体的智能体工作流在某个具体任务上的一次结果”会比理解为“哪家模型碾压哪家”更稳妥。
不过,即便打个折扣,“成本相差一个数量级、结果相差一个层级”仍然是值得记住的信号:在长程、高复杂度的工程任务上,不同模型和工作流之间的差距,可能比榜单分数显示的更大。
这不是“发明”,而是“带答案的翻译”
为什么这件事能做成?看一眼 README 就能找到关键线索。
1. 它有一份标准答案
tsc-rs 是对 Go 版编译器的逐行为移植,仓库把上游版本固定在某个修订上,然后与 Go 版逐项对照。官方给出的状态如下:
- 181,711 个从 Go 版移植来的测试全部通过;
- 语言服务器和 API 的回答,在“oracle 测试集”上与 Go 版一致;
- 在 TanStack Query core 和 Hono 上,诊断结果与 Go 版完全相同;
- 在 120 个开源仓库上,命令行输出与 Go 版的差异,仅限于已知问题,以及 Go 版自己多次运行结果就不一致的地方。
换句话说,智能体不是在凭空猜测“TypeScript 应该怎样检查类型”,而是在对着一份可执行的、能自动判分的标准答案做翻译。
2. 这也解释了为什么 OpenAI 路线卡在了 84%
我们没有看到那条路线的过程数据,不好下结论。但一个合理的推测是:最后的 16% 往往是最难的,边角行为、诊断文本、错误恢复、并发下的顺序一致性,这些都需要长时间保持上下文一致才能完成。这类长程任务,恰恰是智能体最容易“越改越偏”的地方。
3. 带着 Go 味道的 Rust
评论区里有一条很有意思的吐槽:这是个“很奇怪的移植”,他想知道“是哪个模型决定把 goroutine 也移植过来”。
这其实正是“直接移植”的副作用:README 明确说它保留了 Go 版的算法和行为,因此在代码风格、并发模型上带有明显的 Go 印记,而不是一份“地道的 Rust”。另一位开发者翻看仓库后也提到,里面还留着十几处 unported! 标记,以及 Go 的标记没有清理干净,不过他同时认为“乍看之下相当扎实”,并觉得后续重构会很有意思。
这是一个关键判断点: 它是“能跑、能对上答案”的工程成果,而不是“被人精心设计、可读可维护”的工程成果。这两件事,是两种完全不同的交付物。
评论区炸锅:五种声音
帖子下面的讨论,大致可以分成五类:
惊叹派:一位开发者的一句“So sick”,Addy Osmani 一句“This is awesome”。
质疑派:有人调侃 Theo 的“没读过一行代码”声明,也有人对“我的重写”这个说法不以为然,一句“Bro really said ‘my’”拿到了 50 多个赞。还有开发者说得更直接:“想不出这个项目会让谁受益。”
维护派:Batuhan Cakir 的一句“Will it be maintained at all?”拿到了 100 多个赞,是整个评论区点赞最多的问题之一。另一位开发者 Demjan 还给出了一个很扎心的解读:这有点像在 YouTube 视频下面抢“第一”,没人能抢走这个“我做到了”的名分。
竞品派:Max Schwenk 贴出了自己的 Rust 项目 tsrs,称比 Bun 快 1.5 到 2 倍,内存占用也更小;另一位开发者引用了 C++ 移植版 TS 6 的消息,声称已经达到 100% 对等,速度快 25 到 750 倍。需要说明的是,这些都是各自作者的自述,本文没有独立验证。
期待派:有人希望看到一份详细视频,讲清楚到底怎么指挥智能体干活。还有来自 swc 社区的开发者认为,这对 WASM 插件的类型支持可能有帮助。Theo 回复说,WASM 支持正是他想做这件事的重要原因之一,他“仍然梦想着在 V8 isolate 里完成端到端开发”。
至于有人追问“怎么确认和 tsc 在奇怪的边界情况上行为一致”,Theo 的回答是:官方一致性测试、自己的测试集,再加上在超复杂的真实项目上跑。
冷静一下:它还有哪些问题
这个项目的 README 写得相当坦诚。它自己标明这是早期版本,还不是所有项目里 tsc 的完整替代品。已知问题包括:
- 在一些 monorepo 里,工作区包的源文件可能同时通过
node_modules和直接导入被访问,此时 tsc-rs 可能比tsc多输出一些文件; - 在
tsc -b下,当一个项目在没有项目引用的情况下导入另一个项目的输出时,tsc-rs 可能报 TS2307(找不到模块); tsc -b --watch在某些编辑之后可能以内部错误(退出码 70)停止;- 编辑器里长时间编辑,内存会缓慢增长;
tsc-rs --version打印的是它所移植的 TypeScript 版本(7.1.0-dev),而不是 npm 版本。
再加上几点“不在 README 里,但值得注意”的事实:
- 平台覆盖有限:目前仅 Linux x64 与 macOS arm64;
- 没有人读过代码:这既是噱头,也是风险点。性能与正确性可以靠测试验证,但安全性、可维护性和长期演进,很难靠测试覆盖;
- 维护状态不明:仓库有 5800 多次提交,说明开发很密集,但“会不会持续维护”这个问题,作者并没有给出承诺。
所以,如果你想在生产环境里用它,更稳妥的做法是:先在 CI 里并行跑一遍,与现有 tsc 的结果对照,再决定是否切换。
它到底证明了什么
即便这个项目明天就停更,它依然证明了几件事。
1. 有“判分器”的任务,智能体已经可以做到工业级。
编译器是公认的复杂系统,类型检查器更是其中的“深水区”。而这件事被智能体在 2 周里做到了与 Go 版结果一致的程度,前提是——它有一份可以自动比对的标准答案。验证能力,正在变成这类任务里最稀缺的资源。
2. 模型之间的差距,在长程任务上被放大了。
同一个任务,一条路线 5 个月、40 万美元停在 84%,另一条路线 2 周、2.4 万美元完成。虽然是单次实验,但这种量级的差距,已经足以让每个团队重新评估自己的模型选型与工作流。
3. “写代码”不再是瓶颈,“定义问题”和“验收”才是。
Theo 在做的事情,本质上是:选一个目标、搭起验证闭环、让智能体持续跑。他自己没有读代码,却能确认它“对”,靠的是测试、基准和真实项目。
4. 成本曲线被重新定义。
README 里有一句话:花了超过 42 万美元,但“大概只需要 2 万美元左右就能做到”。对比一个事实——微软做 Go 版 tsc 投入了一个团队、相当长的时间——哪怕考虑到这次有现成的参照,这个成本数量级的变化也不容忽视。
5. 它同时带来了新问题:谁对这份代码负责?
没有人读过的代码、没有明确维护计划的项目,一旦被放进真实的工程链路,出了问题谁来修,谁来背书?这是 AI 时代开源生态必须面对的新课题。有趣的是,评论区里已经有人贴出了类似的“AI 移植”项目,比如把 Lua 5.1 用 Rust 重写的 Rulua,这说明“用智能体做大型移植”正在成为一种新的开源现象。
小结:不管它活多久,这扇门已经打开了
Theo 在帖子的最后写道:
去试试,告诉我它坏成什么样。AI 太不可思议了。晚安,书呆子们。
这种半开玩笑的口吻,其实藏着一个很清醒的事实:这个项目可能不会长期被维护,但它已经回答了一个很多人心里的问题——“智能体能不能啃下编译器这种硬骨头?”
答案是:在有标准答案、有验证闭环、有足够预算的前提下,能。
接下来真正值得讨论的,是另外三件事:怎么设计验证闭环,怎么选择模型与工作流,以及——当代码越来越多地由智能体写出来、由测试而不是人来背书时,我们该如何建立新的信任机制。
提醒一句:作者自己也说了,“我不知道它能不能用”。建议先在测试分支或 CI 的并行任务里体验,并把结果与现有 tsc 对照。
参考资料
- Theo 的原始推文:https://x.com/theo/status/2107789940482621795
- 项目仓库:https://github.com/pingdotgg/ts-rust
- 讨论话题:https://x.com/i/trending/2107805546195669349
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。