本文永久链接 – https://tonybai.com/2026/10/04/rust-named-arguments-ai-agents-debate
大家好,我是Tony Bai。
【导读】
《Rust 程序设计语言》(俗称“The Book”)作者 Steve Klabnik,十年来一直是 Rust 引入命名参数、可选参数、默认参数这类“魔法特性”的坚定反对者。但就在几天前,他突然松口了——理由却不是人类程序员的需求变了,而是 AI coding agent。这篇文章很快引来另一位 Rust 圈老兵、咨询公司 Corrode 创始人 Matthias Endler 的强势回应:根本不用改语言,Rust 现在就能做到八成,而且更好。一场关于“函数到底该怎么传参”的十年论战,因为 AI 有了新的走向。
【文章要点】
- 十年立场的罕见松动:《Rust 程序设计语言》官方作者 Steve Klabnik 改变了坚持十年的反对立场,首次松口支持“命名参数”,核心理由是 AI Coding Agent 的普及消除了多打字的成本,且显式参数名能降低人类和 AI 的上下文查阅开销;
- 坚决拒绝默认/可选参数:Klabnik 明确将“命名参数”与“可选/默认参数”解耦,坚决反对后两者,认为信息隐藏和调用约定的随意性会破坏语言简洁性;
- 来自产业界的硬核反驳:Corrode 创始人 Matthias Endler 提出“家里本就有命名参数”,指出动态语言将语义塞进“函数调用语法”,而 Rust 的一贯哲学是将语义外置给“类型系统”;
- 已有机制的完美平替:通过 Struct 打包、Option + Default 结构体更新语法、枚举多态与 Builder 模式,Rust 现存语法早已能以零运行时开销、类型安全的方式解决 80% 的参数传递痛点;
- AI 时代的深层分歧:打字成本归零后,究竟该追求语法表层的省事,还是顺水推舟让 AI 编写带有完整语义身份的独立结构体?双方共识在于:不急于盲目扩充语言语法,更好的设计往往源自“更好的类型”。

一个吵了十二年的 GitHub issue
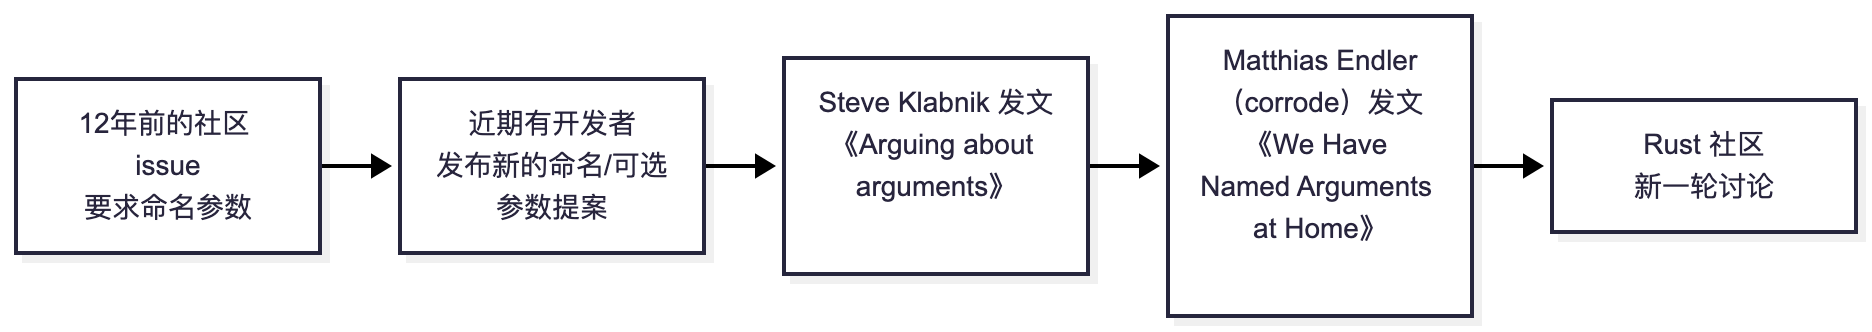
在编程语言的世界里,“要不要支持命名参数”是一个经典的老问题。Rust 社区里有一条讨论这件事的 GitHub issue,已经整整挂了 12 年,至今没有定论。
9 月 21 日,Rust 核心贡献者、《Rust 程序设计语言》官方教程的作者 Steve Klabnik 发文《Arguing about arguments》,重新翻出了这个话题。三天后,Rust 咨询公司 Corrode 的创始人 Matthias Endler(播客“Rust in production”的主持人)在自己的博客上写了一篇长文《We Have Named Arguments at Home》,逐条回应。
两篇文章加起来,几乎把“该不该给 Rust 加命名参数”这件事的正反方论据都讲透了,还顺带牵出了一个更有意思的问题:AI coding agent 的普及,到底会让编程语言变得更啰嗦,还是更简洁?
先扫个盲:命名参数、可选参数、默认参数、函数重载到底是什么
在往下讲之前,先用 Klabnik 文章里的例子把几个术语讲清楚,免得后面混着说。
Rust 里一个最普通的函数长这样:
fn foo(x: i32, y: i32) -> i32 {
    // 函数体略
}

let z = foo(5, 6);
在这里,x、y 叫“(形式)参数”(parameter),5、6 叫“实参”(argument)。Rust 目前在参数这件事上非常朴素,没有下面这几种“花活”:
命名参数(Named parameters):调用时可以显式写出参数名,甚至可以打乱顺序传参。
// 如果 Rust 支持命名参数
let z = foo(x: 5, y: 6);
let z = foo(y: 6, x: 5); // 顺序随意
可选参数 + 默认参数(Optional / Default arguments):某些参数可以不传,不传时使用预先声明好的默认值。Klabnik 举了 Ruby on Rails 里 redirect_to 的例子,这个函数可以用五六种完全不同的方式调用,非常灵活,但也非常“猜不透”:
redirect_to "http://www.rubyonrails.org"
redirect_to @post
redirect_to action: "show", id: 5
redirect_to post_url(@post), status: 301, flash: { updated_post_id: @post.id }
函数重载(Function overloading):允许用同一个名字定义多个签名不同的函数,调用时按传入的实参自动匹配。比如 Java:
void connect(String url, int timeout) { }
void connect(String url) { }
Klabnik 直言,他曾经是 Ruby 重度用户(他自嘲“身上有个 Ruby 纹身”),后来转向 Rust,恰恰是因为受够了 redirect_to 这种“看似优雅、实则难以捉摸”的 API:你几乎必须依赖良好的文档,才能知道一个函数到底能怎么调用。
Rust 目前的做法是:老老实实为不同用法写不同名字的函数。
let v = Vec::new();              // 空 vector
let v = Vec::with_capacity(5);   // 预分配容量的 vector
代价是要多想一个名字,好处是规则极简:一个函数只有一个定义,调用只有一种方式。
Klabnik 的十年坚持:不是不喜欢简洁,是怕“隐藏信息”
Klabnik 承认,命名参数、可选参数这些特性单独拿出来看确实很方便,尤其在传递像 status_code=200 这样的表达式时,命名能让调用点的语义一目了然。他用 Python 的 FastAPI 举了个不算夸张的例子:
@app.get(
    "/me",
    response_model=UserOut,
    status_code=200,
    tags=["Users"],
    summary="Get current user profile"
)
def get_current_user():
这个 get 方法实际上可以接受 23 个关键字参数。当调用方只想传五个的时候,命名参数 + 默认参数的组合确实省心。但当 FastAPI 内部要把这些参数原样转发给下一层函数时,画风就变了:
self.router.get(
    path,
    response_model=response_model,
    status_code=status_code,
    tags=tags,
    dependencies=dependencies,
    summary=summary,
    # ... 后面还有十几行 xxx=xxx
)
一堆 foo=foo 的重复赋值,啰嗦又冗余——这正是 Klabnik 十年来反对这套特性组合的核心理由:命名参数、可选参数、默认参数、函数重载,看似各自独立,实际高度纠缠,一旦你有了其中一个,几乎必然想要另外几个,最终整个语言的复杂度会像滚雪球一样越滚越大。对于一门本就被认为“上手门槛高”的语言来说,这种代价他觉得不值得。
转折点:当“打字的人”变成了 AI
但 Klabnik 这次明确表态:他对“命名参数”这一项,态度松动了——注意,只是这一项,可选参数和默认参数依然被他排除在外。
促成这次转变的,是他这段时间在写 Rue 语言 时,越来越多地借助 AI coding agent 写代码这件事。他举了 image crate 里的一个真实函数:
// 原始签名
pub fn crop_imm<I: GenericImageView>(
    image: &I,
    x: u32,
    y: u32,
    width: u32,
    height: u32,
) -> SubImage<&I> { /* ... */ }

// 调用
let cropped = image::imageops::crop_imm(&img, 10, 20, 200, 100);

// 如果 Rust 支持命名参数
let cropped = image::imageops::crop_imm(
    image: &img,
    x: 10,
    y: 20,
    width: 200,
    height: 100,
);
四个连续的 u32 摆在调用点,人类读起来确实要停下来数一数、猜一猜哪个是 x、哪个是 width。命名参数版本无疑更清晰。
Klabnik 过去之所以觉得“不值得”,是因为多打这些字的成本要由他自己承担。但现在,如果这段代码是 Claude Code 这样的编程 agent 写出来的,他就不在乎多敲那几十个字符了——而且他观察到,这种“啰嗦但清楚”的写法,对 AI agent 本身可能也更友好:agent 在读取调用点时,如果参数带着名字,就不必回头去查函数签名才能确认 10 到底对应哪个参数,理论上能减少一些来回查阅的 token 消耗和调用次数(他也坦承自己还没做过正式的评测)。
用他的话说,“对人类有利的东西,对 agent 往往也成立”。
不过,这个逻辑并不能延伸到可选参数和默认参数上——因为这两者的问题不是“打字多少”,而是“信息隐藏”:调用点上原本应该出现的东西,被悄悄省略了。当“打字的人”不再是自己,省字带来的收益消失了,但隐藏信息带来的代价还在,这笔账自然就划不来了。
他还特别提到,这个逻辑同样适用于 builder 模式——builder 既能模拟命名参数(好),也能模拟可选/默认/变长参数(不好),所以他一贯主张在 Rust 里谨慎使用 builder。
松口之后,麻烦才刚刚开始
即便觉得命名参数“在道理上说得通”,Klabnik 也很清楚,“这个特性好不好”和“这个特性该不该真的加进 Rust”完全是两回事。他在文章后半段列了一串真要落地时绕不开的语言设计难题:
第一,Rust 的参数本质上是模式(pattern),而不是名字。
fn foo((x, y): (i32, i32)) {
    // 这里的参数是一个模式,没有单独的"名字"
}
你需要额外发明一套“内部名字 vs 外部名字”的语法,复杂度立刻上升。
第二,函数变成值之后怎么办?
fn resize(width: u32, height: u32) { }
fn offset(dx: u32, dy: u32) { }

let f: fn(u32, u32) = if resizing { resize } else { offset };
f 的参数该叫什么名字?resize 和 offset 的参数名并不一样。更麻烦的是,Rust 现在其实允许这样写:
type Callback = fn(width: u32, height: u32);

fn f(g: Callback) {}
fn bar(x: u32, y: u32) {}

fn main() {
    f(bar); // 合法:bar 的参数名并不需要匹配 Callback 里写的名字
}
Callback 类型里的参数名目前纯粹是文档性质的,并不强制。如果命名参数成为正式特性,这里算不算错误?trait 方法的签名是不是也要面对同样的问题?
第三,求值顺序。
Rust 目前按从左到右的书写顺序求值参数:
fn consume(data: Vec<u8>, length: usize) { }

let data = vec![1, 2, 3];

consume(data, data.len());       // 编译错误:先移动后借用
consume(data.len(), data);       // 如果换个签名顺序,这样写就没问题
一旦允许命名参数打乱顺序传参,“按声明顺序求值”还是“按书写顺序求值”就成了两难:换个写法,同一个函数调用可能编译通过,也可能编译不通过,这种“薛定谔式”的行为相当危险。
第四,兼容性。
一旦参数名成为公开 API 的一部分,库作者以后想重命名参数就会破坏调用方代码——这几乎意味着又要发明一套“参数别名”机制。
Klabnik 自己也承认,这篇文章更像是一次“公开改变主意”的记录,而不是一份完整的语言提案。他甚至提到,社区里已经有开发者(botahamec)发了一份更正式的命名/可选参数提案,值得关注。
Corrode 的回应:“这些我们家里其实都有”
Klabnik 的文章发出三天后,Rust 咨询公司 Corrode 的创始人 Matthias Endler 写了一篇长文回应,标题很有梗——《We Have Named Arguments at Home》(我们家里有命名参数),致敬了那个“某某平价替代品”的经典网络梗。
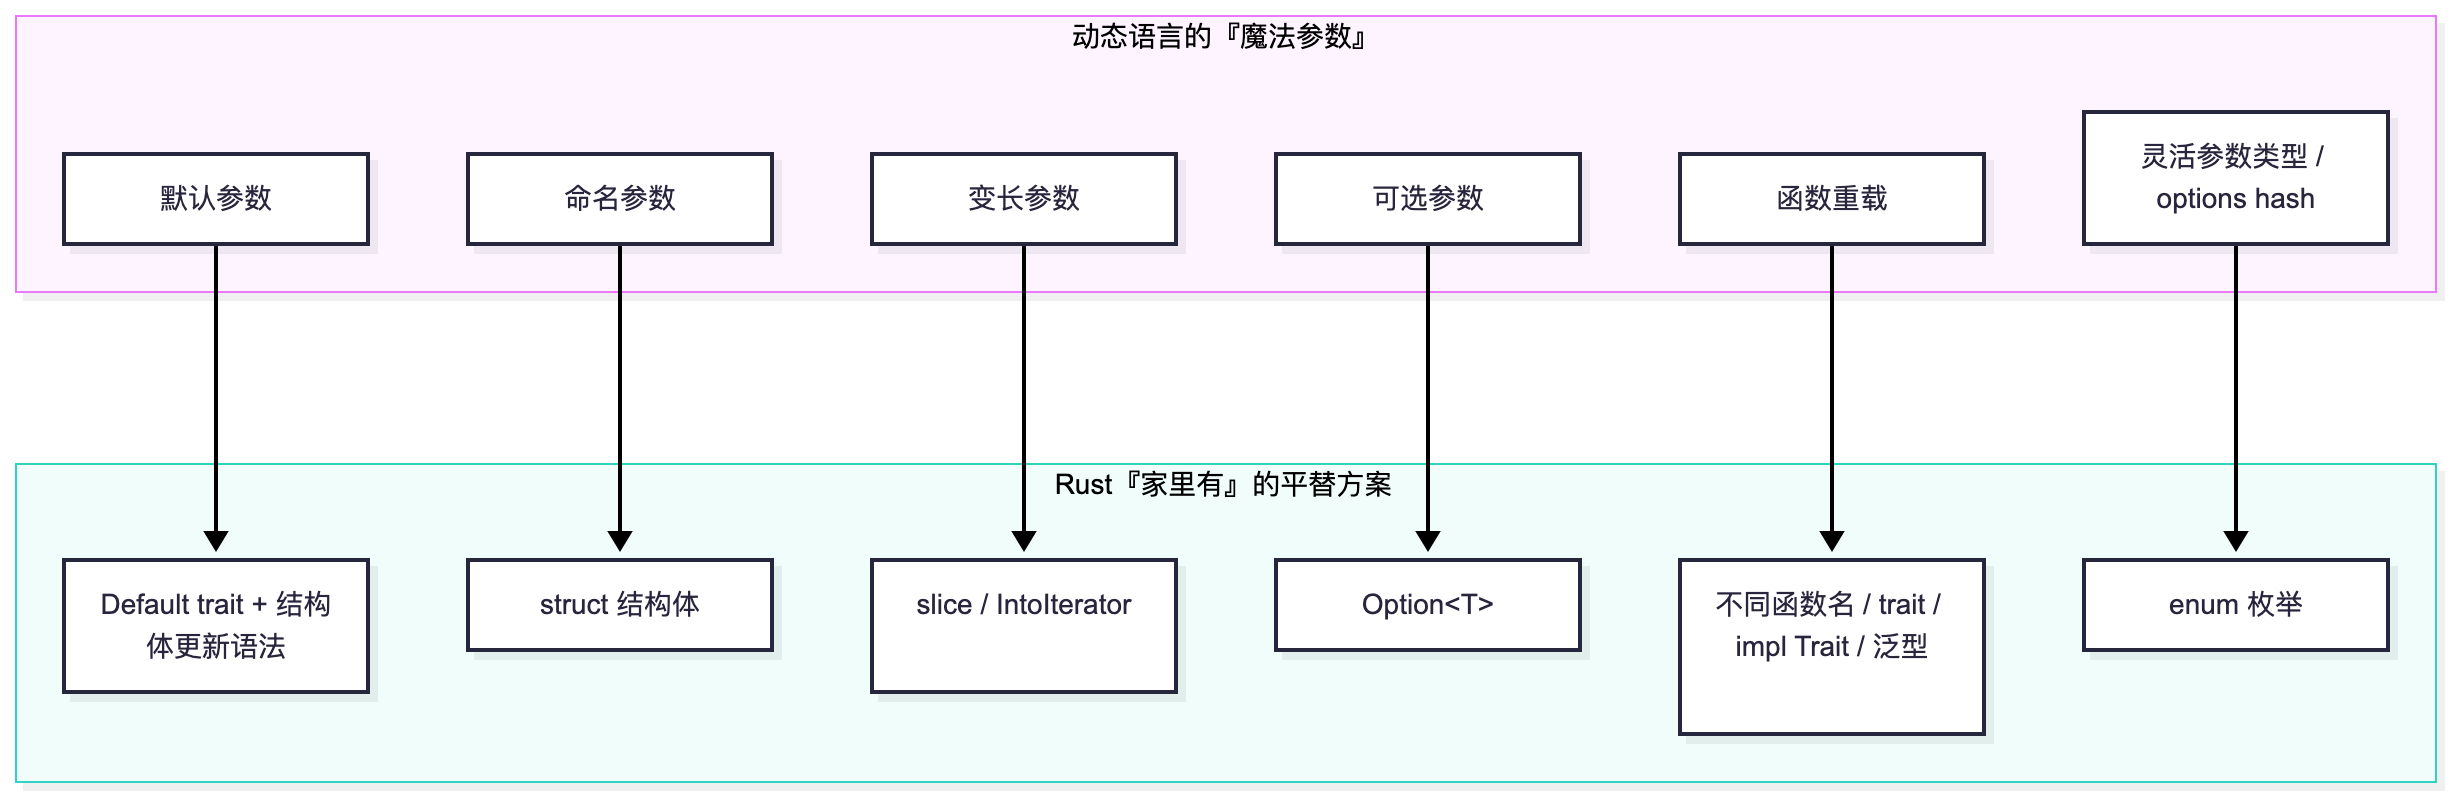
Endler 的立场比 Klabnik 更激进:他认为不但不该给 Rust 加这些语言特性,而且根本不需要加——因为 Rust 已有的类型系统,靠 struct、Option、Default、trait、枚举这几件“老家具”组合起来,就能拿到命名参数、可选参数、默认参数、乃至部分“重载”能力的八成体验,代价只是多写一个类型名字。
他总结了一条贯穿全文的设计规律:很多动态语言把这些能力塞进“函数调用的语法”里,而 Rust 的一贯做法是把它们挪到“类型系统”里。
下面逐条拆解。
struct:命名参数的平替
还是那个 crop_imm 的例子,Endler 给出的方案很直接:把参数打包成一个结构体。
struct Crop {
    x: u32,
    y: u32,
    width: u32,
    height: u32,
}

fn crop_imm<I: GenericImageView>(image: &I, crop: Crop) -> SubImage<&I> {
    // ...
}

let cropped = image::imageops::crop_imm(
    &img,
    Crop { x: 10, y: 20, width: 200, height: 100 },
);
一个结构体,本质上就是“带名字的参数包,只是多花一个类型名的成本”。而且是纯赚:字段可以任意顺序写、编辑器有自动补全和拼写检查、还能给每个字段单独写文档,甚至可以在类型上附加约束(invariant)。
更关键的一点,Endler 特别强调:“名字属于类型本身,而不是属于每一次调用的约定”。这一句话直接化解了 Klabnik 提到的函数指针难题:
struct Size { width: u32, height: u32 }
fn resize(size: Size) { }

// 名字问题根本不会出现,因为参数只有一个,名字挂在 Size 类型上
let f: fn(Size) = resize;
求值顺序的问题也一并解决了——因为 Rust 本来就规定结构体字段按书写顺序求值,不需要为函数调用另外发明一套规则:
let data = vec![1, 2, 3];
let args = Args { length: data.len(), data }; // 合法,按书写顺序求值
当然,Endler 也提醒,不是所有函数都该套上 struct——给 vec.push(value) 这种两参数的简单函数发明一个 PushArgs 结构体就是自寻烦恼。他给出的判断标准是:当一组参数开始有了“概念上的整体性”,本来就应该建模成一个类型的时候,打包成结构体的收益才最大。比如:
// 不太好的写法
draw(x1, y1, x2, y2, width, opacity);
connect(host, port, timeout, retries, tls);

// 更好的写法(同时也是命名参数的平替)
draw(Line {
    start: Point { x: x1, y: y1 },
    end: Point { x: x2, y: y2 },
    width,
    opacity,
});

connect(ConnectionOptions { host, port, timeout, retries, tls });
Option + Default:可选参数、默认参数的平替
对于可选参数,Rust 的答案是 Option<T>:
fn connect(url: &str, timeout: Option<Duration>) { }

connect("https://example.com", None);
connect("https://example.com", Some(Duration::from_secs(5)));
好处是“可选性”被写进了函数类型本身,只有一份函数签名,不存在隐藏的第二种调用约定。但代价也很明显——一旦可选参数多起来,调用点会被一堆 None 淹没:
request(url, None, None, Some(timeout), None, None, None);
Endler 的解法还是“打包成 struct”:
struct RequestOptions {
    timeout: Option<Duration>,
    proxy: Option<Proxy>,
    redirect: Option<RedirectPolicy>,
}

request(url, RequestOptions {
    timeout: Some(Duration::from_secs(5)),
    proxy: None,
    redirect: None,
});
再配合 Default trait 和结构体更新语法,默认值的问题也一并解决,连一堆 None 都能省掉:
#[derive(Default)]
struct RequestOptions {
    timeout: Option<Duration>,
    proxy: Option<Proxy>,
    follow_redirects: bool,
}

request(url, RequestOptions {
    timeout: Some(Duration::from_secs(5)),
    ..Default::default()
});
Endler 承认,..Default::default() 这几个字符确实是多出来的成本,但换来的是:“哪些参数可以省略”“默认值在声明时求值还是调用时求值”“省略参数能不能出现在中间”这些问题,都不需要另外发明规则——Default 只是一个普通 trait,函数调用语法完全不用动。附带的好处是,默认值本身还能被单独拿出来用:
let defaults = RequestOptions::default();
遇到真正复杂的场景:builder 模式
如果连 options struct 都显得啰嗦——通常是因为构造过程需要做校验或类型转换——Endler 认为这时候上 builder 才合适:
let request = Request::builder(url)
    .timeout(Duration::from_secs(5))
    .follow_redirects(false)
    .build()?;
他认同 Klabnik 的观点——builder 不该被滥用,但也指出一个小 builder 有个很实用的特性:每一步都是普通的方法调用,因此可以自然地嵌入条件逻辑,而不需要动态语言里那种“构造一个 map 再展开”的技巧:
let mut request = Request::builder(url);

if let Some(timeout) = config.timeout {
    request = request.timeout(timeout);
}

let request = request.build()?;
trait / 泛型 / 枚举:函数重载和“灵活参数类型”的平替
Endler 指出,人们说“想要重载”,其实往往是三种不同诉求,而 Rust 已经分别有更精确的解法。
诉求一:想要一个“简便版”和一个“完整版”。
解法就是老老实实起两个名字——标准库里的 Vec::new() / Vec::with_capacity() 就是范例:
fn connect(url: &str) {
    connect_with_timeout(url, DEFAULT_TIMEOUT)
}

fn connect_with_timeout(url: &str, timeout: Duration) { }
代价是库作者多想一个名字(通常就是加个 with_... 前缀),换来的是调用方完全不用在脑子里做“重载决议”。
诉求二:想要接受多种输入类型。
用 trait 泛型搞定,标准库里的 Into、AsRef、Borrow 就是这么用的:
fn greet(name: impl AsRef<str>) {
    println!("Hello, {}", name.as_ref());
}

greet("Ferris");
greet(String::from("Ferris"));
和真正的重载不同的是,这里“能接受哪些类型”是显式写在约束里的,不是靠名字解析猜出来的。
诉求三:不同类型需要不同行为。
这其实是多态,交给 trait 就行:
trait Render {
    fn render(self, out: &mut Output);
}

impl Render for &str { fn render(self, out: &mut Output) { /* ... */ } }
impl Render for Image { fn render(self, out: &mut Output) { /* ... */ } }

fn render(value: impl Render, out: &mut Output) {
    value.render(out);
}
至于 Klabnik 提到的 Ruby redirect_to 那种“一个函数、好几种完全不同调用方式”的场景,Endler 认为对应的是枚举:
enum Redirect {
    Url(Url),
    Post(Post),
    Action { action: String, id: u64 },
}

fn redirect_to(target: Redirect) { }
如果还想进一步减少调用点的样板代码,可以加 From/Into 转换:
impl From<Url> for Redirect {
    fn from(url: Url) -> Self { Self::Url(url) }
}

fn redirect_to(target: impl Into<Redirect>) {
    let target = target.into();
}

redirect_to(url);
redirect_to(post);
Endler 特别强调一点:这套写法没有任何运行时开销,而且完全类型安全——对一门编译型语言来说,这已经很难得。
字段初始化简写:关键字语法的平替
Endler 认为有一个 Rust 早就有、但很容易被忽视的小特性,恰恰精准命中了 Klabnik 吐槽 FastAPI 的那个“一堆 xxx=xxx”痛点——字段初始化简写(field-init shorthand):
// 冗余写法
let options = RequestOptions {
    timeout: timeout,
    proxy: proxy,
    retries: retries,
};

// 简写
let options = RequestOptions {
    timeout,
    proxy,
    retries,
};
他认为这甚至比关键字参数更好:标签(字段名)还在,重复没有了,调用函数的方式也完全不用改变。
slice / 迭代器:变长参数的平替
Rust 没有通用的变长参数,但同样的诉求可以用切片或迭代器表达:
fn sum(values: &[i32]) -> i32 {
    values.iter().sum()
}
sum(&[1, 2, 3, 4]);

// 或者接受任意可迭代的东西
fn sum(values: impl IntoIterator<Item = i32>) -> i32 {
    values.into_iter().sum()
}
sum([1, 2, 3, 4]);
sum(vec![1, 2, 3, 4]);
Endler 认为这种写法某种程度上比 sum(1, 2, 3, 4) 更具组合性,因为调用方可以直接传一个已有的集合,而不用先拆成一个个参数。
综合案例:把八个特性拼成一个 HTTP 请求 API
如果 Rust 真的一口气拥有命名参数、默认值、可选参数、变长参数,理想中的调用大概长这样:
request(
    "/hello",
    timeout: 5s,
    redirects: false,
    headers: [
        ("Accept", "application/json"),
        ("X-Foo", "bar"),
    ],
)
Endler 的结论是:不需要任何新语法,用现有的 Rust 也能写出功能等价、只是稍微啰嗦一点的版本:
#[derive(Default)]
struct RequestOptions {
    timeout: Option<Duration>,
    redirects: bool,
    headers: Vec<Header>,
}

fn request(url: impl Into<Url>, options: RequestOptions) -> Result<Response> {
    // ...
}

request(
    "/hello",
    RequestOptions {
        timeout: Some(Duration::from_secs(5)),
        redirects: false,
        headers: vec![
            Header::new("Accept", "application/json"),
            Header::new("X-Foo", "bar"),
        ],
    },
)?;
或者干脆用 builder:
Request::new("/hello")
    .timeout(Duration::from_secs(5))
    .redirects(false)
    .header("Accept", "application/json")
    .header("X-Foo", "bar")
    .send()?;
这里其实组合用到了 struct、枚举、Option、Default、结构体更新语法、字段初始化简写、trait、泛型、迭代器、方法调用——全都是 Rust 本来就有的基础机制,不是专门为“参数传递”发明的新东西。
深层分歧:AI 时代到底该“多打字”还是“少打字”
有意思的是,两人都注意到了 AI coding agent 这个变量,但推出的结论方向不太一样。
Klabnik 的逻辑是:“打字的人不再是我自己了,所以啰嗦的代价降低了,那就上命名参数吧。”
Endler 的回应则是:这个前提他认同,但结论未必成立。他举了同样的 crop_imm 例子——就算 agent 在读取下面这段代码:
crop_imm(&img, Crop { x: 10, y: 20, width: 200, height: 100 });
它拿到的信息量并不比命名参数版本少,甚至可能更多——因为 Crop 这个类型名本身就带有语义身份,而单纯的参数列表没有。同理:
request(url, RequestOptions { timeout, ..Default::default() });
这行代码同时向人类和 AI 传达了一个更丰富的事实:timeout 不只是这一次调用临时传入的东西,而是“配置一个请求”这个概念的一部分。
Endler 干脆把 Klabnik 的逻辑反过来用了一把:如果 AI 真的让打字成本趋近于零,那么“多打几个字来声明一个 struct”的代价也一并被抹平了——“啰嗦”这件事,反而变得更廉价了,而不是更没必要了。用他原话的意思来说:以后 RequestOptions 这种样板代码,正好可以交给机器人去敲。
小结:Rust 的答案,几乎永远是“更好的类型”
这场隔空对话没有争出一个“谁对谁错”的结论,但拼出了一条相当清晰的设计哲学脉络:
动态语言习惯于把更多语义塞进已有的语法结构里,让同一段调用语法在运行时表达出不同的含义;而 Rust 习惯于反过来,把这些语义“外置”成一个个具体的类型,交给编译期的类型系统去做全部的工作。
foo(x)
foo(x, y)
foo(x, timeout: 3)
foo(path: x, timeout: 3)
对应到 Rust,往往就是一句话:
foo(FooOptions { ... })
Endler 把这总结为 Rust 的核心设计原则:找到一组尽可能小、可组合、彼此正交的抽象(struct、enum、trait、Option、Default、迭代器……),组合起来解决远超其本身设计初衷的一大类问题——整体大于部分之和。
至于 Rust 语言本身要不要真的加上命名参数,两位作者的态度出奇一致:不反对,但也不着急。如果哪天有人拿出一份足够精巧、能同时解决模式匹配、函数指针、trait 签名、求值顺序、兼容性这一整套难题的提案,未尝不可以试试;但在此之前,稳定版 Rust 手里的这套“家里有的”平替方案,已经能覆盖相当多的场景,而且是以一种更显式、更类型安全的方式做到的。
对于日常写 Rust 的开发者来说,这场论战给出的实操建议其实很朴素:当你发现自己在给一个函数塞第五、第六个参数时,与其等待语言层面的命名参数,不如先问自己一句——这几个参数是不是本来就该是一个结构体?
参考资料:
- Steve Klabnik,《Arguing about arguments》:https://steveklabnik.com/writing/arguing-about-arguments/
- Matthias Endler(corrode),《We Have Named Arguments at Home》:https://corrode.dev/blog/named-arguments-at-home/
- botahamec 的命名/可选参数提案:https://botahamec.dev/named-optional-args
- Rust 社区关于命名参数的老issue(rust-lang/rfcs #323):https://github.com/rust-lang/rfcs/issues/323
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。