本文永久链接 – https://tonybai.com/2026/10/19/harness2-recursive-agent-harnessing-google-research
大家好,我是Tony Bai。
【导读】
同一个模型,换一套“Harness”,成绩就能差出十几分。谷歌研究团队最近发布 Harness²,让 Agent 在没有标准答案的情况下,自己诊断、自己改装、自己总结经验,而且改装经验还能留给下一个任务用。一步改进,GLM-5 在 WorkBuddy-Bench 上平均提升 11.5 分,反超了原版 Gemini 3.5 Flash。代码已开源。
【文章要点】
- 问题:开放世界任务没有真值和验证器,手工调Harness成本高,静态Harness又难泛化。
- 方法:双层递归。任务级用“Propose–Probe–Compose”,Harness级用可复用的“改进库”。
- 关键设计:靠“同一任务下的行为对照”代替真值打分,改动要有观察到的证据才保留。
- 结果:单步改进在 4 种配置、3 个基准上全部提升,弱模型受益更大。
- 消融:去掉改进库、范围划分、合成,都会掉分。
- 边界:对照证据不等于正确性验证;主实验用更强的模型做编辑器;开源仓库默认网络不受限,评测需自行加限制。
模型一样,“Harness”不同,结果天差地别
今天做 Agent 的人,几乎都有过这样的体验:同一个模型,放进不同的工具框架里,表现可以差得很远。
这个“框架”,业界现在叫 Harness(外壳):提示词、记忆、技能、工具说明、子 Agent 编排,都算在内。近期流行的一个说法是:Agent = 模型 + Harness。
问题来了:Harness谁来调?
人工调,费时费力。让 AI 自己调,也就是递归自我改进(RSI),听上去很美,但落到真实场景就卡壳。
开放世界的两道坎
论文把现有方法的困境归结为两点。
第一,没有标准答案。
开放世界里的任务,设计Harness时见都没见过,运行时又全是新的,既没有真值,也没有可靠的验证器。你怎么知道刚才那处修改是真的变好,还是碰巧?
第二,经验无法沉淀。
为任务 A 精心改出来的Harness,换到任务 B 往往水土不服。直接继承上一个Harness,还会在任务分布变化时引入噪声。
但论文指出了一个被忽视的事实:改进的过程本身就是宝贵的经验,比如问题怎么诊断、试了哪些改动、执行后发现了什么。这些东西,应该被留下来。
于是他们提出了核心问题:
递归自我改进,能不能既改进当前的Harness,也改进“以后怎么改Harness”?
Harness²怎么做:双层递归
名字里的上标 2,指的就是“两层”。整体流程如下:
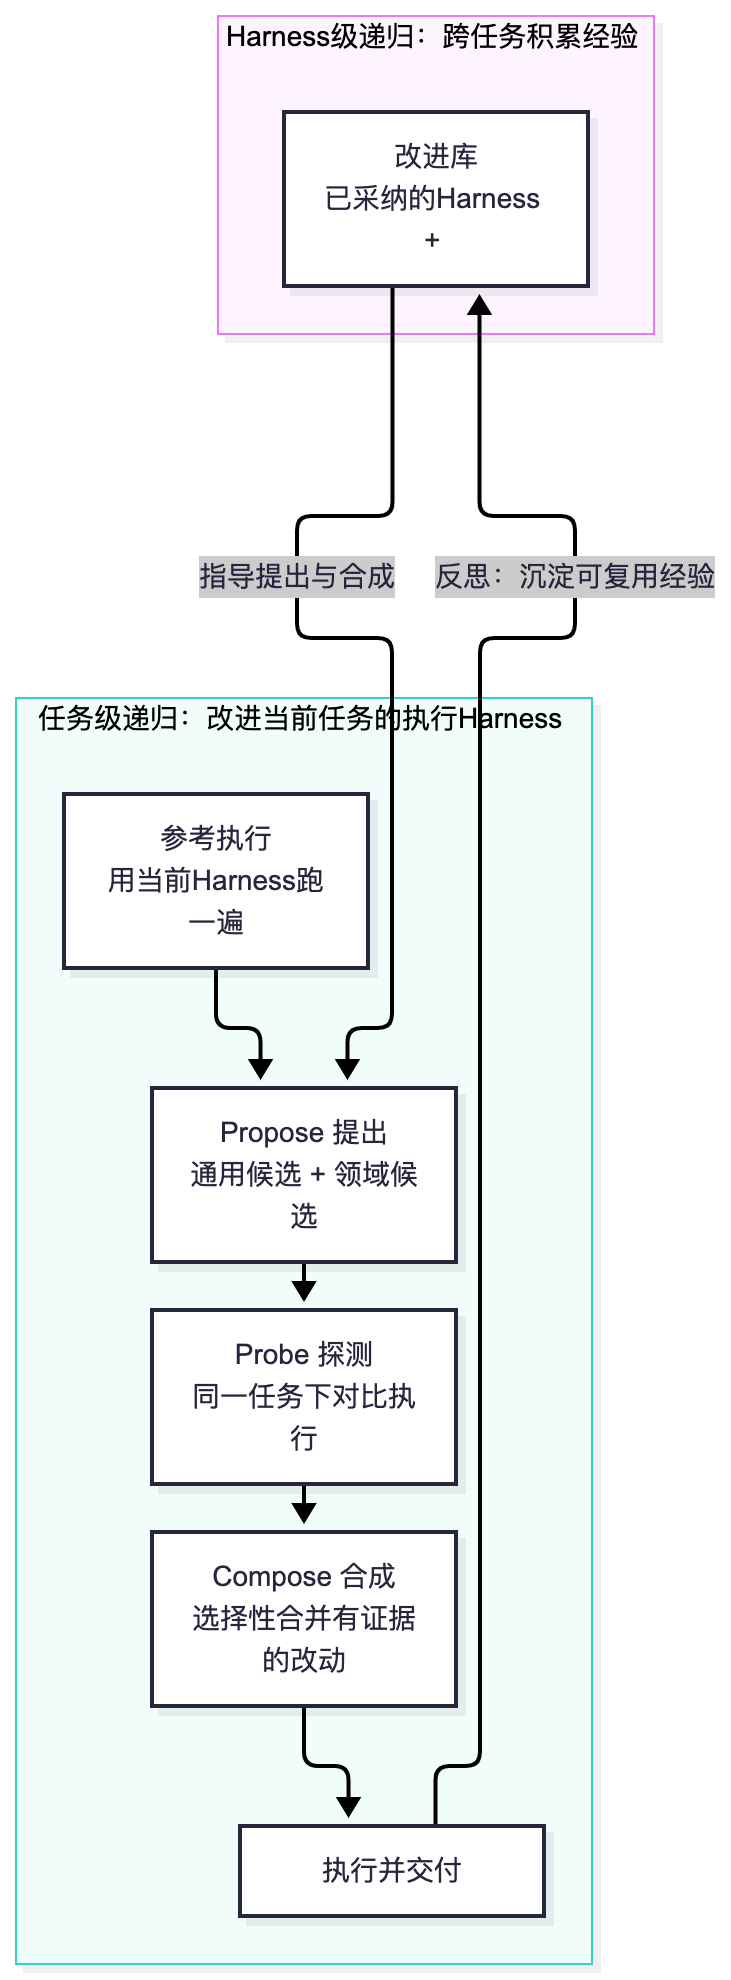
1. 任务级递归:Propose–Probe–Compose
这是整个框架的发动机,一步分三环:
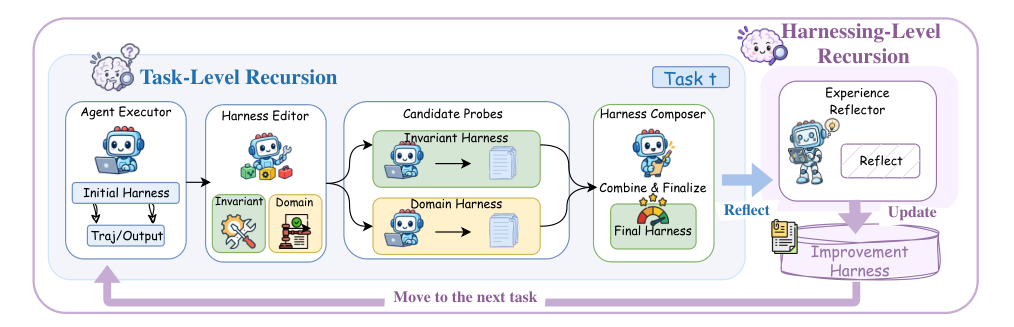
- Propose(提出):先用当前Harness跑一遍任务,得到“参考执行”。然后生成两个候选Harness:一个“通用候选”,针对规划、工具使用、上下文管理、任务委派这类可能在各领域反复出现的缺陷;一个“领域候选”,针对当前领域的知识、流程和约束。
- Probe(探测):把每个候选Harness放到同一个任务、同样的模型和环境下执行,再和参考执行做对比,得到“行为对照”,看它是缓解了目标缺陷、没变化,还是引入了新问题。
- Compose(合成):综合所有证据,选择性地合并、修订、采纳某个候选,甚至保留原Harness不动。每个决定都要对应一个具体观察,而不是“我觉得会涨分”。
关键点在于:论文明确说,这些对照是为合成提供依据,并不验证答案对不对。因为执行有随机性,模型也有共同偏见,它是证据,不是裁判。
2. 两种放大方式:并行与串行
用一个预算参数 k 控制探索量:
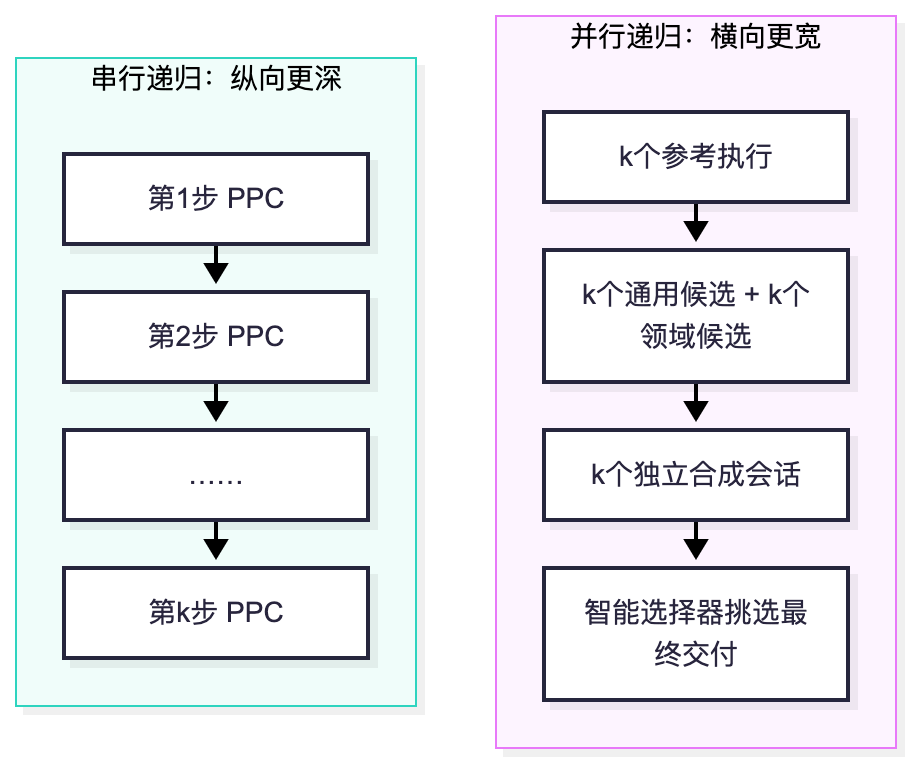
并行递归一次性铺开,再让多个合成会话各自融合;串行递归把上一步的Harness和执行证据一路传给下一步,后面的步骤可以修正前面的改动。k=1 时两者等价。
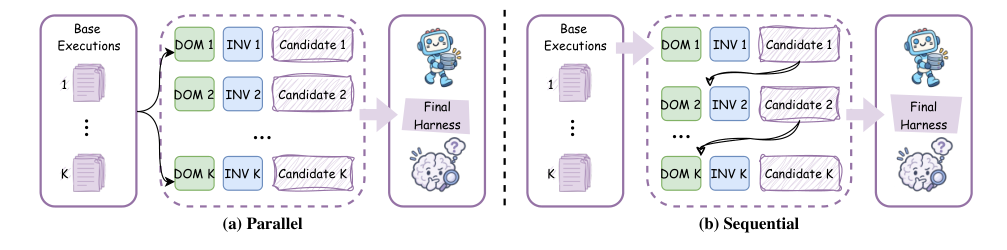
3. Harness级递归:把“改进经验”存起来
每个任务结束后,系统会复盘整个改进记录,把被采纳的Harness和有证据支持的经验存进改进库。库里每个条目包含一个可执行Harness,加一份记录适用场景、经验教训和证据的 EXPERIENCE.md。
注意两个细节:
- 下一个任务依然从统一的初始Harness出发,旧组件只会在 Propose 阶段被选择性复用或改造,不会自动继承。
- 证据不足时,反思环节宁可不写新经验。仅仅“某个输出被选中”,不算可迁移的证据。
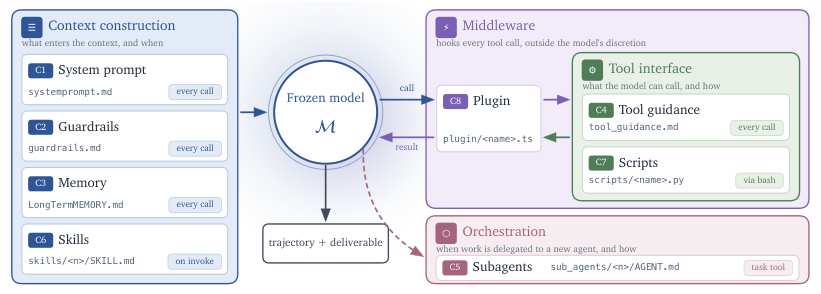
被改动的Harness有 8 类可编辑组件:系统提示词、护栏、记忆、技能、工具说明、脚本、子 Agent、中间件插件。每个组件都以文件形式挂载在运行时里,改动就是改文件。
成绩单:数据怎么说
实验在三个专业基准上进行:WorkBuddy-Bench(代码、网页、办公)、JobBench(端到端工作任务)、LAB(法律工作,指标为逐条标准通过率 Partial)。执行模型是 Gemini 3.5 Flash 和 GLM-5,每个模型都跑在 OpenCode 和 Codex 两种Harness下,共 4 种配置。默认的Harness编辑器是 Claude Opus 4.8。
下表摘自论文,为单步改进(k=1)相对基础Harness的变化:
| 配置 | WorkBuddy 平均分 | JobBench 分数 | LAB Partial |
|---|---|---|---|
| GLM-5 + OpenCode | 64.2 → 75.7(+11.5) | 20.6 → 24.2(+3.6) | 59.6 → 71.4(+11.8) |
| GLM-5 + Codex | 64.4 → 75.3(+10.9) | 23.6 → 24.8(+1.2) | 58.1 → 65.9(+7.8) |
| Gemini 3.5 Flash + OpenCode | 72.4 → 77.5(+5.1) | 31.5 → 36.0(+4.5) | 79.9 → 81.9(+2.0) |
| Gemini 3.5 Flash + Codex | 74.5 → 77.5(+3.0) | 33.9 → 35.3(+1.4) | 71.6 → 75.6(+4.0) |
几个值得拎出来的结论:
① 四种配置全部提升。 最大涨幅分别是 WorkBuddy +11.5、JobBench +4.5、LAB +11.8个百分点。
② 弱模型受益更大,甚至能反超。 在 WorkBuddy 上,GLM-5 经过一步改进后拿到 75.7(OpenCode)和 75.3(Codex),超过了 Gemini 3.5 Flash 的原始成绩 72.4 和 74.5。弱模型配上改进后的Harness,可以超过强模型用原Harness。
③ 对手不太稳。 论文称,ReasoningBank 在代码任务上最多比基础Harness低 6.6 分;Harness Scaling 在 12 组“基准—配置”里有 7 组低于基础Harness。Harness²在 WorkBuddy 平均分和 JobBench 分数上,4 种配置全部超过所比较的基线。
④ 加预算继续涨。 并行递归 k=5,在单步基础上再涨:WorkBuddy +2.9 至 3.9,JobBench +3.0 至 4.2,LAB +2.6 至 6.7个百分点。以 Gemini 3.5 Flash + OpenCode 为例,k 从 1 增加到 5,相对基础Harness的收益在 JobBench 上从 4.5 升到 7.5,在 WorkBuddy 上从 5.1 升到 8.4。
⑤ 步数更少。 在 WorkBuddy 上,Harness²的平均执行步数大多低于或接近基线,说明提升不是靠“多跑几步”换来的。论文还提到,在算力与性能的权衡图上,Harness²的两种配置都落在经验帕累托前沿上。
拆开看:哪些设计真正有用
消融实验(Gemini 3.5 Flash + OpenCode,k=1):
| 版本 | WorkBuddy | JobBench |
|---|---|---|
| 完整 Harness² | 77.5 | 36.0 |
| 去掉改进库 | 74.4 | 34.2 |
| 去掉范围划分(通用/领域两类编辑器合并为泛化编辑器) | 74.6 | 32.3 |
| 去掉合成(只选一个候选) | 75.9 | 34.1 |
三个设计都有贡献。其中“范围划分”在 JobBench 上影响最大,掉了 3.7 分。
“直接改”不行,有库才行。
论文做了个对比:不给参考执行、不给候选探测、也不给改进库,直接让编辑器改基础Harness,结果反而退步:Code 从 73.4 掉到 63.2,Web 从 69.9 掉到 65.0。k=1 积累出的改进库能把性能拉回基础水平,k=5 积累的库则带来 Code +0.9、Web +4.4、Office +5.1 的增益。探索越充分,沉淀出的经验越值钱。
经验可以跨基准迁移。
用 JobBench 积累的库去帮 WorkBuddy 做单步改进,三个领域分别有 +0.6、+0.5、+2.9 的提升。不过论文也说明,这是回顾性测试,用于验证跨任务复用,而不是在线适应。
编辑器不必更强。
主实验用 Opus 4.8 做编辑器,难免让人怀疑“是不是强模型教弱模型”。论文给了同模型自我改进的实验:从 GLM-5 到 Claude Opus 5,五个模型在每个基准上都有提升;Opus 5 在三个基准上分别 +3.3、+5.5、+3.0,GLM-5 在 LAB 上 +13.7。
一个案例:43.1分到77.8分
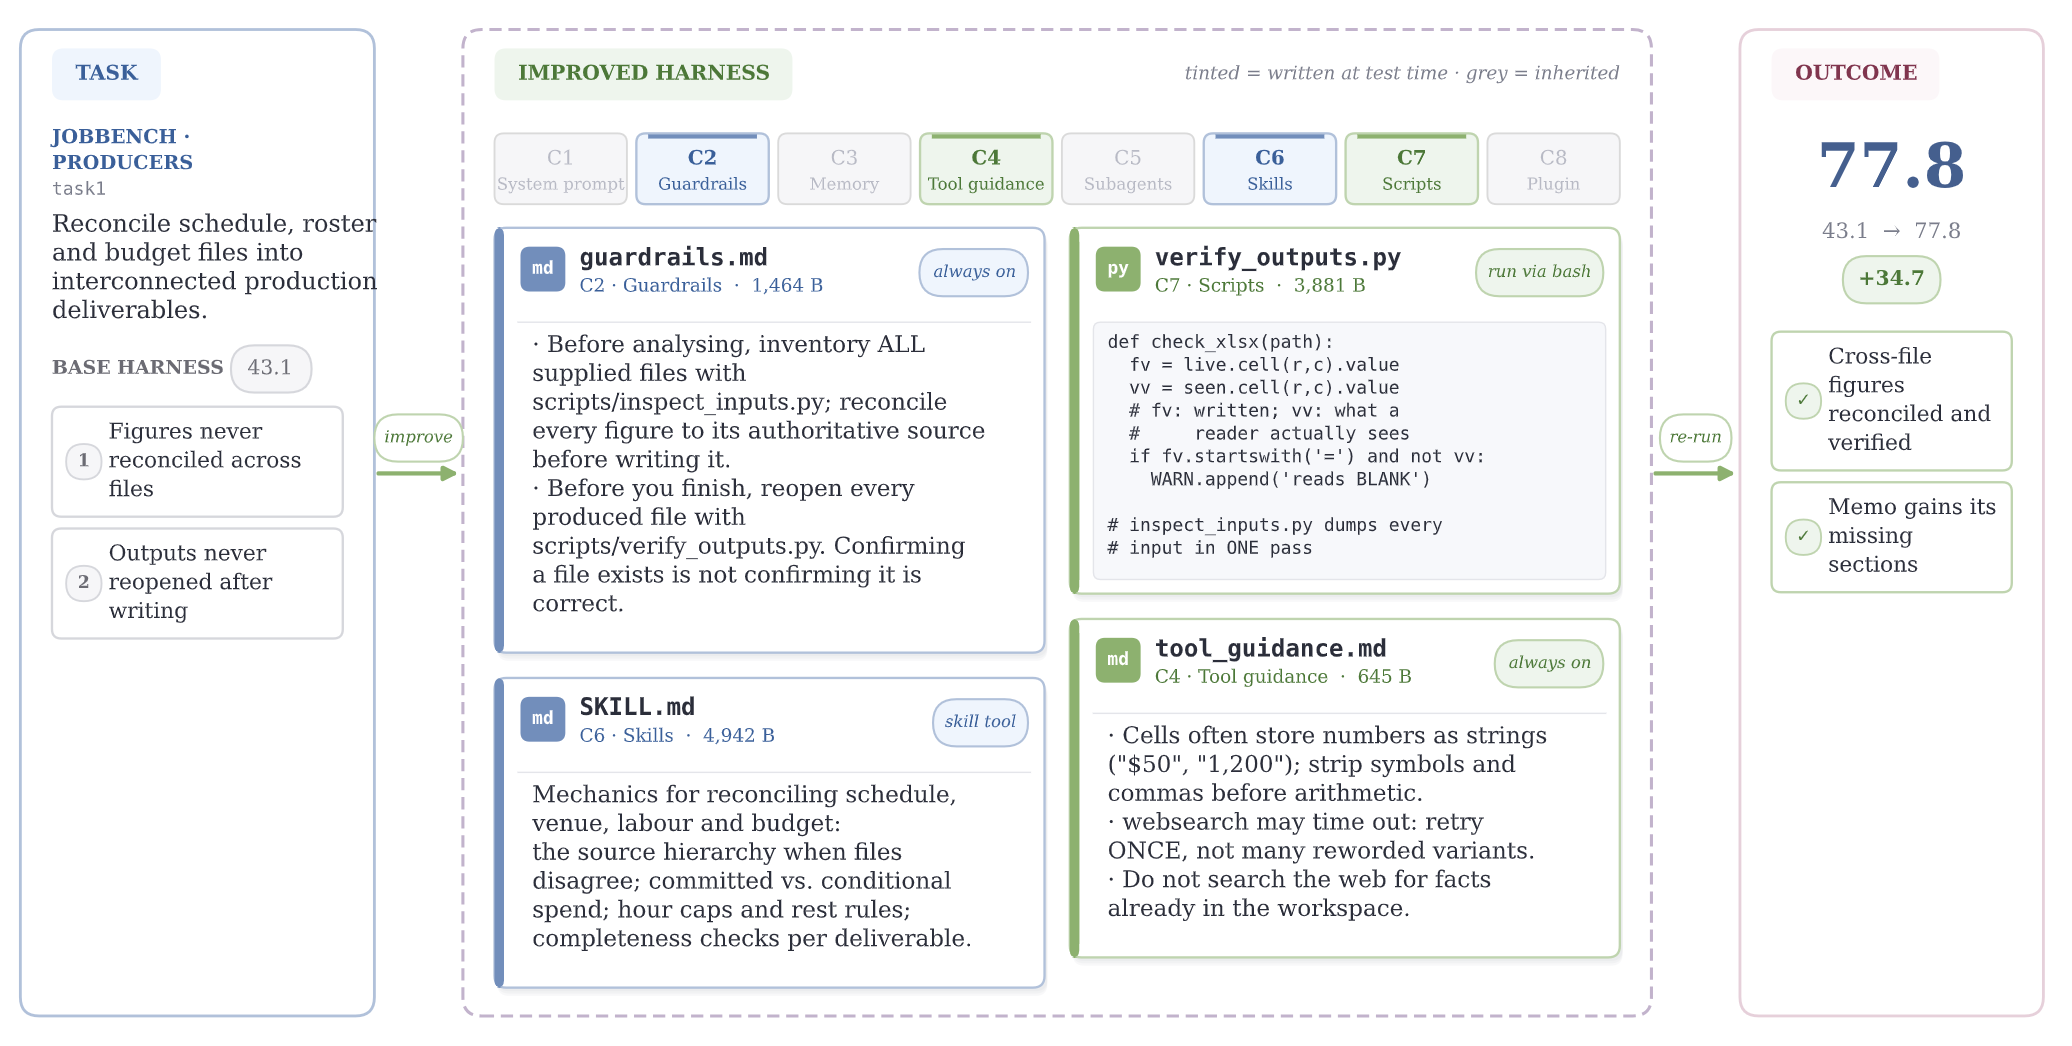
论文给了一个 JobBench 的案例(Gemini 3.5 Flash + OpenCode)。基础Harness得分 43.1,轨迹显示失败原因不是知识缺失,而是流程缺陷:多个源文件的数据没有对账,产出文件写完后也没有重新打开检查。
Harness²做了两处针对性改动:
- 通用干预:加入过程级护栏,要求先盘点全部输入、把每个数字追溯到来源,并用验证脚本重新打开产出文件检查。
- 领域干预:补充一个专门的“对账”技能,覆盖日程、场地、人工、预算等文件,并附带数字格式处理的工具说明。
合成阶段对照参考执行后,四处改动全部保留。重跑之后,数据完成交叉核对,备忘录缺失的章节被补齐,得分升到 77.8。
动手:仓库怎么跑
仓库为 Apache-2.0 协议,要求 Linux、Python 3.12 和 uv。无需模型凭证就能跑本地演示:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
演示用确定性编辑器和真实 Python 执行,同时展示两种递归模式。要跑真实基准,需要 Node.js 20+、Google Cloud CLI,并配置 Vertex AI 项目。以 LAB 为例:
harness2-setup lab
harness2 --bench lab --k 1 --mode parallel --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
--k 是任务级递归预算,--mode 选并行或串行,--substrate cx 切换到 Codex 执行器,--dry-run 可以先预览任务选择而不调用模型。运行结果会保存在 runs/ 下,包括交付物、被采纳的Harness、反思笔记和评测结果,重复同一命令即可断点续跑。
冷静看:几个需要注意的地方
- 对照不等于验证。 论文自己承认,行为对照受执行随机性和模型共同偏见限制,只是“有依据的证据”,不是“正确性证明”。
- 编辑器与执行器的强弱。 主实验用较强的 Opus 4.8 做编辑,同模型实验缓解了这一疑虑,但两种设置下的绝对增益并不能直接比较。
- 成本。 改进本身要消耗 token。论文的算力对比把执行和改进成本都算进去了,Harness²仍在帕累托前沿,但具体到你的业务,需要自己算账。
- 并非处处第一。 论文也指出,在 LAB 的 Partial 指标上,Gemini 3.5 Flash + Codex 配置下是 Meta-Harness 领先;在个别子项上,离线优化的 Meta-Harness 也有更高分。
- 评测安全。 仓库说明,执行器网络访问默认不受限,Codex 沙箱默认关闭,而公开基准的评分标准可能在网上找到。正式评测前,需要自行配置网络限制,避免接触答案和评分标准。
- 官方定位。 仓库声明这不是 Google 官方支持的产品。
小结
Harness²给出的思路很清晰:模型权重不动,把“怎么改Harness”本身也当成可学习的对象。它不依赖标准答案,靠同一任务下的行为对照做判断;它不盲目继承旧Harness,而是把经验和证据存起来,按需调用。
当模型能力逐渐拉不开差距,Harness工程可能成为下一个拉开差距的地方。至于这套“自己改装自己”的机制,能在多大范围内稳定复现,还有待社区用真实业务来检验。
资料来源
- 论文:Harness²: Recursive Agent Harnessing for an Open World,arXiv:2610.14224 - https://arxiv.org/html/2610.14224v1
- 代码:github.com/google-research/harness2
- 项目主页:harness2.github.io
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
