本文永久链接 – https://tonybai.com/2026/10/13/debug-when-you-no-longer-understand-the-code
大家好,我是Tony Bai。
【导读】
AI 五分钟给出的“根因分析”头头是道,可你读完只能说一句“好像有道理”。当工程师对 AI 生成的代码只有粗浅理解时,谁来给 Agent 的结论把关?一位工程师用三个真实的生产故障,给出了答案:别让 Agent 先读代码,先给它“事实”。
【文章要点】
- 理解力债务与致命诱导:AI 的根因分析常常条理清晰却南辕北辙,而人类对数千行 AI 代码的粗浅理解往往不足以反驳它,盲目信任极易把错误修复合并上线;
- 代码是“不可靠的叙述者”:代码只展示了系统“可能发生什么”,而非生产中“实际发生了什么”,让 Agent 先读代码是严重的诊断反模式,读代码应该是调查的最后一步;
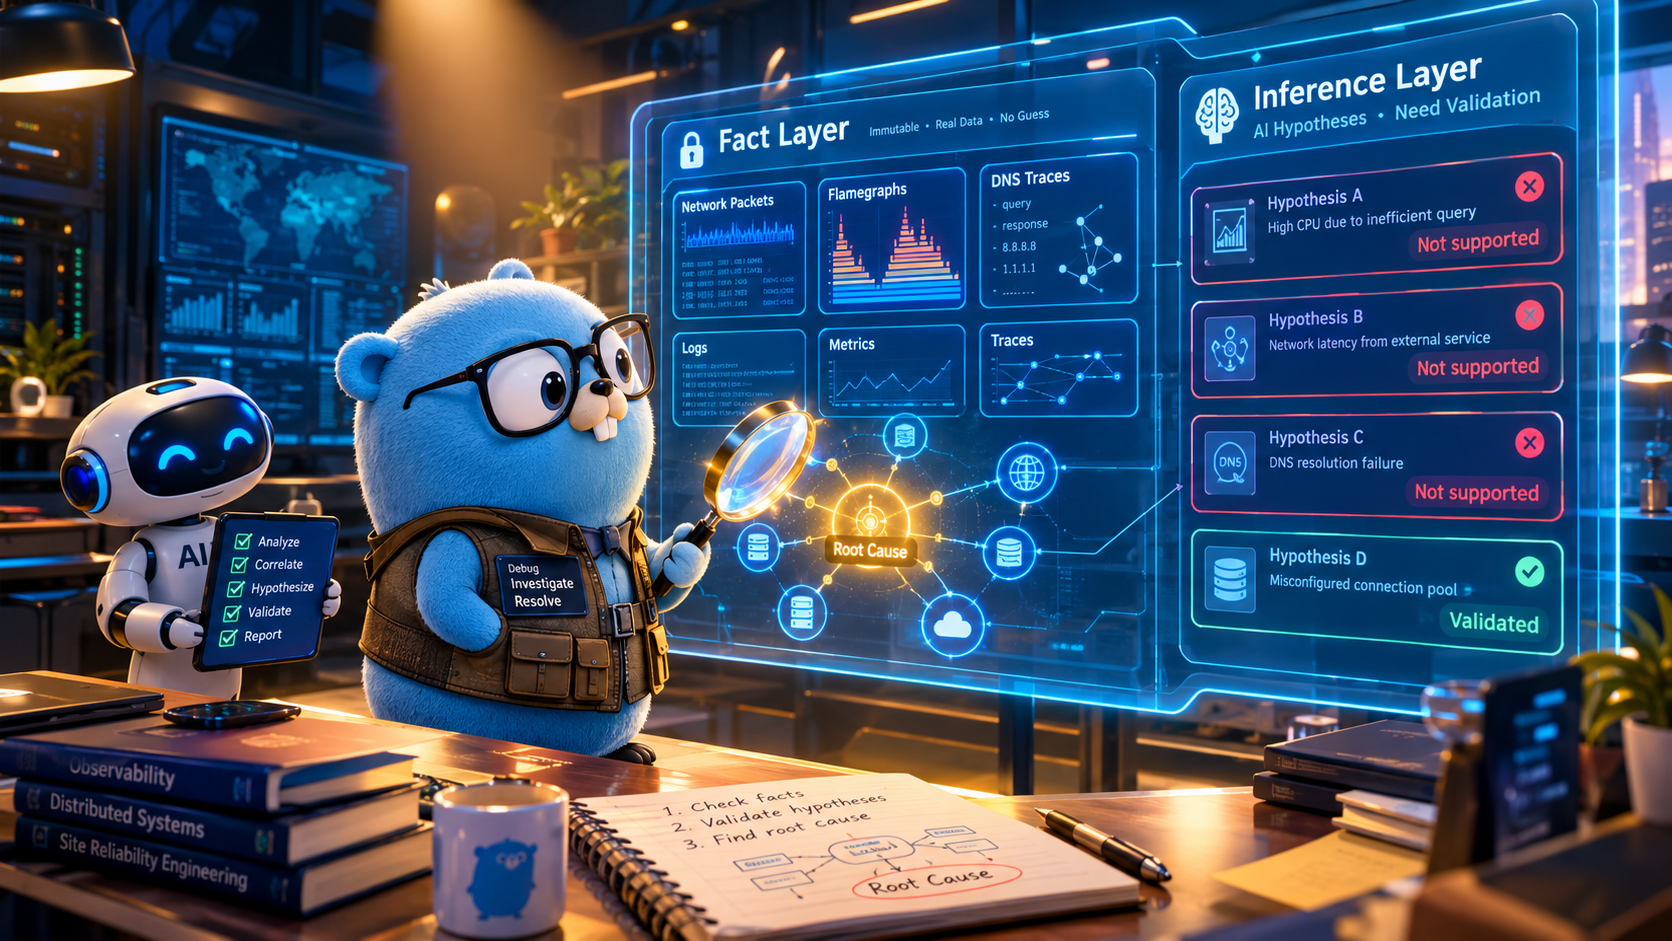
- 调试即“约束满足问题”:将调试严密拆解为由客观工具采集的“事实层(不可篡改)”和充满叙事推论的“推导层(Agent 假说)”,所有事实皆为硬约束,矛盾一条就必须无情剔除该假说;
- 三步调试循环与强信号挖掘:通过对比变量与对照组剔除环境噪音,利用“假设 × 事实”矩阵挖掘出只有极少数假设能解释的“强信号”(如 DNS 节点数激增),并用全量历史数据完成不可逆校验;
- 避开复现陷阱与对抗盲区:本地环境的轻率复现往往是巧合的推导产物,必须产生与真实环境完全一致的强信号才可信;对抗式评审本质是证伪的“排除器”,绝非事实本身的验证器;
- 重塑 Agent 原生的软件工厂:为人优化高层决策点,为 Agent 优化底层细粒度事实采集,把“人工干预次数”作为衡量智能体基础设施成熟度的最诚实指标。
线上告警响了,你把监控截图丢给 AI。
五分钟后,它给出了一份条理清晰的根因分析。你读完点点头:嗯,好像挺有道理。
然后,你差点把一个错误的修复合并上线。
这不是段子,而是 Cindy Sridharan 最近的亲身经历。这位在分布式系统领域颇有名气的工程师,在 Medium 上发表了一篇阅读时长 63 分钟的长文,复盘了她用 Claude 修三个生产 Bug 的全过程,并总结出一套“看不懂代码,也能让 Agent 高效调试”的方法论。
我们把它浓缩成了十分钟的版本。
三个 Bug,三种翻车姿势
Bug 一:延迟飙升,1 行代码的真相
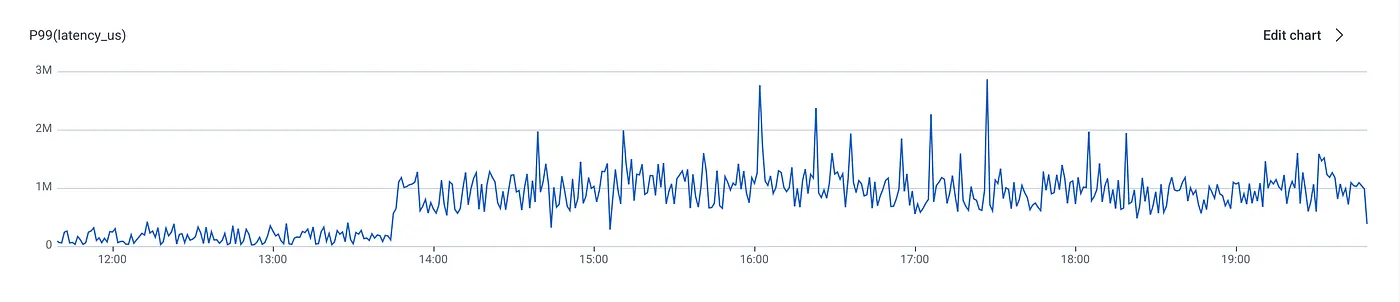
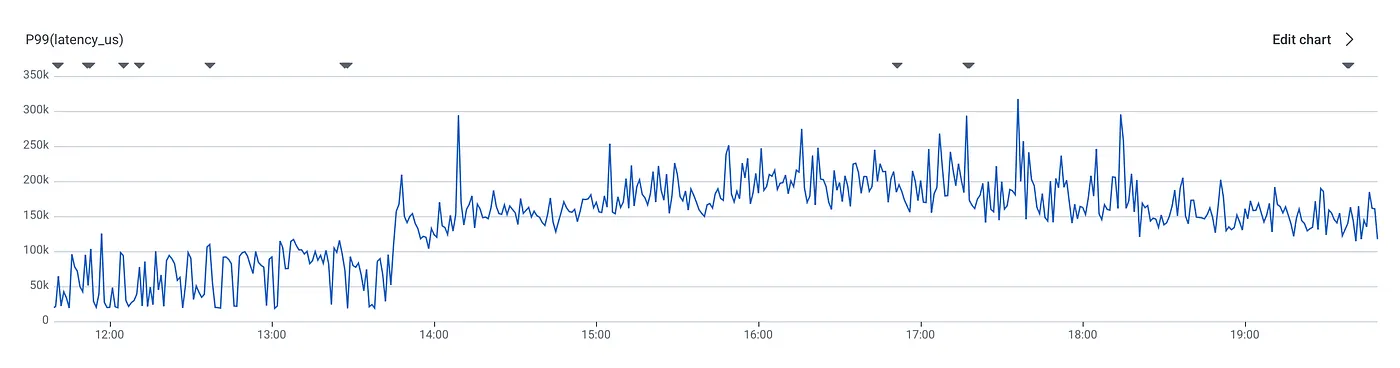
一个由 Agent 在一天多时间里写完的 9000 行新功能,灰度上线 10 分钟后,客户端和服务端的 P99 延迟同时飙升。
作者把遥测数据丢给 Claude,五分钟后得到结论:新功能里的 TLS 证书被“每次 RPC 都重新加载”。听起来很合理,作者当时也没法反驳。
但她多留了个心眼:让 Claude 登上一台生产机器,抓包、监控进程,并拿“关闭功能开关”的情况做对照。结果发现,证书只加载了一次,这个结论是错的。
真正的线索来自一个意外:对照组的 DNS 解析返回约 5 个地址,出问题的一组返回约 400 个。原来新的 mTLS 代码路径用错了客户端,请求没有路由到正确的分片。修复只需 1 行:DatabaseClient 改成 ShardedDatabaseClient。
为什么测试没拦住?预发环境只有 2 个分片,生产环境是 5 个分片、每片 80 个副本。
Bug 二:内存泄漏,AI 连错三次
用户报告容器被 OOM 杀掉,还附上了复现步骤和 heaptrack 输出,看起来是“简单模式”。
Claude 却连错三次:先说是无限重试,再怪到一项默认关闭的优化上。两次都被作者当场驳回,因为那个状态机是她亲手写的,哪些状态可达,她心里有数。
第四次,作者不再让它二分查找提交,而是让它沿着“没有有效凭证”这条路径逐行追踪。真相是:一个默认开启的进程级缓存,让本应“一次性使用”的状态机被反复重入,递归栈帧不断堆积,最终撑爆内存。
Bug 三:神秘挂起,在内核数据里找针
桌面守护进程间歇性出现 60 秒超时,没有日志,无法复现,用户一重启现场就没了。作者对桌面软件和 macOS 内核几乎一无所知。
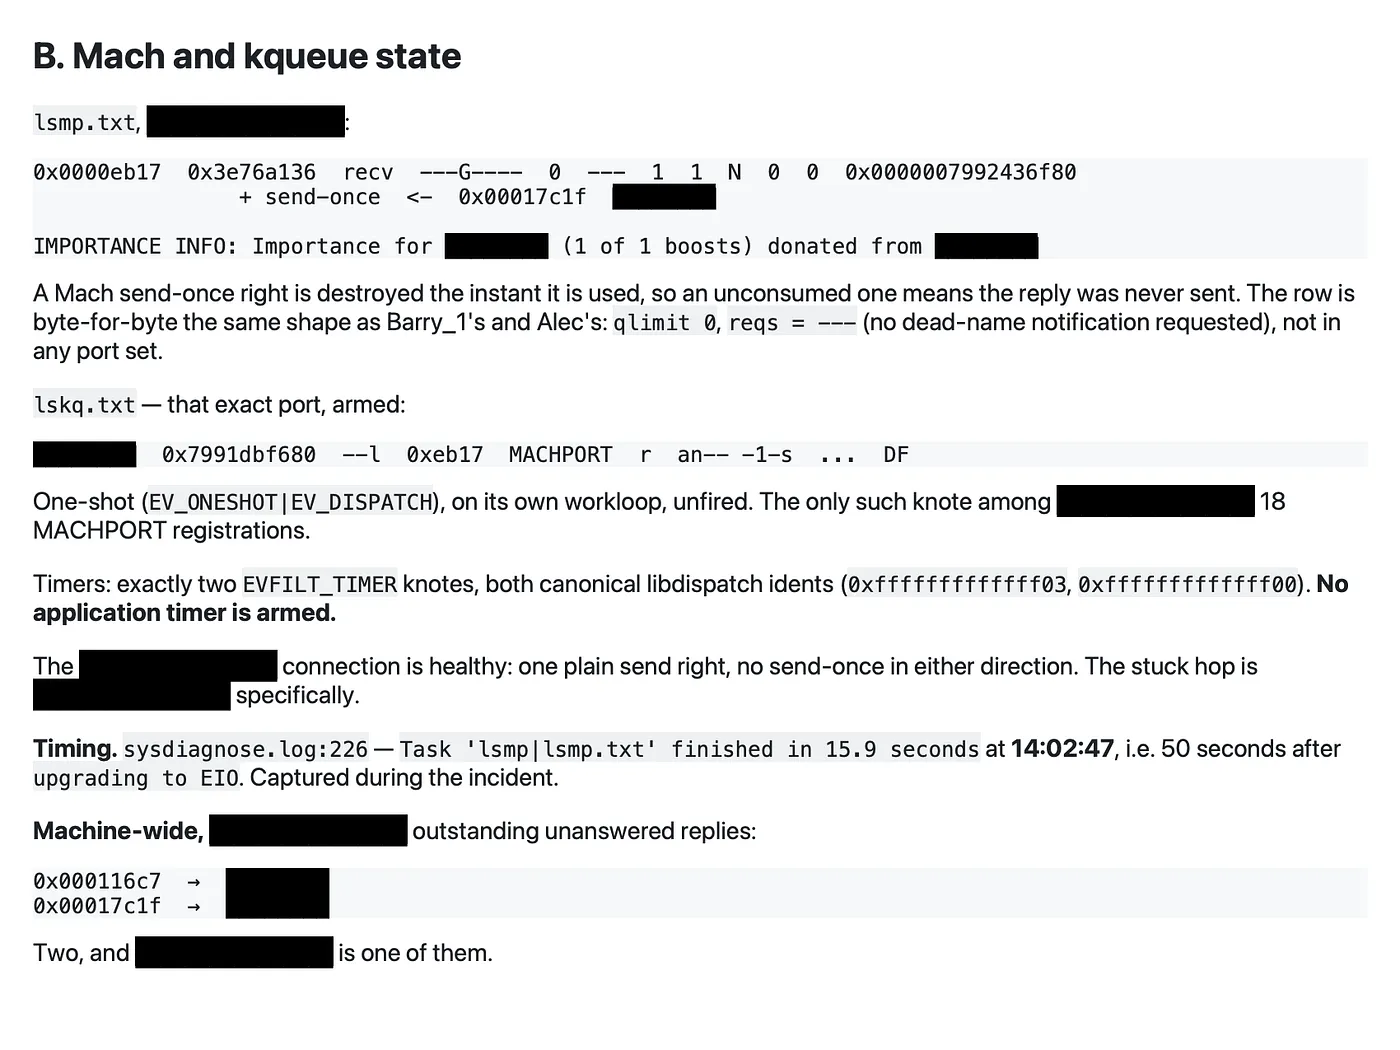
她靠 Claude 在 30MB 的 sysdiagnose 里层层下挖:抓包显示握手成功后只剩心跳,再用 lsmp 查看 Mach 端口,发现认证守护进程收下了 XPC 请求,却始终没有回复,那张“一次性回复票据”在 67 小时后依然存在。
还需要理解代码吗?
作者坦言,今年夏天之前,她一直坚信:谁提交的代码,谁就必须完全理解它。
现在她动摇了。手写代码是一场“慢燃”,每个变量名、每个结构体字段都是一次决策,细节自然刻进脑子里。而 Agent 几分钟生成几千行,即便逐行读完,理解也远不如从前。
更现实的问题是:你的理解,已经不足以在 Agent 说错时有力地反驳它。 延迟 Bug 里,9000 行代码她逐行读过,依然被错误结论说服了。
所以出路不是“再努力读代码”,而是建立一套即使你不懂代码,也能约束 Agent 的方法。
核心心法:把调试变成“约束满足问题”
代码是“不可靠的叙述者”
作者最重要的反直觉结论:让 Agent 先读代码,是反模式。
代码只能告诉你“可能发生什么”,而不是“实际发生了什么”。状态空间太大,Agent 又会自己挑选要读的代码片段,很容易从一个看似合理的角度,一路走偏。读代码,应该是整个调查的最后一步。
三个术语
- 变量:出问题的那个案例。
- 对照:与变量只差一个怀疑因素的案例,比如关闭功能开关后的同一套代码。
- 信号:任何可能解释 Bug 的数据点,如日志、延迟、调用栈、计数器等。
两层框架
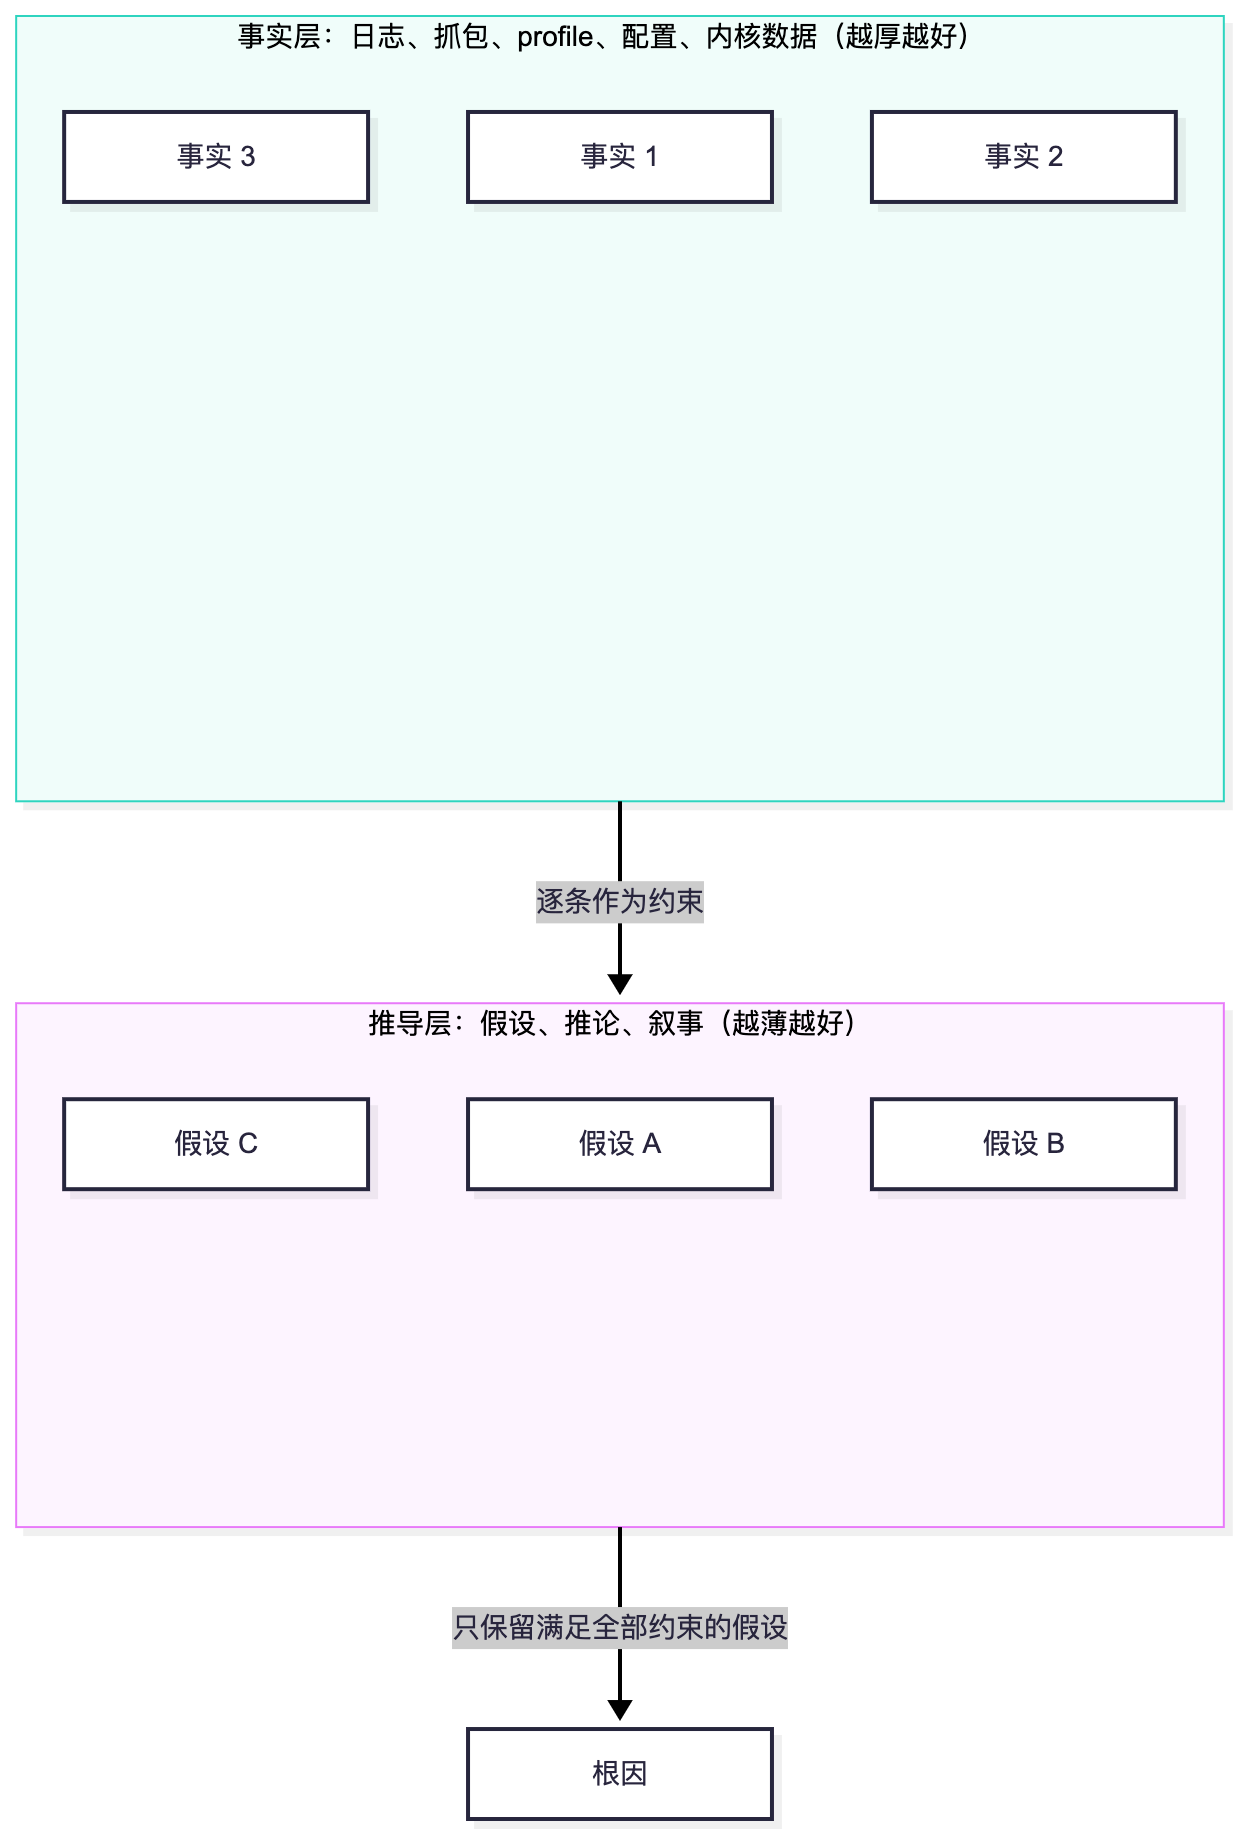
作者把调试分成两层:
- 事实层:日志、抓包、profile、配置、内核数据……由工具采集,Agent 只能观察,不能篡改。
- 推导层:假设、推论、叙事。Agent 最会讲故事,也最容易出错。
规则很简单:事实层里的每一条事实都是约束,只有满足全部约束的假设才能留下。
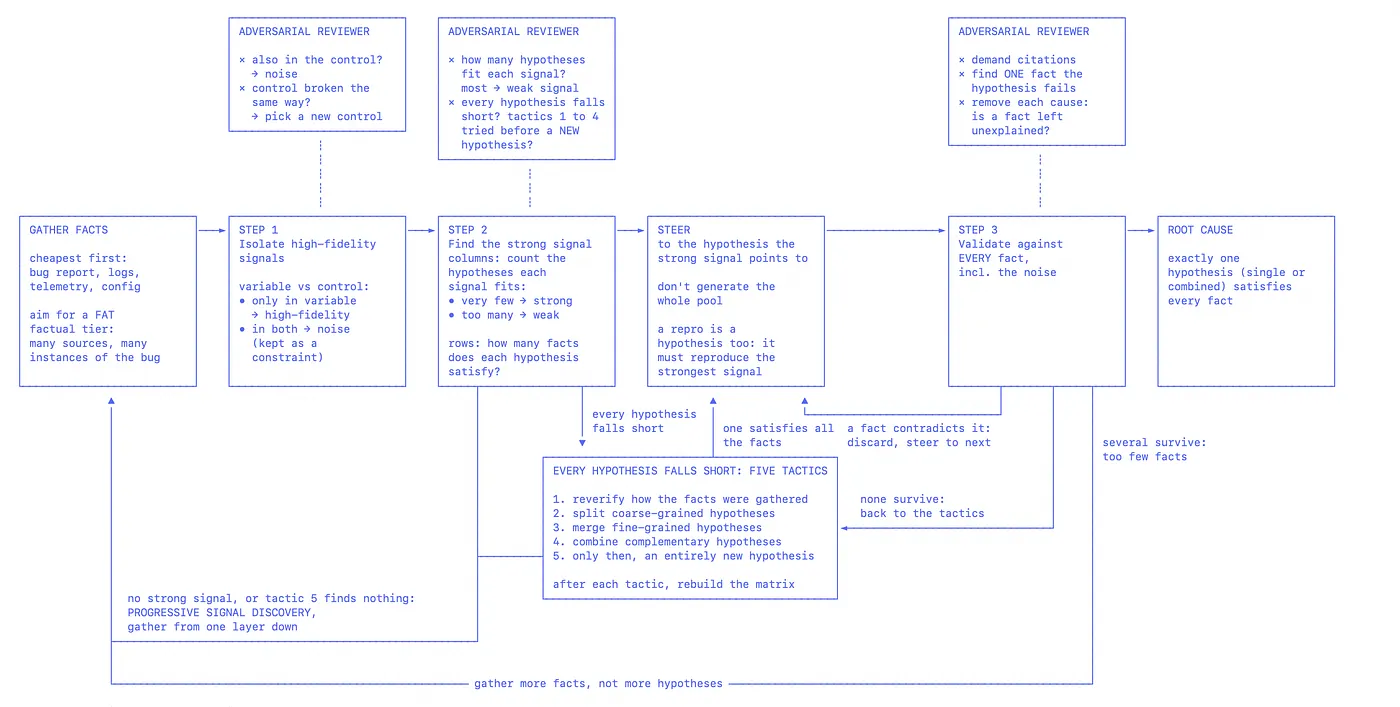
三步调试循环
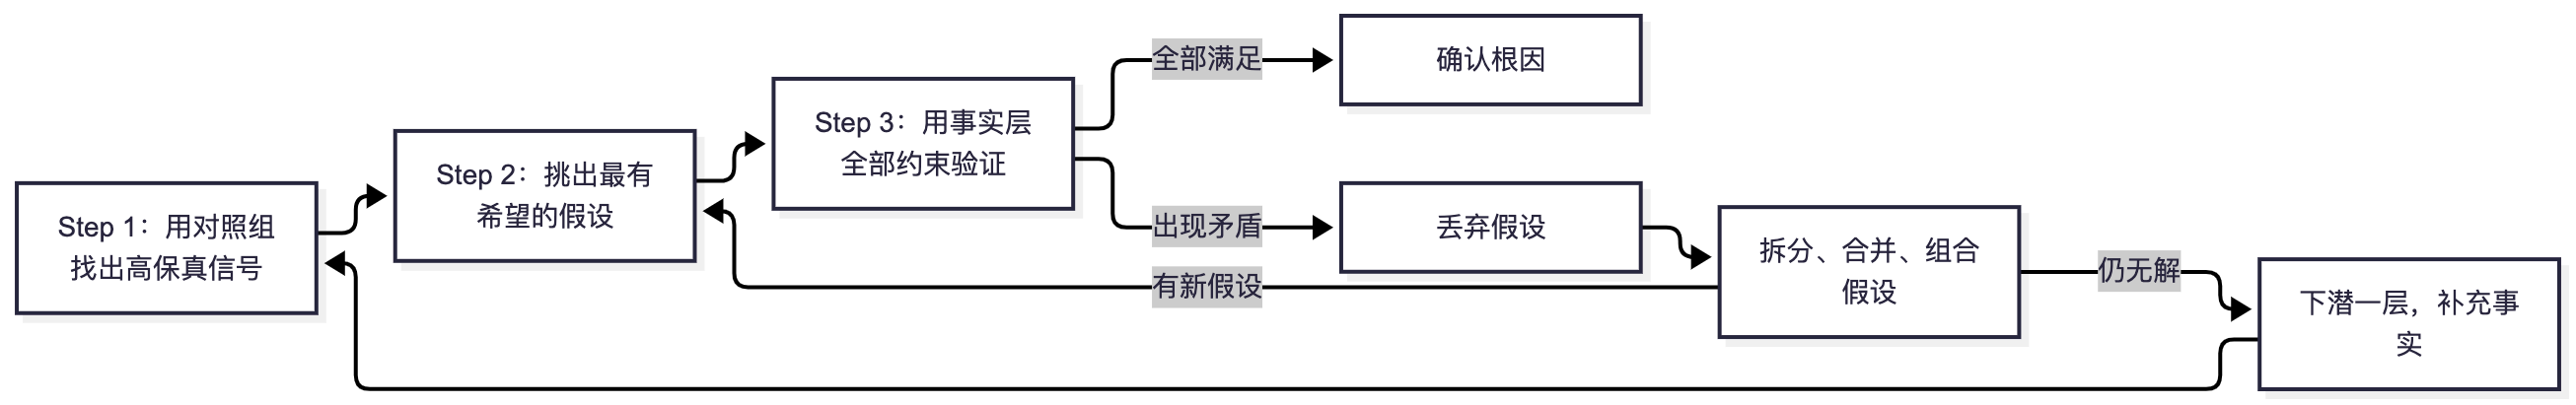
Step 1:用对照找信号。 只出现在变量、不出现在对照里的数据,才是高保真信号;两边都有的,只是噪声,可以用来排除假设,但不会告诉你该往哪看。如果“一切正常”的路径差异太大,不妨选一个“失败得更响亮”的案例做对照。
Step 2:找“强信号”。 能被很多假设同时解释的信号是弱信号,只有一两个假设能解释的才是强信号。让 Agent 画一张“假设 × 事实”的矩阵,一眼就能看出差别。
| 假设 | P99 升高 | DNS 返回约 400 个地址 |
|---|---|---|
| 服务端自身退化 | ✓ | ✗ |
| 证书频繁重载 | ✓ | ✗ |
| 客户端路由退化 | ✓ | ✓ |
| 服务端容量不足 | ✓ | ✗ |
| 事件循环卡顿 | ✓ | ✗ |
| CPU 限流 | ✓ | ✗ |
| 上游变慢 | ✓ | ✗ |
P99 延迟人人都能解释,是弱信号;DNS 的 5 对 400,只有一个假设说得通。这也解释了为什么 AI 一开始会被“证书重载”带偏。经验规则:SLO、SLI 这类指标,往往只是症状,是弱信号。
Step 3:用全部事实验证。 候选假设必须经受事实层中每一条事实的检验,包括噪声。矛盾一条,就必须丢弃。
所有假设都不成立怎么办?
别急着编新故事,先试这五招:
- 复核事实的采集方式:是不是采错了机器、时间窗口或工具版本。
- 拆分过粗的假设:“这次发布导致了问题”要拆成具体的改动。
- 合并过细的假设:每台主机各有各的原因,可能背后只是同一个可用区出了问题。
- 组合互补的假设:各解释一部分事实,且缺一不可。内存泄漏案例就是“进程级缓存 + 单次使用的状态机”的双重原因。
- 以上都不行,再提全新假设,并且只能基于现有事实。
渐进式信号发现
如果信号都太弱,就下潜一层,收集更底层的数据,一旦出现强信号就停下,目标是“最强”而不是“最深”。
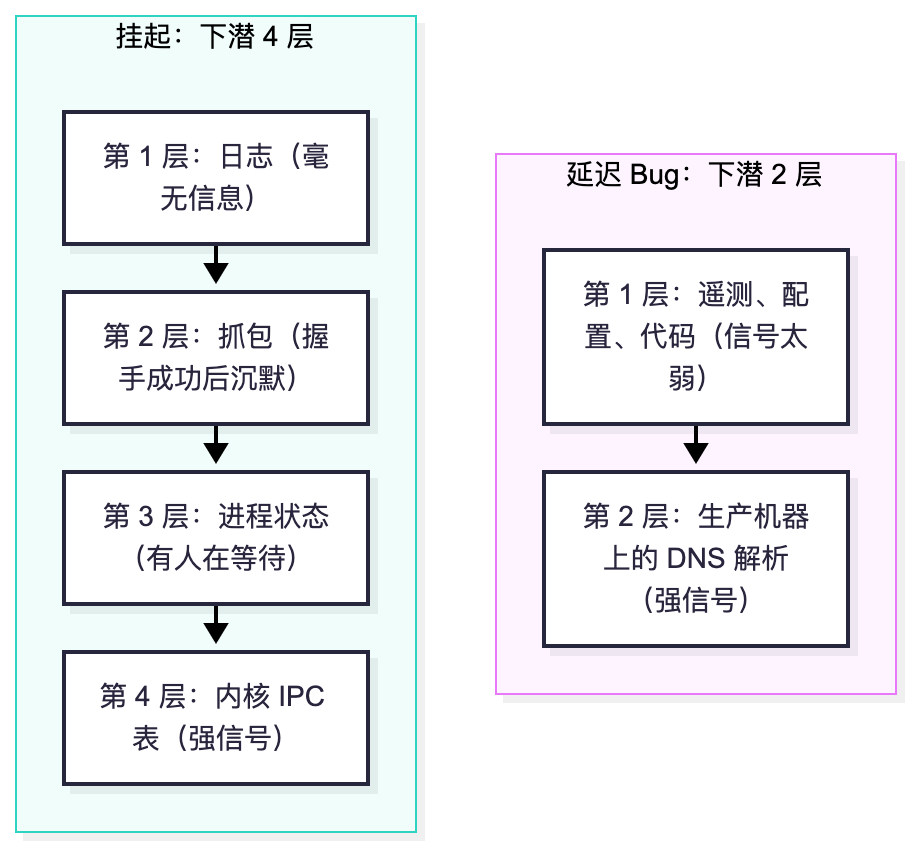
人类往往下潜一两层就放弃,而 Agent 不知疲倦,这正是它的优势所在。
两个大坑
坑一:Agent 的复现,要打折扣。
在“挂起”案例里,同事复现了问题:时钟偏差导致令牌被拒,守护进程不断重试,症状与用户反馈一模一样。但作者对比信号发现:抓包后半段与真实案例不同,内核 IPC 表里也没有那张“未回复的票据”。这是一个真实存在的 Bug,却不是用户遇到的那个。
复现本身属于推导层。先让复现产出与真实案例相同的强信号,才能认定它可信。
坑二:对抗式评审,是排除器而不是验证器。
对抗式评审无法保证事实层是完整的,而且用同一模型、同一上下文的评审者,很容易“一个观点算两遍”。更好的用法是让它去找反例、做排除,并要求每条结论附上证据引用。作者发现,被她追问的结论里,大约三分之一给不出引用,直接被剔除。
软件工厂该怎么改
作者的判断是:每一次人工干预,都意味着流程里有一个缺口。人工干预次数,是衡量一个“软件工厂”是否真正 Agent 原生的最诚实指标。
具体来说,有几个思维转变:
| 过去 | 未来 |
|---|---|
| 理解代码 | 设计验证回路(选对照、定约束、否决未验证的假设) |
| 读懂代码 | 采集事实(让 Agent 从正确的层、在正确的时机拿到数据) |
| 出事再临时采集 | 默认采集(强信号放在最浅的一层,如记录 DNS 解析次数) |
| 人当“肉体代理”复制粘贴 | 人做政策制定者,只处理有歧义、需担责的决策 |
| “你不会用”(技能问题) | 基础设施问题(让 Agent 默认就能严谨调试,而不依赖个人提示词) |
人和 Agent 的需求也不同:人想要更少的数据,所以有聚合、仪表盘;Agent 需要更多原始数据,聚合恰恰会毁掉信号的价值。因此要为 Agent 优化事实层,为人优化决策点。
此外,作者还坚持两点:
- “全栈装进一个盒子”依然是反模式。 本地环境无法还原生产的事实层,应该让 Agent 以只读、限时、可审计的方式,直接访问生产环境的信号。
- 调试框架可以复用到发布门禁。 如果预发环境检查过“客户端 DNS 解析数量与上次一致”,延迟 Bug 在小规模下就能被拦截。
小结
作者在文末给出了一个冷静的观察:模型在变强,工程师却未必同步变强。Agent 常常放大工程师的短板,不会调试的人,现在能更快地提交一个“看起来像修复”的非修复。
用速度换理解,这笔账总要有人来还。她的答案是:用对系统更高层次的理解,加上严格的验证流程,替代对每一行代码的理解。
参考资料
- 原文链接:Cindy Sridharan,How to effectively debug when you no longer understand the code - https://copyconstruct.medium.com/how-to-effectively-debug-when-you-no-longer-understand-the-code-bd3dcb2c5f7b
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。