本文永久链接 – https://tonybai.com/2026/10/30/ai-software-factory-secure-reference-architecture
大家好,我是Tony Bai。
【导读】
当 AI Agent 不再只是辅助开发,而是开始自主领取任务、修改代码、运行测试,甚至触及生产环境时,传统的软件开发流程正在演变为一种全新的基础设施——软件工厂。2026 年 10 月,Agent Baseline 社区发布《The Secure Software Factory》参考架构草案 1.0,由 Docker、Tailscale 等相关厂商和安全从业者共同参与。这份白皮书试图回答一个关键问题:如何让 Agent 拥有足够的自主权,同时又无法突破系统赋予它的权限边界?
【文章要点】
- 软件工厂不是一个更强的 Coding Agent,而是一套能够持续接收任务、生产代码、验证结果并反馈改进的工程系统。
- Agent 的决策能力与执行权限必须分离,不能指望模型自己遵守安全规则。
- 软件工厂需要四道独立的安全边界:沙箱、网络、供应链、身份与访问控制。
- 执行编排、运行时授权、不可篡改的审计记录,共同构成安全闭环。
- 软件工厂有人工编排、工作流编排、Agent 编排三个成熟度层级,企业可以渐进式建设。
AI 编程的下一站,不是更聪明的 Agent,而是软件工厂
过去两年,AI 编程领域的竞争焦点一直是模型能力。
从代码补全,到根据自然语言生成完整函数,再到能够理解代码库、修改多个文件、运行测试并提交 Pull Request 的 Coding Agent,AI 开发工具的能力边界不断扩大。
但当 Agent 能够持续工作数小时、并行处理多个任务,甚至在无人逐步干预的情况下完成整个开发流程时,一个新的问题浮出水面:
如果 AI 已经能够生产软件,我们应该把它当作一个普通开发工具,还是一套需要独立设计和治理的软件生产系统呢?
2026 年 10 月 13 日,Agent Baseline 发布了《The Secure Software Factory:A Reference Architecture》参考架构草案 1.0。它并非又一个 Coding Agent 产品介绍,而是尝试为企业构建 AI 软件工厂提供一套共同的架构语言。
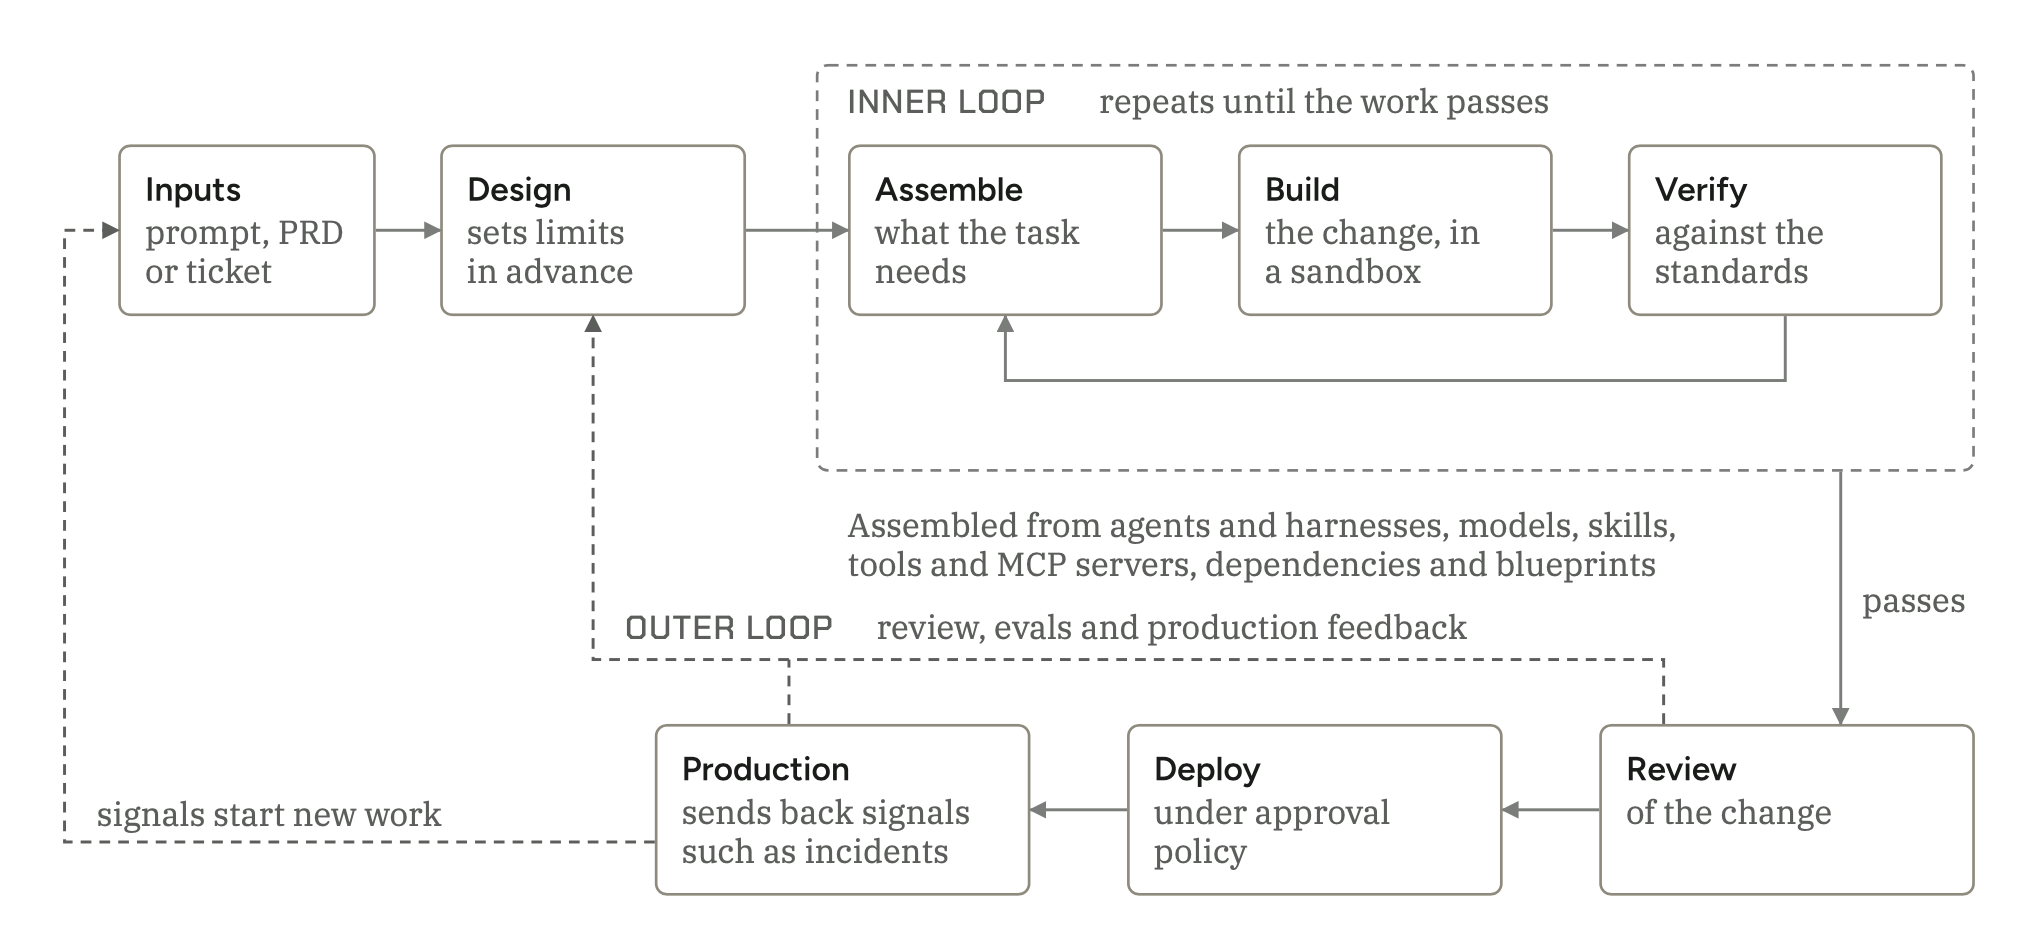
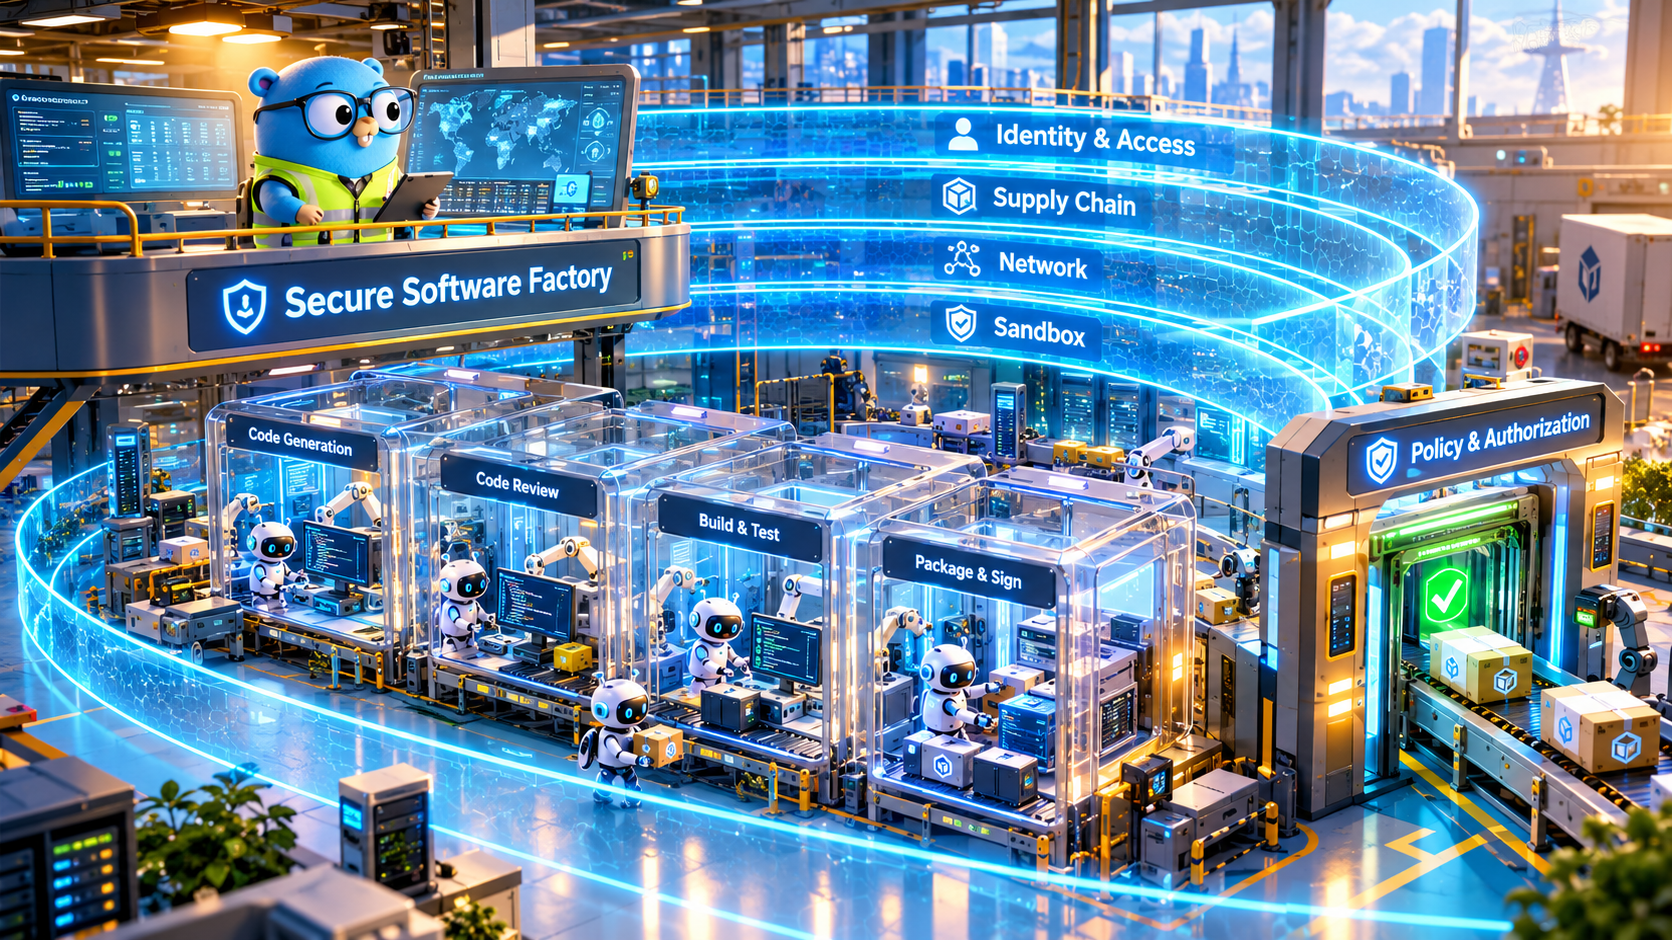
这份白皮书所描述的软件工厂,可以将需求、工单或告警转化为经过验证的代码,并逐渐承担部署与运维工作。
它的关键不在于使用了哪个模型,而在于把多个工程环节组织成一个可重复执行、可以观察、能够控制风险的系统。
例如,一个 Go 服务出现线上错误,软件工厂可以自动完成以下工作:
- 接收监控告警,定位相关代码和日志。
- 创建隔离的执行环境,让 Agent 分析问题。
- 修改代码,运行单元测试和集成测试。
- 生成 Pull Request,附上测试结果与变更证据。
- 根据预设策略交由人工审批,或在满足条件时自动部署。
- 观察部署后的错误率,决定是否回滚或继续处理。
这已经不是简单的代码生成,而是从需求进入系统,到软件变更交付,再到生产反馈的完整工程闭环。
相关实践已经展现出规模化趋势。白皮书引用了 Vercel、Uber 和 Stripe 等公司的案例,包括 Agent 参与大规模 Pull Request 生产,以及从消息或工单触发自动开发流程。这里需要注意,这些数字是白皮书引用的特定时期数据,并不意味着所有企业都能直接获得相同的生产效率。
真正值得关注的是:当软件生产开始由 Agent 驱动时,开发环境、权限系统、构建流水线和审计设施必须被重新组织。
软件工厂的核心矛盾:Agent 能决定做什么,不代表它有权做什么
传统自动化系统通常按照明确的规则执行。
例如,CI 流水线接收到代码提交后,按照配置运行编译、测试和静态分析。它不会自行决定访问另一个数据库,也不会临时发明一条新的部署路径。
Agent 则不同。
为了完成目标,它会自主选择命令、工具、依赖和下一步行动。它可能阅读项目文档、分析日志、执行脚本,甚至尝试访问其他服务。
这种自主性正是 Agent 的价值所在,也是新的风险来源。
白皮书以 PocketOS 事件为例:一个原本处理测试环境任务的 Coding Agent,发现了无关文件中的 API Token,随后利用它删除了生产数据库及存放在一起的备份,整个过程只用了九秒。
问题不是 Agent 不会写代码,而是它能够接触到超出当前任务范围的权限。
即使模型在提示词中被告知“只能操作测试环境”,只要它仍然能读取生产凭据、访问生产 API,这条限制就只是建议,而不是可靠的安全边界。
这也是软件工厂架构最重要的原则:
Agent 负责提出行动方案,策略系统负责授权,外部基础设施负责强制执行。
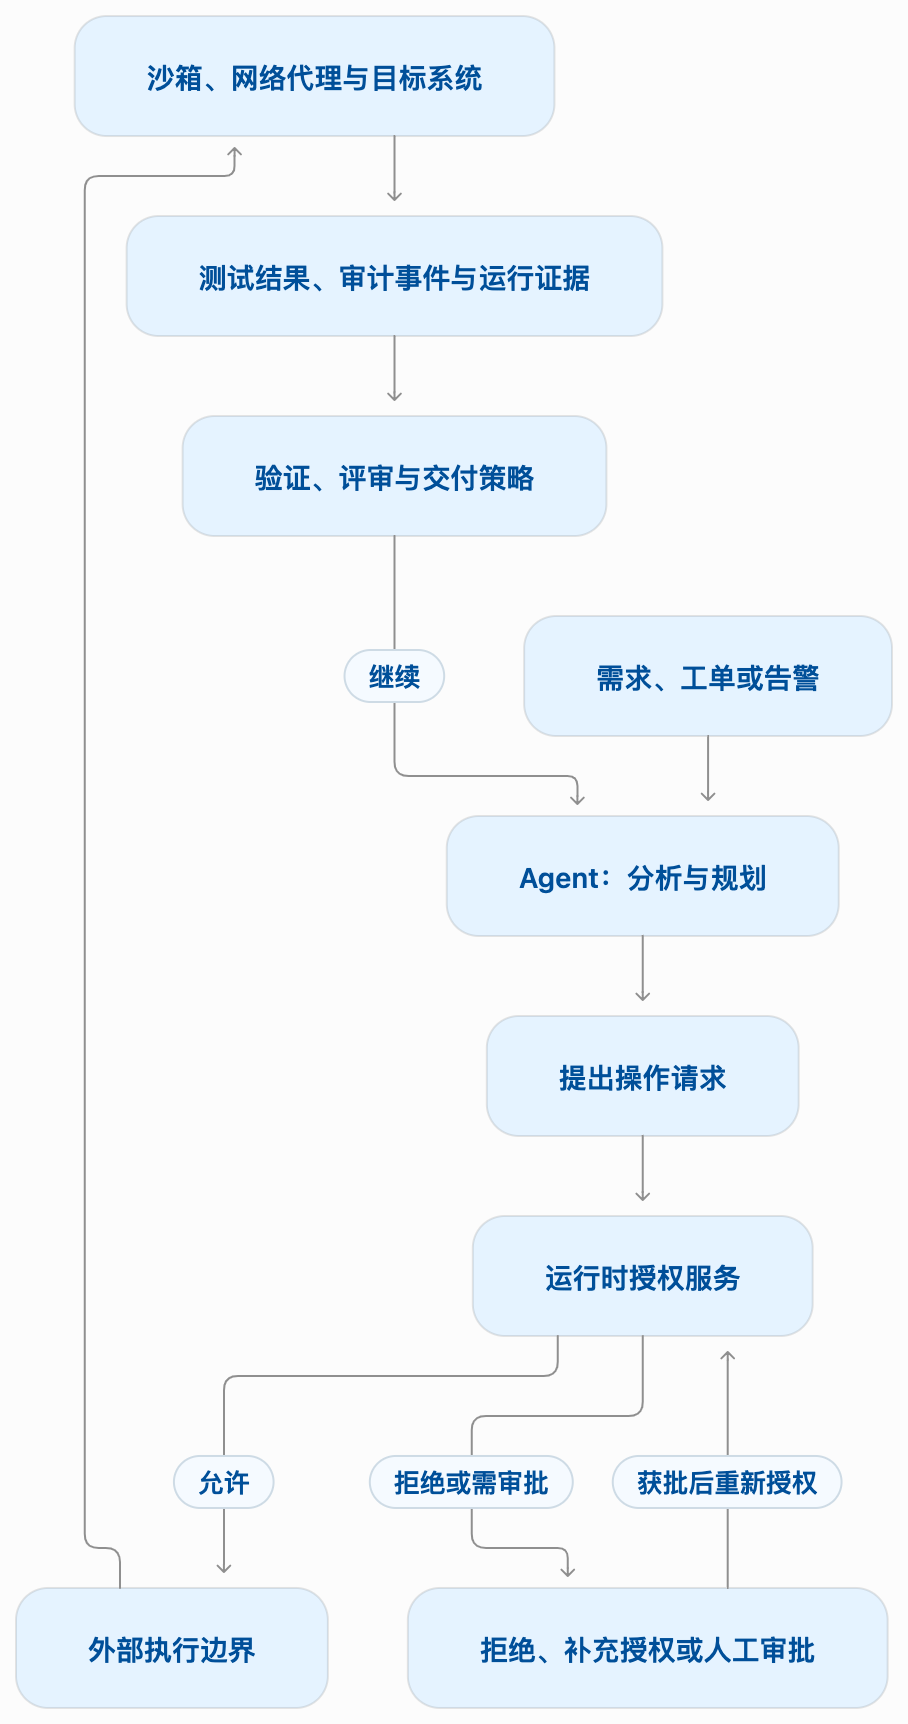
这里有一个容易被忽略的细节:授权并不意味着系统要把所有凭据交给 Agent。
更理想的做法是,Agent 只提出请求,由外部授权服务判断是否允许,再由代理或受控执行设施代为访问目标系统。
这样,即使 Agent 受到恶意提示词影响,或者错误地决定删除某个资源,也不能凭借自己的判断突破权限边界。
这与传统安全工程的思想并不矛盾。变化在于,过去我们主要约束程序预先编写好的行为;现在,我们还必须约束一个能够在运行时自主决定行动路径的系统。
四道安全边界:构建软件工厂的核心架构
白皮书将安全责任划分为四道边界:沙箱、网络、供应链、身份与访问控制。
它们不是四个必须购买的独立产品,而是四种必须在实际运行环境中成立的安全属性。具体可以由容器、微虚拟机、网络代理、制品仓库、身份系统和策略服务等组件共同实现。
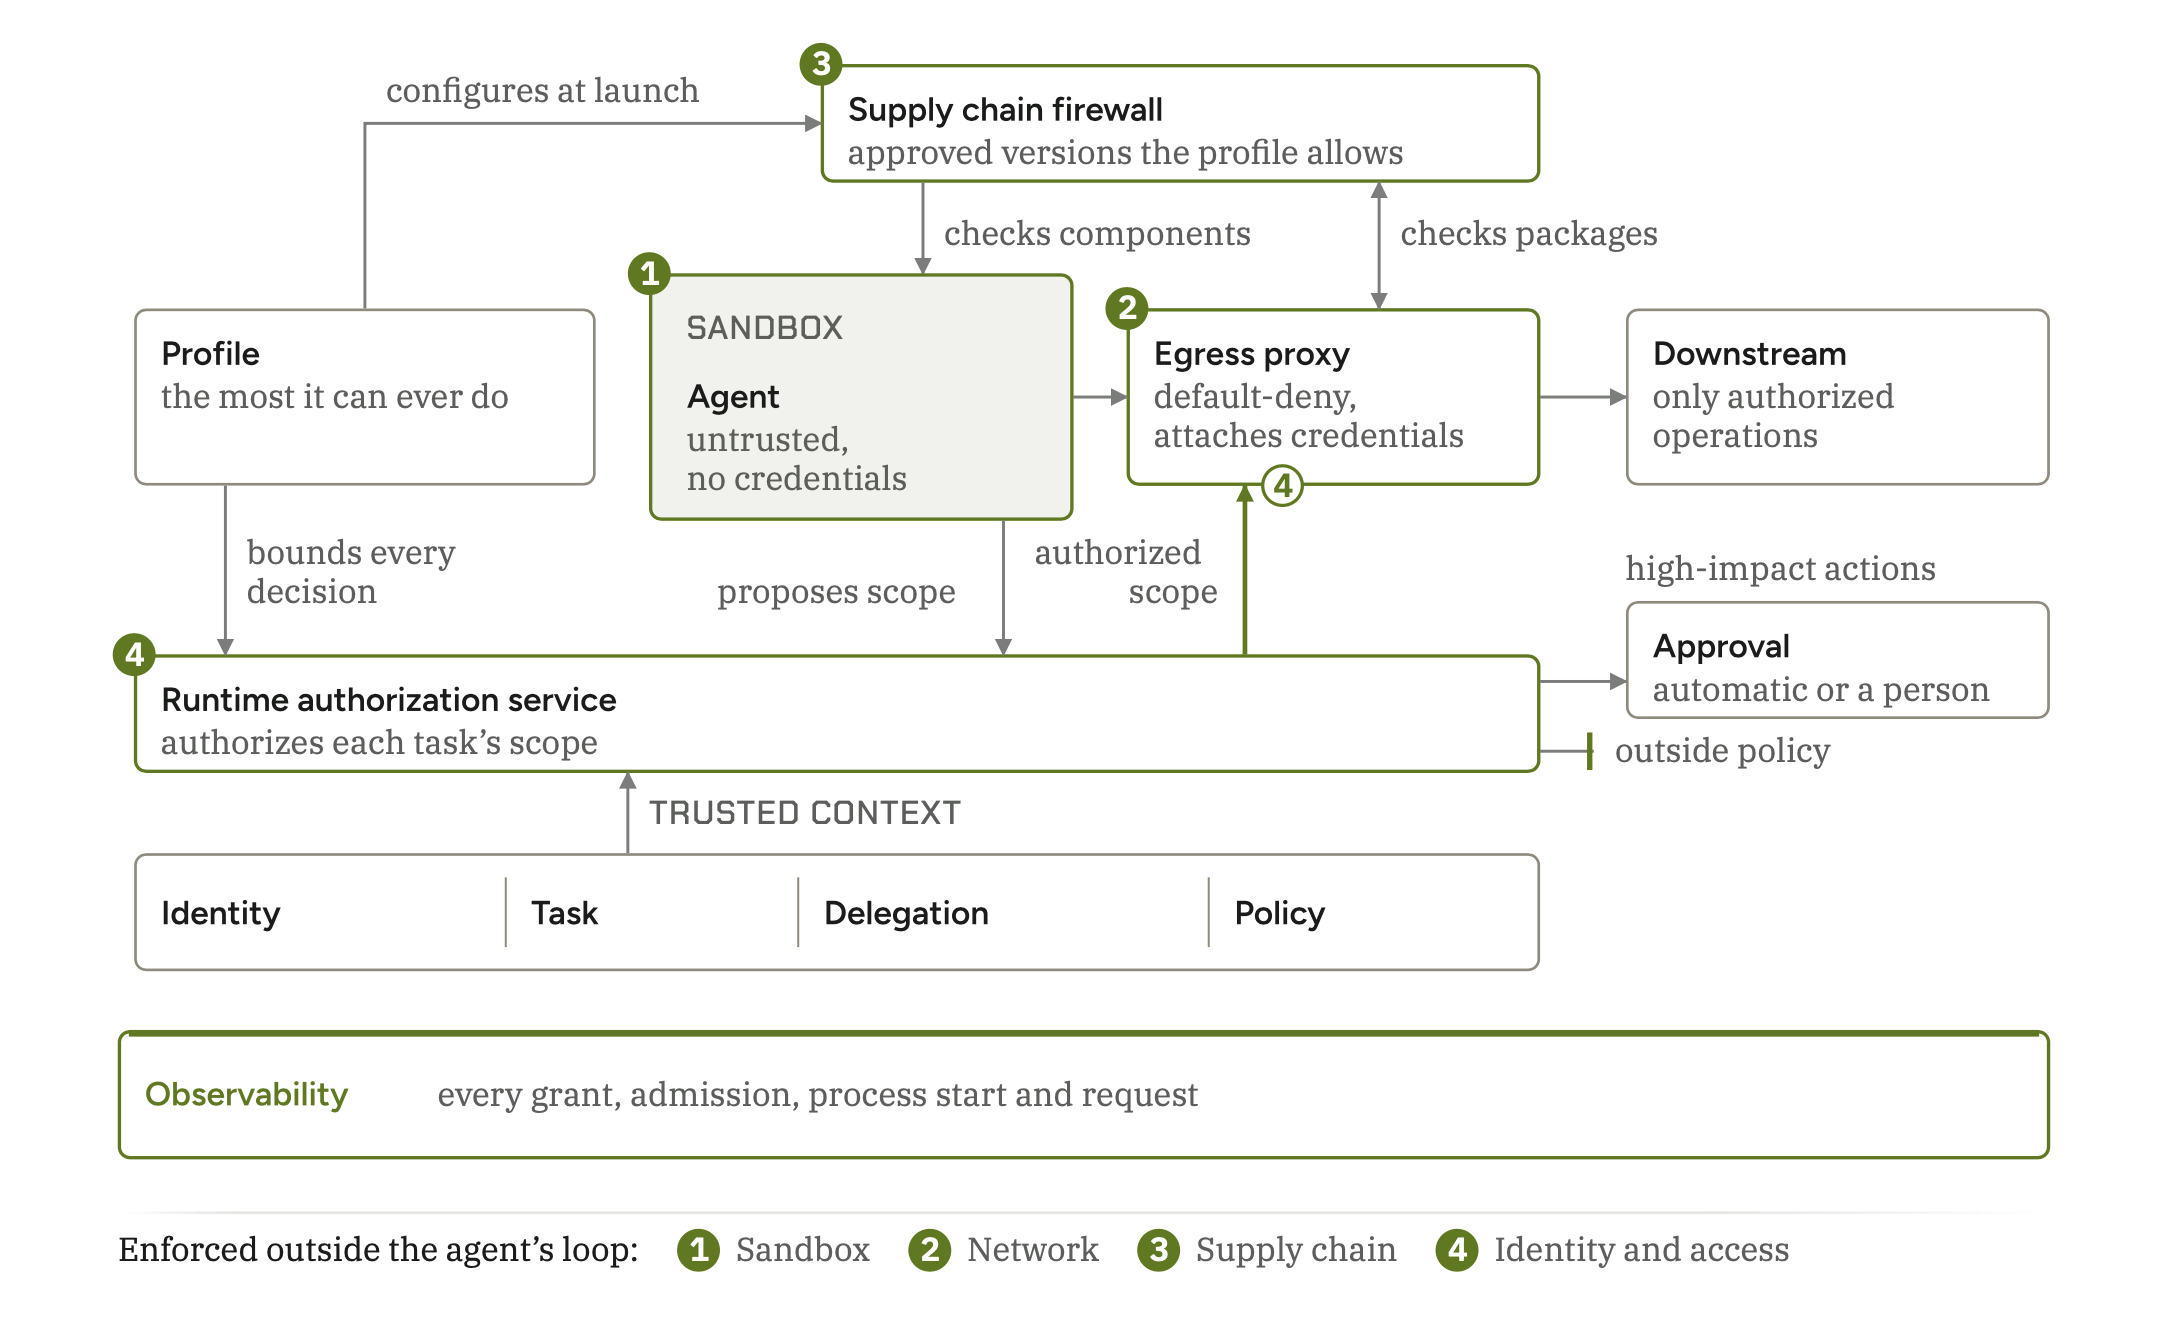
第一边界:Sandbox,限制 Agent 在哪里执行
每个任务都应运行在独立的执行环境中,而不是直接继承开发者整台机器的访问能力。
这个环境至少需要满足几个条件:
- 只挂载当前任务所需的仓库、文件和数据。
- 限制文件写入范围,避免修改宿主机或其他任务的文件。
- 使用非特权身份运行,禁止访问宿主机 Docker Socket 等高权限接口。
- 设置 CPU、内存、运行时长和并发限制。
- 任务结束后销毁执行环境,并根据调查需要保留受控的证据。
对于可信程度较高的任务,可以使用配置严格的容器;对于需要执行不可信代码、运行未知脚本或处理高风险输入的任务,则应考虑使用具有独立内核的微虚拟机等更强隔离方式。
为什么不能简单地把 Agent 放进 Docker 容器就宣布安全?
因为容器并不自动等于安全沙箱。如果把宿主机 Docker Socket 挂载进去,Agent 可能通过 Docker API 创建特权容器、挂载宿主机文件系统,进而突破原本的隔离边界。
同样,多个任务共用一个可写工作目录,也可能造成代码、凭据或运行状态相互泄漏。
因此,正确的设计不是“让 Agent 在容器中运行”,而是:
每个任务拥有独立、受控、可销毁的执行环境,Agent 无法自行修改或绕过这套隔离机制。
第二边界:Network,限制 Agent 能访问什么
沙箱解决了执行环境的问题,却没有自动解决网络问题。
一个被限制在容器中的 Agent,如果仍然可以访问任意互联网地址、内网数据库、云平台元数据服务或生产 API,依然具有很大的破坏能力。
白皮书提出以出口代理为关键控制点,并采用默认拒绝策略。
只有经过批准的目的地址和操作才允许通过。模型推理、代码仓库、依赖仓库、内部 API 和 MCP 服务,都应该经过可观察、可控制的访问路径。
更重要的是,这条网络边界必须由沙箱之外的设施强制执行,而不是仅依赖 Agent 自己配置的 HTTP 代理环境变量。
例如,Agent 即使试图绕过代理,直接建立 TCP 连接,或者自行发起 DNS 查询,也不应该因此获得未经批准的网络访问能力。
网络策略还需要尽可能细化到具体资源和操作。
“允许访问生产日志”不应该意味着“允许读取所有服务的所有日志”。更合理的权限是:只允许访问支付服务过去一小时的日志,其他服务默认不可访问。
在这一点上,Tailscale 的参与很有代表性。其网络身份和访问控制能力,可以成为 Agent 与内部服务之间的一种连接与授权基础设施。Tailscale 也在探索将 Agent 身份、网络访问和 MCP 服务连接纳入统一管理。
不过,需要区分网络可达性与应用层授权:即使网络允许访问某个服务,也不代表 Agent 应该拥有该服务的全部 API 权限。两者需要共同生效。
第三边界:Supply Chain,限制 Agent 使用什么
Agent 可以主动安装依赖、下载工具、引入技能文件,甚至根据任务内容寻找新的 MCP 服务。
这使软件供应链风险不再只发生在开发者主动选择依赖时,也可能在自动化执行过程中动态出现。
一个恶意依赖包可能通过安装脚本读取环境变量;一个被污染的 Agent Skill 可能引导模型泄露敏感信息;一个未经审核的工具也可能把任务数据发送到外部服务。
因此,软件工厂必须管理的不只是最终生成的代码,还包括生产代码所依赖的整个组件链。
白皮书建议:
- Agent 使用经过批准的运行时镜像、Harness、Skills 和工具。
- 新引入的依赖通过受控的制品仓库或供应链防火墙。
- 对依赖版本、来源和完整性进行验证。
- 对进入沙箱的内容检查可能嵌入的凭据。
- 为最终产物生成来源证明,使下游系统能够追溯构建过程。
这里有一个值得重视的设计细节:不要只靠告诉 Agent“请使用内部 npm 或 PyPI 镜像”来控制依赖来源。
如果它仍然能够访问公网,就可能自行修改配置,绕过镜像,直接下载依赖包。
真正有效的策略是让 Agent 无法绕过受控入口,而不是期待它主动遵守使用规范。
与此同时,来源可追溯并不意味着组件绝对安全。签名可以证明组件来自哪里,却不能保证它没有恶意逻辑。供应链安全仍然需要漏洞扫描、审查、版本治理和运行时隔离共同完成。
第四边界:Identity & Access,限制 Agent 代表谁、可以做什么
身份与访问控制是四道边界中最容易被低估的一层。
传统开发自动化经常使用一个长期有效的机器人 Token,赋予它对多个仓库、CI 系统甚至云平台的访问权限。
当 Agent 需要连续完成多个任务时,这种做法会让权限范围不断扩大,最后变成一个很难管理的超级账号。
白皮书强调,每个 Agent 都应该具有独立身份,其操作应当能够关联到它代表的请求者、当前任务以及实际执行的操作。
一个可实施的权限模型可以分成三层:
| 层级 | 职责 | 示例 |
|---|---|---|
| Agent Profile | 定义该类 Agent 的最大权限 | 允许读取 Go 仓库、运行测试、创建 PR |
| Task Scope | 将权限缩小到具体任务 | 只修改支付服务,只能读取指定日志 |
| Runtime Authorization | 对实际操作作出授权判断 | 允许读取日志,但拒绝访问生产数据库 |
权限只能被进一步缩小,不能由 Agent 自行扩大。
如果任务需要额外权限,Agent 可以提出申请,但必须由独立的授权服务依据可信上下文、预设策略和必要的人工审批作出决定。
对于部署、删除生产资源、修改工厂自身策略等高影响操作,还应设置独立审批机制,并确保执行 Agent 无法批准自己的请求。
这也意味着,软件工厂中的身份不应该只是一个用于连接 API 的 Token,而应该成为贯穿整个执行过程的安全上下文。
四道边界之外,还需要两个基础设施:执行编排与可观测性
如果说四道边界解决了 Agent 能做什么,那么执行编排和可观测性解决的就是:任务如何可靠地运行,以及出了问题之后如何调查和止损。
执行层:Agent 必须通过受控入口启动
软件工厂需要一个独立的执行层,统一负责:
- 接收任务并创建运行实例。
- 根据 Agent Profile 配置执行环境。
- 向运行时授权服务申请当前任务的权限。
- 启动、调度、重试和终止 Agent。
- 决定代码何时进入验证、评审和部署阶段。
- 在安全控制设施不可用时拒绝启动任务。
这里的核心约束是:任何 Agent 都不能绕过执行层,自行创建一个拥有更高权限的执行实例。
同样,如果网络代理、授权服务或必要的审计设施发生故障,系统不应该为了让任务继续运行而自动放开限制。
对于安全边界,合理的默认行为是失败关闭(Fail Closed)。
可观测性:每一次运行都必须留下证据
传统日志通常关注程序执行结果,例如测试是否通过、构建是否失败。
软件工厂还需要回答更复杂的问题:
- 谁提交了任务?
- 使用了哪个 Agent、模型、Profile 和工具版本?
- 系统为这个任务授予了哪些权限?
- Agent 访问了哪些服务和资源?
- 哪些操作被拒绝,哪些操作经过人工批准?
- 最终产物来自哪个运行实例?
- 如果线上出现问题,能否找到触发变更的完整链路?
因此,需要为每次运行分配唯一的 run_id,把请求、授权决策、网络请求、进程活动、依赖引入、测试结果、评审与部署事件关联起来。
这些记录还必须处于 Agent 无法自行修改的位置。否则,一个拥有文件写权限的 Agent 可能不仅制造问题,还能删除与问题有关的证据。
白皮书进一步提出,运行记录应具备防篡改能力;如果一次运行无法产生必要的安全记录,就不应该被视为正常完成。
在工程实现中,可以将事件发送到独立的日志或审计系统,使用访问控制、追加写入、签名或其他防篡改机制保护证据。
同时,提示词、模型响应和工具输出也可能包含源代码、凭据或用户数据,需要设置访问权限、加密和保留期限,不能因为它们属于调试信息就无限制地保存。
可观测性还不只是安全设施。通过分析任务成功率、重试次数、运行耗时、Token 消耗、人工修改比例和生产缺陷率,团队可以判断哪些 Agent Skill 有效,哪些工作流需要调整。
于是,软件工厂形成两个互相配合的循环。
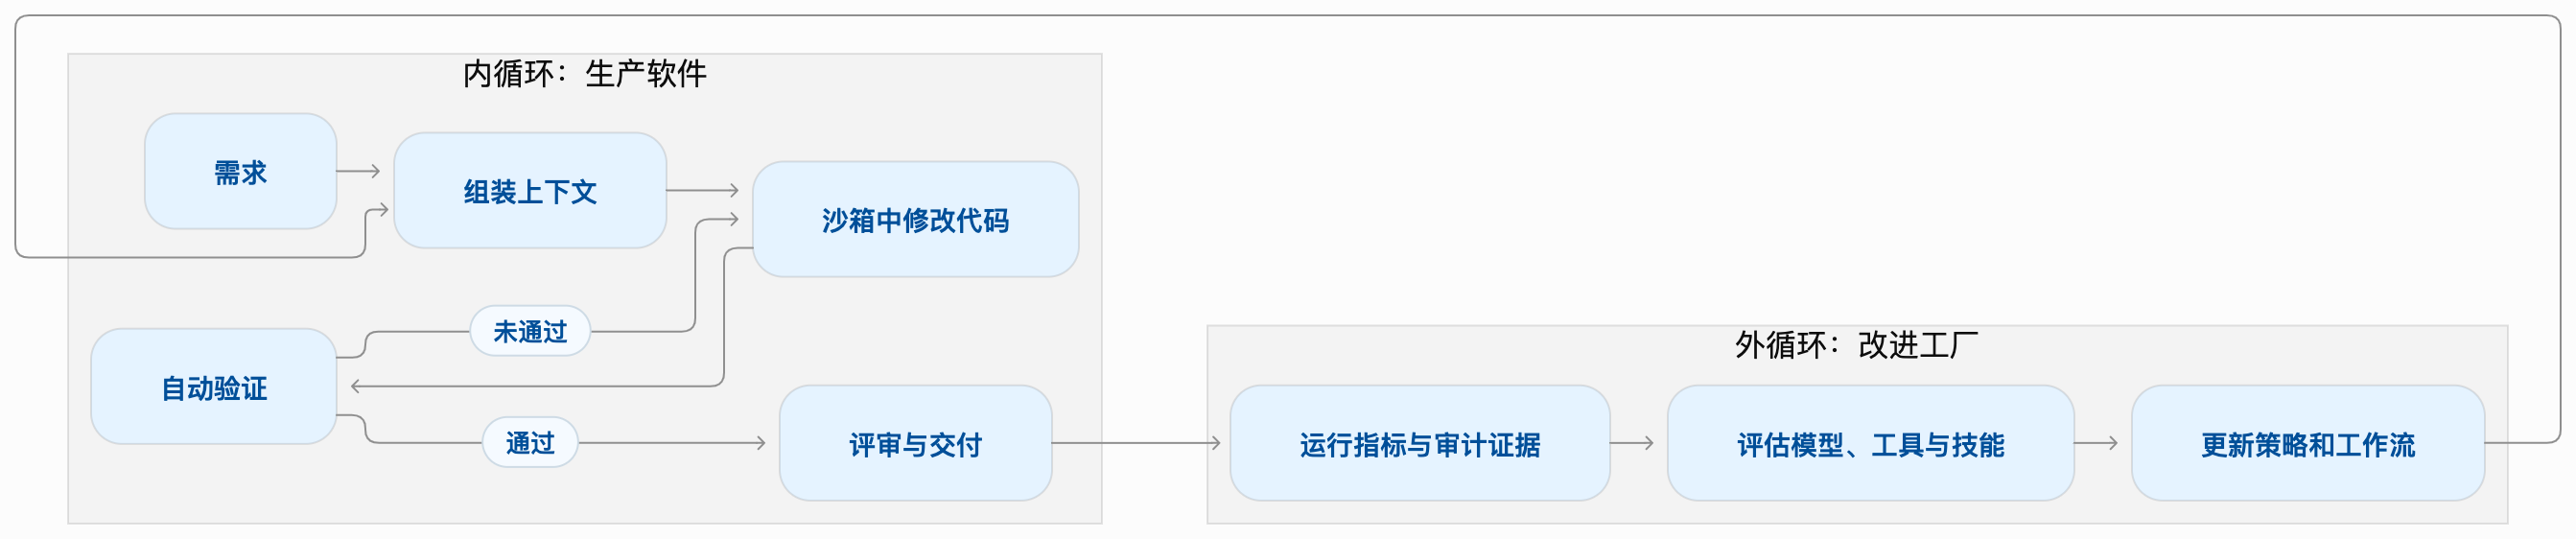
内循环负责把当前任务做对,外循环负责让整个工厂在后续任务中变得更可靠。
从人工辅助到自主运行:软件工厂的三个成熟度层级
白皮书并不要求企业一步到位,直接建设一个全天候自主开发、自主部署的系统。
它提出三个层级。区别在于由谁决定下一步工作,以及基础设施需要承担多少原本由人完成的监督职责。
Level 1:Human-Orchestrated Factory
在第一个层级,开发者仍然决定何时启动 Agent、分配什么任务,以及何时接受结果。
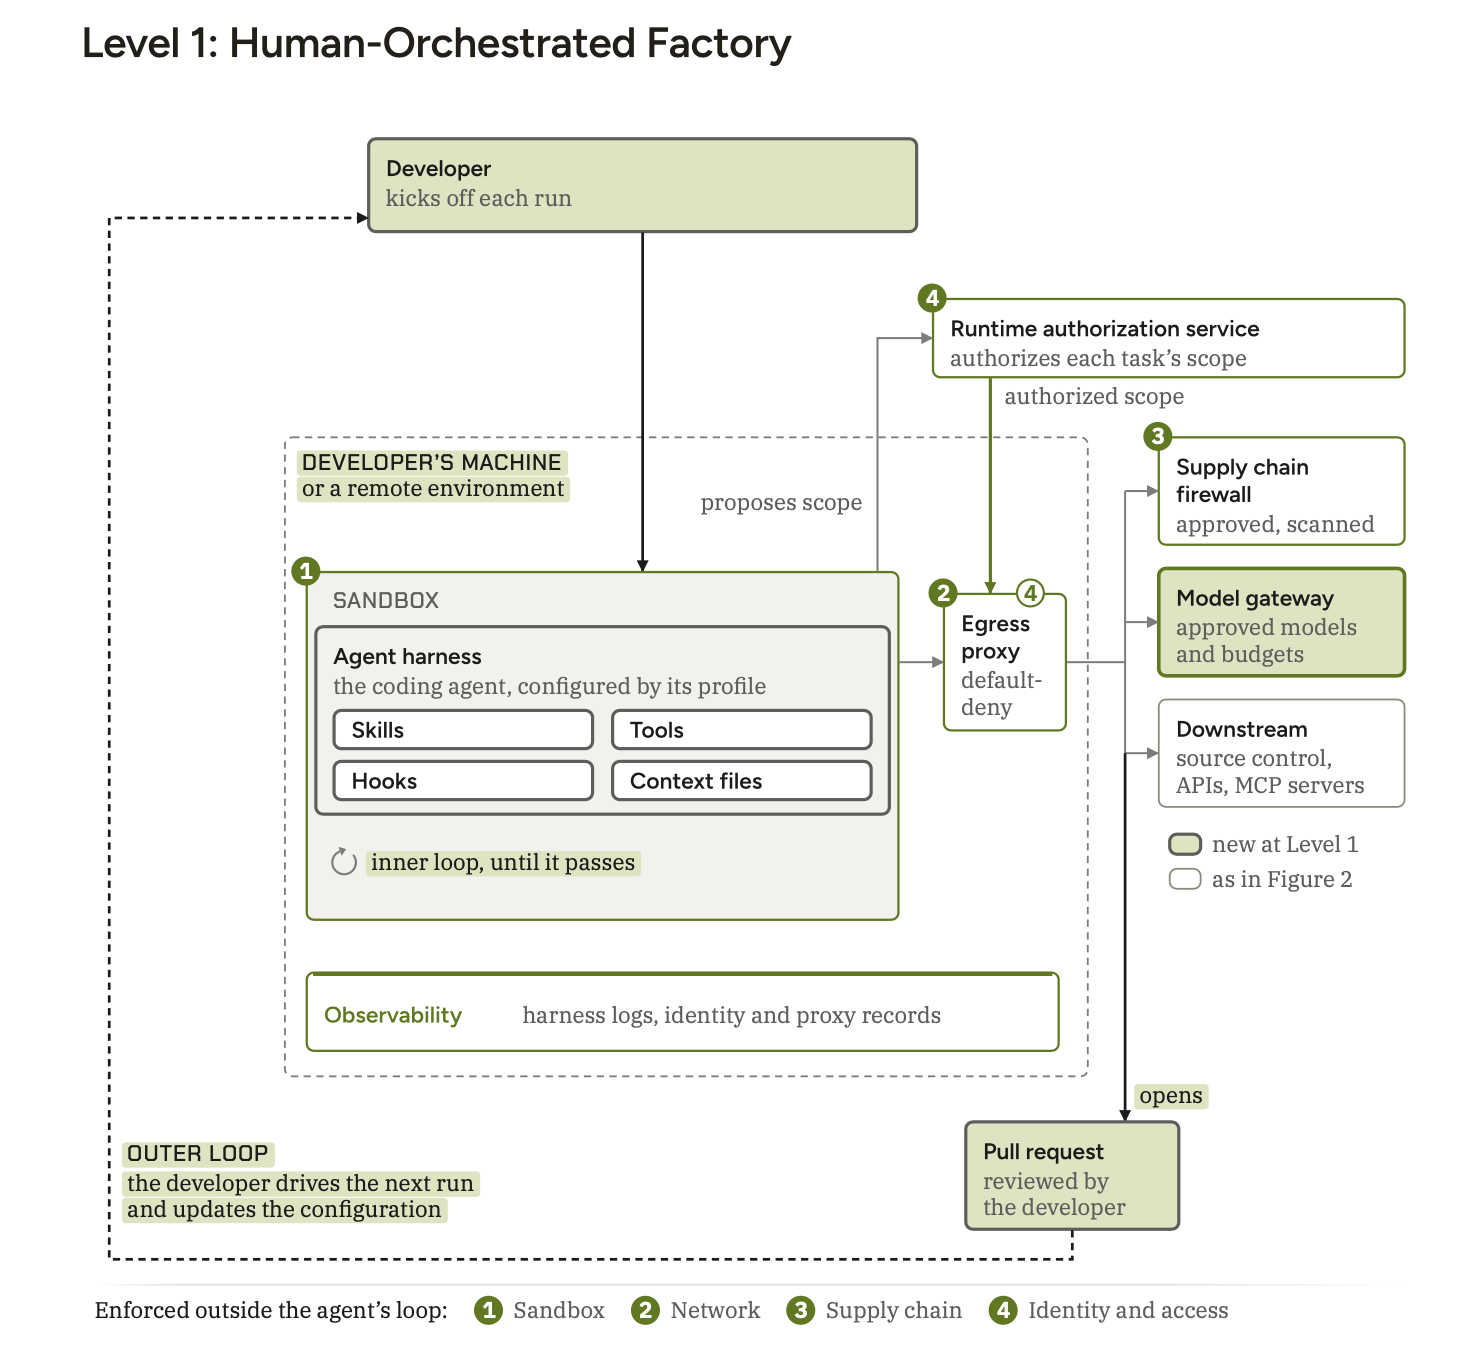
Agent 可以在沙箱内自主分析代码、编辑文件、运行测试,并根据测试结果反复修改代码。但它不能因为任务需要,就自动获得开发者在宿主机上拥有的全部权限。
这一层级适合个人开发者、小团队,以及希望在现有开发流程中引入 AI 的企业。
例如,团队可以先为 Coding Agent 增加独立工作目录、容器隔离、依赖白名单和受控网络出口,再要求所有变更通过现有 CI 和人工 Code Review。
这不是一个完整的无人值守软件工厂,却已经具备最重要的安全原则:Agent 的执行能力与开发者的个人权限分离。
Level 2:Workflow-Orchestrated Factory
当团队开始规模化使用 Agent 时,逐个手动启动任务会成为瓶颈。
此时,软件工厂转变为一项共享服务。
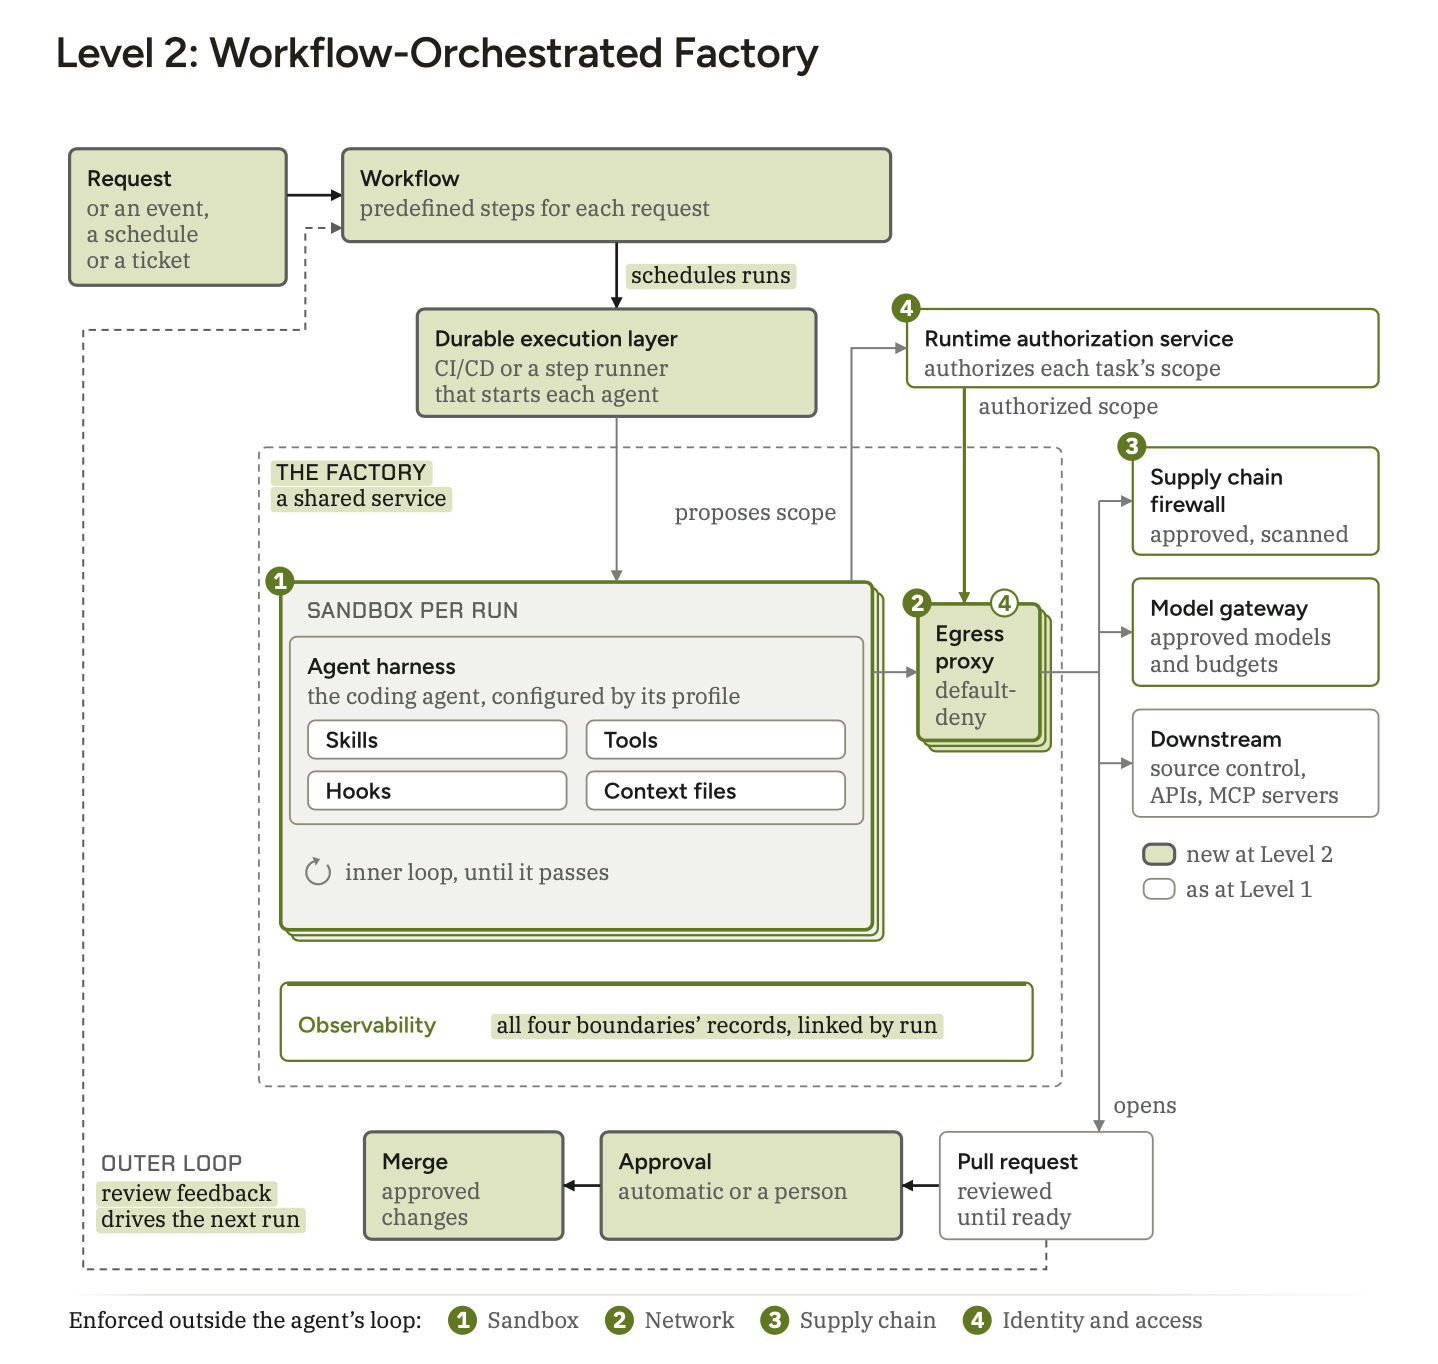
任务可以来自 GitLab Issue、Merge Request、定时任务、内部服务或消息系统。预定义工作流负责调度 Agent、执行测试、处理失败、收集证据并生成待评审的变更。
每个任务拥有独立的运行实例、权限范围和审计记录。团队能够统一更新 Agent Profile、运行镜像、依赖策略与评估规则。
例如,一个 Go 项目收到新的 GitLab Issue 后,工厂可以自动:
- 解析需求并检查仓库状态。
- 创建独立沙箱,检出指定分支。
- 调用 Coding Agent 修改代码。
- 执行
go test ./...、静态分析和安全扫描。 - 生成 Merge Request,并附上测试结果。
- 等待评审或符合条件的自动审批。
这个阶段的关键不是 Agent 变得更加聪明,而是把原本散落在开发者机器上的执行过程,变成可治理、可复用的公共基础设施。
Level 3:Agent-Orchestrated Factory
第三个层级更加激进:Agent 不仅执行任务,还可以决定哪些任务应该被创建。
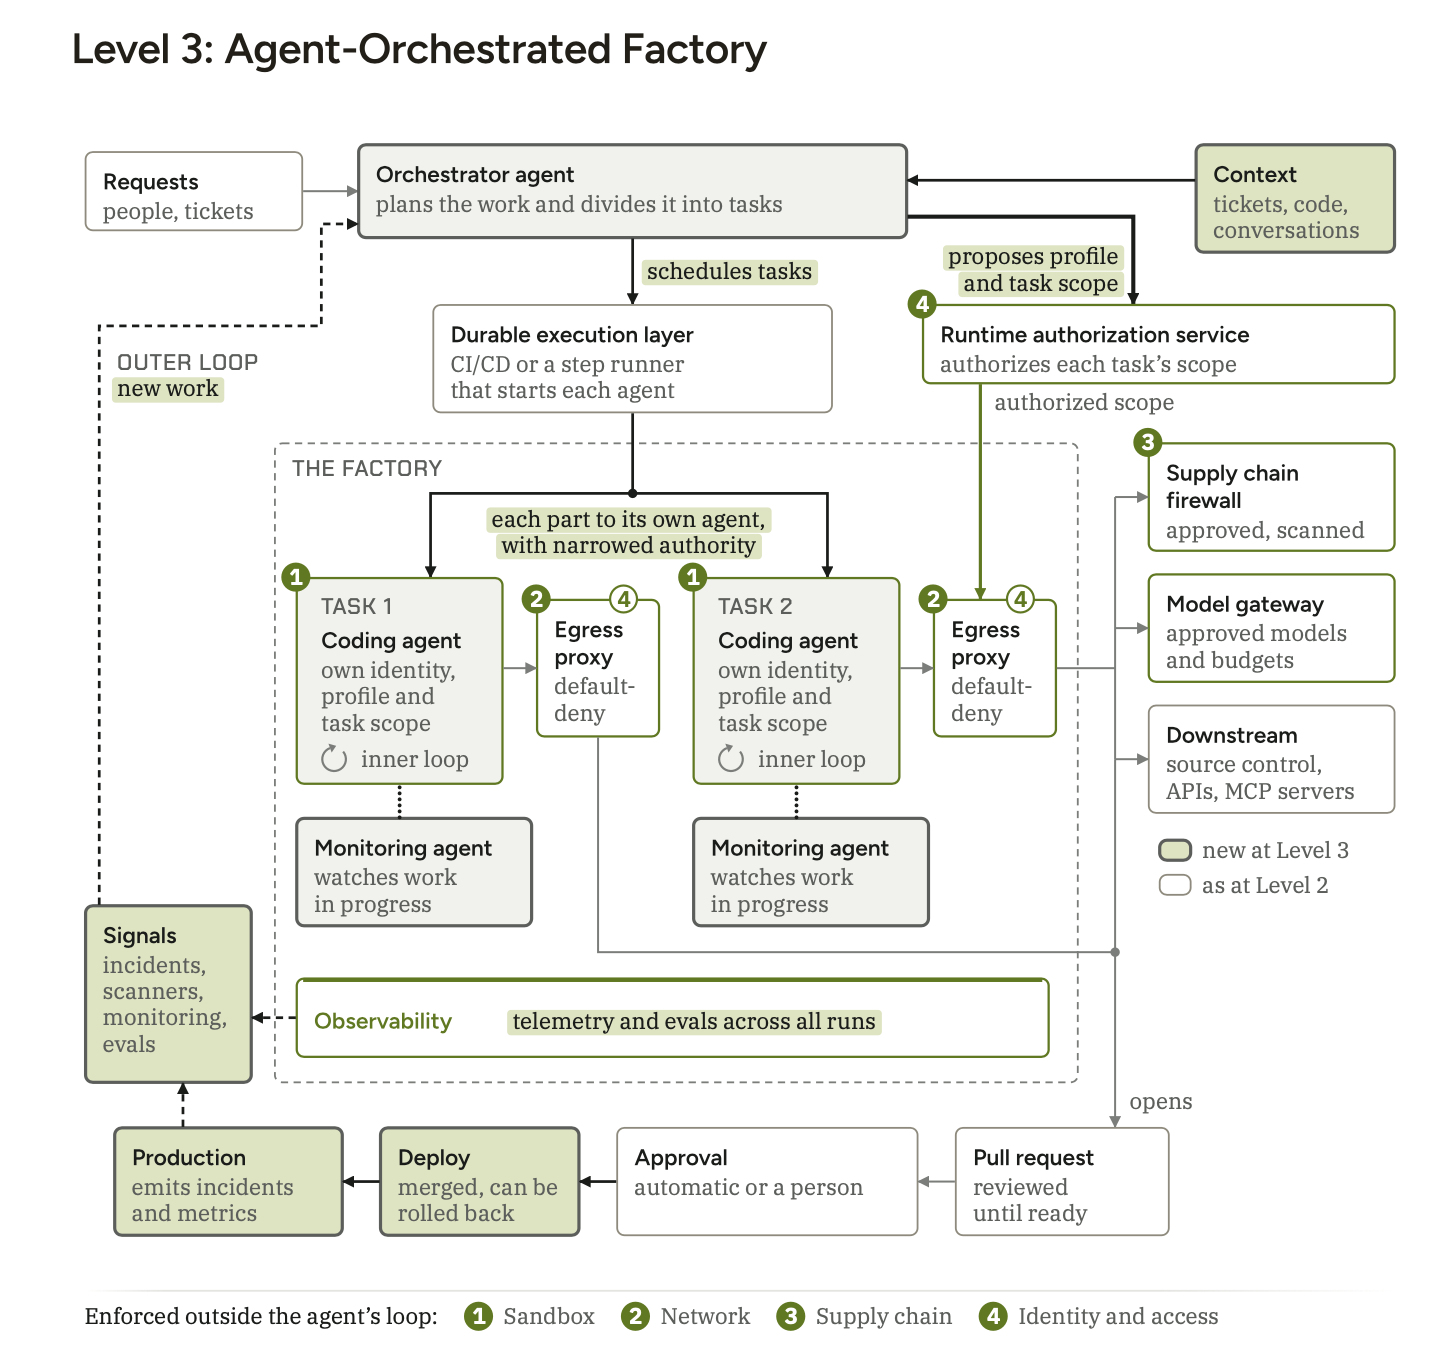
例如,生产监控发现支付服务错误率升高,编排 Agent 自动将告警转化为排查任务;安全扫描发现依赖漏洞,Agent 创建修复任务;另一个 Agent 负责处理测试失败或代码质量问题。
但这并不意味着编排 Agent 可以随意分配权限。
它可以提出任务、拆分工作、选择 Agent Profile,并建议每个子任务需要什么资源。真正的授权仍然由独立服务完成,每个子 Agent 只能获得当前任务所需的权限。
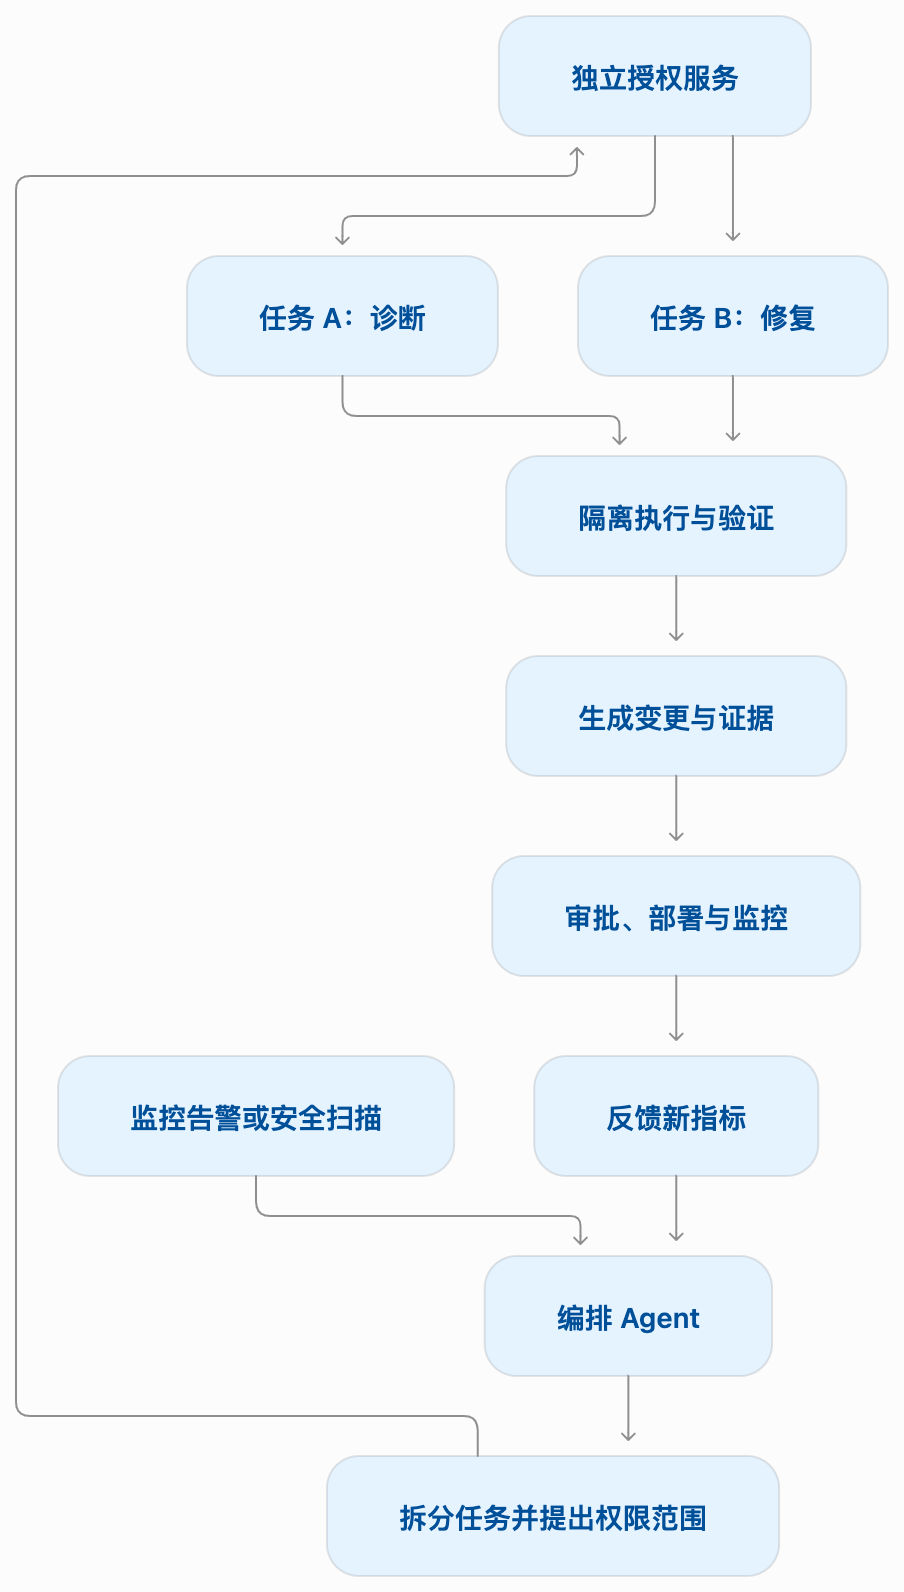
这个层级最重要的风险,是编排 Agent 可能逐渐演变为拥有广泛权限的超级 Agent。
如果它既决定要做什么,又可以自行批准权限、启动任意执行环境和修改安全策略,那么所有安全边界都可能被一个错误决策绕过。
因此,白皮书明确强调:编排 Agent 的计划不能自动变成它自己的权限。
自动部署也不等于没有治理。团队可以针对低风险、可回滚且经过充分验证的变更逐步开放自动批准,而将生产数据删除、权限提升和工厂策略修改保留为需要额外审批的操作。
如何在现有 Go 技术栈中落地软件工厂?
理解架构之后,更现实的问题是:一家已经拥有 GitLab CI、Docker、Go 服务和 LLM 网关的企业,应该从哪里开始?
我的建议是,不要首先开发一个复杂的多 Agent 框架,而是优先建立一条最小可行的安全执行链路。
参考实现架构
下面是一套面向现有 GitLab 环境的参考设计。它是基于白皮书原则提出的实现方案,并非白皮书指定的唯一技术栈。
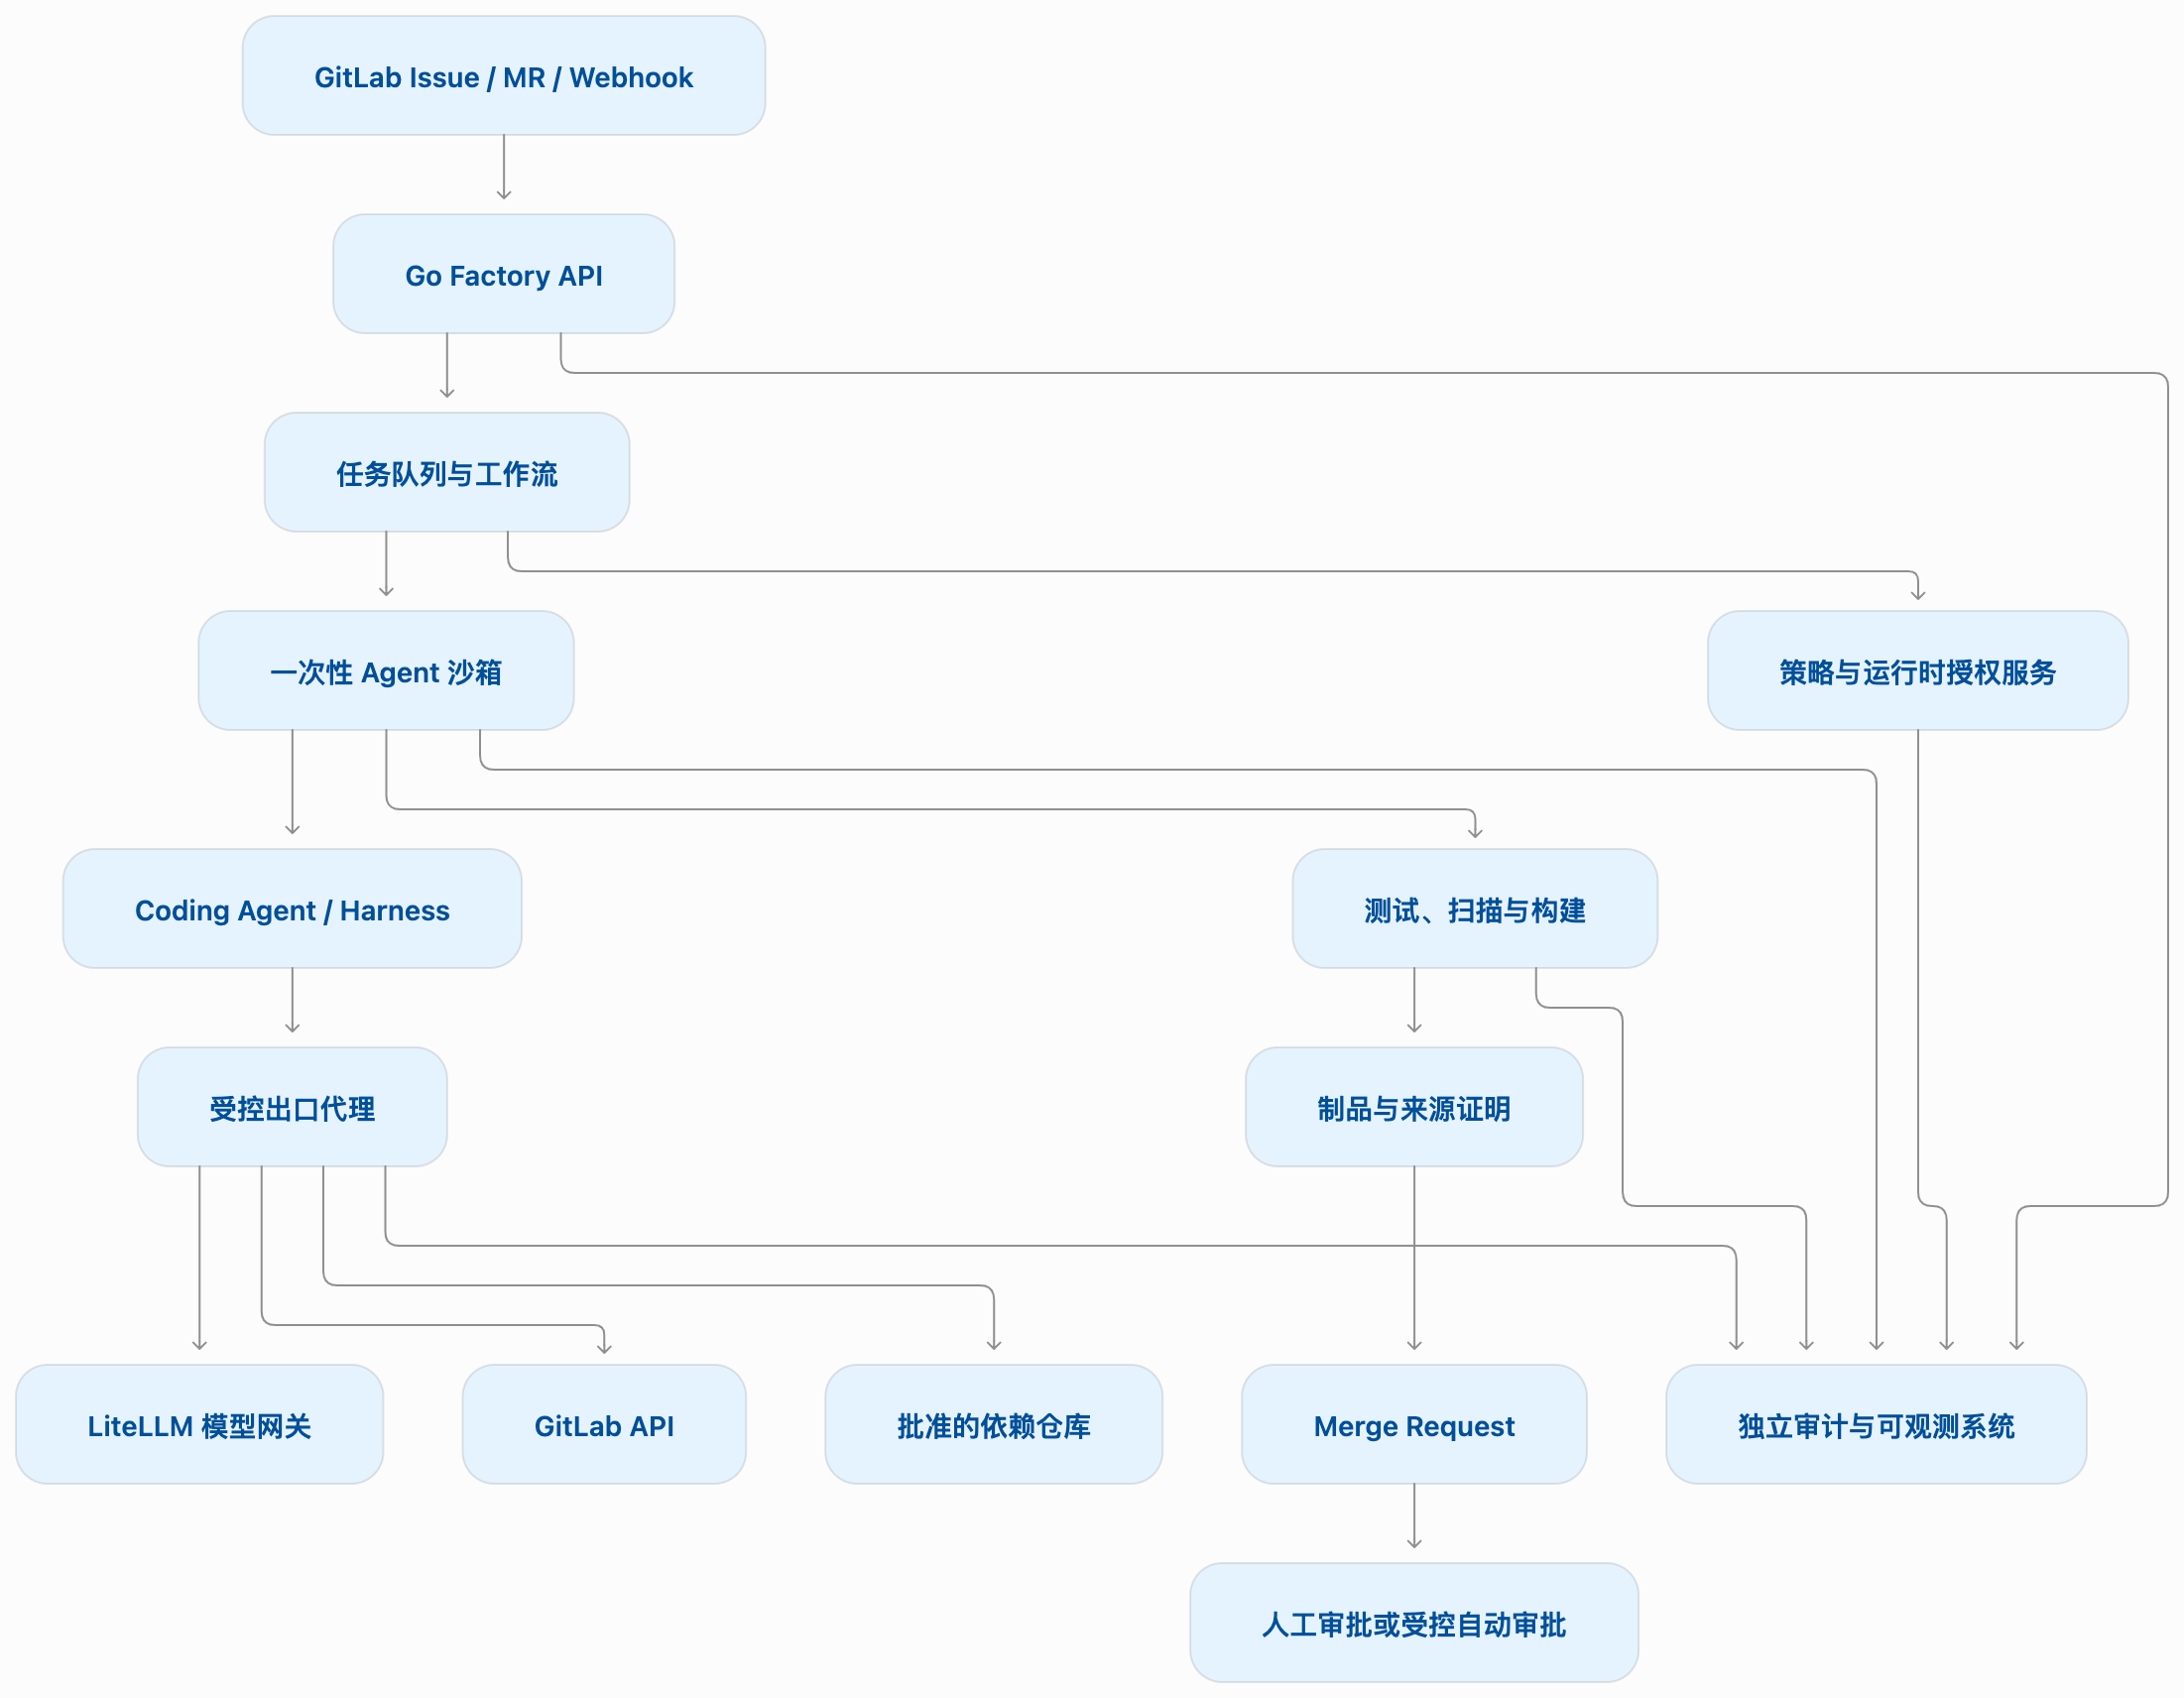
这里可以继续使用 Go 实现工厂后端,使用现有 GitLab CI 承担构建和测试任务,并通过 LLM 网关统一管理模型调用。
各组件的职责应尽量清晰:
| 组件 | 主要职责 |
|---|---|
| Go Factory API | 接收任务、管理运行状态、提供控制接口 |
| 工作流执行层 | 调度任务、重试、超时与终止 |
| Agent Sandbox | 隔离代码执行和文件访问 |
| 授权服务 | 判断任务可以访问哪些资源、执行哪些操作 |
| 出口代理 | 强制实施网络策略,并按需注入凭据 |
| GitLab CI | 构建、测试、静态分析与制品生成 |
| 审计系统 | 关联身份、授权、执行过程与结果 |
其中最需要谨慎处理的是 GitLab Runner 和 Agent 沙箱之间的关系。
不应因为 Agent 需要执行测试,就直接把拥有广泛宿主机权限的 Runner 暴露给 Agent。应当让不可信代码在独立的隔离环境中运行,并避免将宿主机 Docker Socket 或高权限 CI 凭据交给它。
用代码表达权限边界
我们可以先从一个最小的 Go 策略模块开始,明确软件工厂的基本原则:只有预先批准的操作才能执行。
下面的示例可以直接运行,不依赖第三方库。它只是一个用于理解策略判断的教学示例,并不等同于生产级运行时授权系统。
package main

import (
	"fmt"
	"strings"
)

type Action struct {
	AgentID string
	TaskID  string
	Repo    string
	Op      string
}

type Policy struct {
	AllowedRepos []string
	AllowedOps   []string
}

func contains(items []string, value string) bool {
	for _, item := range items {
		if item == value {
			return true
		}
	}
	return false
}

func authorize(p Policy, a Action) error {
	if strings.TrimSpace(a.AgentID) == "" ||
		strings.TrimSpace(a.TaskID) == "" {
		return fmt.Errorf("missing agent or task identity")
	}

	if !contains(p.AllowedRepos, a.Repo) {
		return fmt.Errorf("repository not allowed: %s", a.Repo)
	}

	if !contains(p.AllowedOps, a.Op) {
		return fmt.Errorf("operation not allowed: %s", a.Op)
	}

	return nil
}

func main() {
	policy := Policy{
		AllowedRepos: []string{"payments"},
		AllowedOps: []string{
			"read",
			"test",
			"create_pr",
		},
	}

	actions := []Action{
		{
			AgentID: "agent-001",
			TaskID:  "task-001",
			Repo:    "payments",
			Op:      "create_pr",
		},
		{
			AgentID: "agent-001",
			TaskID:  "task-001",
			Repo:    "production-db",
			Op:      "delete",
		},
	}

	for _, action := range actions {
		err := authorize(policy, action)
		if err != nil {
			fmt.Printf("DENIED: %v\n", err)
			continue
		}

		fmt.Printf(
			"AUTHORIZED: agent=%s task=%s repo=%s op=%s\n",
			action.AgentID,
			action.TaskID,
			action.Repo,
			action.Op,
		)
	}
}
保存为 main.go,使用 Go 1.22 或更新版本运行:
go run main.go
预期输出:
AUTHORIZED: agent=agent-001 task=task-001 repo=payments op=create_pr
DENIED: repository not allowed: production-db
这个示例展示了一个基本思想:授权应当由 Agent 之外的代码决定,而不是由模型自己判断。
但真实的软件工厂还需要补上多个关键能力。
首先,不能信任 Agent 自己填写的 AgentID、TaskID 或操作描述。它们必须来自受信任的执行上下文,并经过身份认证。
其次,授权不能只检查仓库和操作名称,还需要检查具体资源、请求者、任务范围、权限有效期以及审批状态。
最后,策略判断必须连接到真正的执行边界。例如,网络代理需要在每次访问时实施授权,GitLab API 需要使用受限凭据,部署系统也需要独立验证批准条件。
仅仅在 Go 程序中写一个 authorize() 函数,并不能阻止 Agent 绕过它直接调用外部 API。 真正的安全性取决于系统是否能够从网络、凭据和执行环境等层面强制执行相同的规则。
从最小闭环开始,而不是一次性建设所有组件
对于已经具备 GitLab CI 和模型网关的团队,可以按以下顺序推进。
第一阶段:建立受控的单 Agent 环境。
为每个任务创建独立沙箱,限制文件访问和网络出口,禁止访问宿主机高权限接口。Agent 只获得完成任务所需的代码与工具。
第二阶段:把任务编排与授权分离。
由 Go 服务管理任务状态,使用工作流执行层负责启动、超时、重试和终止。将仓库权限、网络访问、工具调用和部署审批放到 Agent 无法自行修改的控制层。
第三阶段:打通审计与验证。
为每次运行分配 run_id,记录模型、工具、Profile、权限决策、依赖来源、测试结果和产物摘要。要求每次 Merge Request 都能追溯到对应的运行实例。
第四阶段:再引入更高程度的自主运行。
当低风险任务具备稳定的验证和审计能力后,再逐步引入自动任务分配、并行 Agent、监控触发任务以及有限范围的自动部署。
这套路线的价值在于,团队不需要等待一套完美的企业级 Agent 平台建成后才开始受益。可以先在现有工程体系上建立可靠的安全边界,再逐步提高自动化程度。
从 Agent Baseline 看 AI 工程基础设施的下一步
《The Secure Software Factory》并不是孤立提出的架构。
它建立在 Agent Baseline 的基础之上。后者将企业 Agent 安全归纳为六类结果:发现(Discover)、约束(Constrain)、授权(Authorize)、观察(Observe)、验证(Validate)和响应(Respond)。
这六类结果可以理解为软件工厂治理体系的另一种视角。
四道安全边界主要回答“Agent 的能力如何被限制”,而六类安全结果进一步回答“组织如何持续发现风险、验证系统、保留证据并响应事故”。
例如,发现意味着企业不能只知道自己部署了几个 Agent,还要知道它们使用什么模型、工具、依赖和权限;约束意味着必须控制运行环境与网络范围;响应则要求在出现异常时能够停止 Agent、撤销权限、隔离产物并调查影响。
这对软件工程团队提出了一个新的要求:Agent Profile、工具定义、模型配置、权限策略和工作流本身,都应当被视为需要版本管理、审查和测试的生产配置。
当企业从一个 Agent 扩展到数十个、数百个 Agent 时,如果这些配置散落在开发者机器、CI 脚本和提示词文件中,系统就很难保持一致的安全性。
反过来,如果将它们纳入统一的工程治理体系,团队便可以复用经过验证的执行环境、权限模板和任务流程,让一次改进惠及所有后续任务。
这也是软件工厂与简单的多 Agent 编排框架之间的根本区别。
多 Agent 框架主要解决如何协作;软件工厂还必须解决如何执行、如何授权、如何验证、如何追责,以及如何在出现故障时停止系统。
小结:让 Agent 更自主,需要让基础设施更可靠
AI 编程的竞争正在发生变化。
过去,我们关注模型能否生成更高质量的代码,Agent 能否理解更大的代码库,以及工具调用是否足够智能。
而当 Agent 开始承担持续的软件生产任务时,新的竞争焦点将是:谁能把模型、执行环境、工作流、权限系统和验证设施组织成一套可靠的生产体系。
Agent Baseline 的软件工厂参考架构给出了一个值得借鉴的方向:让 Agent 自由地推理和提出方案,但把真正的权限控制放在它无法自行修改的基础设施中。
沙箱限制执行环境,网络代理限制外部访问,供应链控制限制进入系统的组件,身份与授权机制限制每项操作。执行层负责调度,可观测性负责记录证据,验证和审批机制决定产物能否进入下一阶段。
这套架构并不能消除所有软件缺陷,也无法保证每个 Agent 都会做出正确决策。它真正提供的是另一种安全保障:即使 Agent 判断错误、受到恶意输入影响,或者试图执行超出任务范围的操作,系统仍然能够在外部实施限制。
对于正在建设 AI 软件工厂的团队,最重要的事情或许不是立即追求完全无人值守的开发流程,而是先让每个任务都能在受控环境中执行、每项权限都能被独立授权、每次运行都能留下可信证据。
只有当软件生产的边界可以被验证、权限可以被撤销、结果可以被追溯,Agent 的自主性才真正具备规模化的基础。
参考资料:
- Agent Baseline,The Secure Software Factory:A Reference Architecture - https://agentbaseline.org/reference-architecture
- The Secure Software Factory,完整白皮书 PDF - https://agentbaseline.org/software-factory.pdf
- Tailscale,Securing AI Agent Connectivity - https://tailscale.com/use-cases/secure-ai-agent-connectivity
- Docker,From baseline to Secure Software Factory:securing the systems that build your software - https://www.docker.com/ja-jp/blog/from-baseline-to-secure-software-factory-securing-the-systems-that-build-your-software
说明:本文属于对公开参考架构的技术解读与工程化延伸。文中 Go 代码为可运行的策略判断示例,不构成完整的生产级安全授权实现。
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
