本文永久链接 – https://tonybai.com/2026/11/17/rust-ai-borrow-checker-appeasement-debt
大家好,我是 Tony Bai。
【导读】
Rust 诞生的一个重要使命,就是解决 C/C++数十年来积累的内存安全、资源管理和并发编程问题。
它通过所有权、借用检查器和类型系统,将许多过去只能依靠程序员自觉遵守的规则,变成了编译器强制执行的约束。
但一个有趣的现象正在出现。
当 AI 编程 Agent 开始大规模生成 Rust 代码时,一种新的技术债可能正在悄悄形成:AI 为了让代码通过借用检查器,不惜牺牲程序原本应该具备的架构、性能和可维护性。
最近,Reddit 的 r/rust 社区出现了一篇引发热议的帖子。
一位开发者审计了一个由 Claude 将 TypeScript 游戏引擎迁移到 Rust 的项目。代码不仅成功编译,还通过了全部 3,091 个确定性回放状态哈希检查。
然而,深入审查后,他发现了一个令人震惊的事实:这个 Rust 程序为了满足编译器,竟然在热循环中反复 Clone 数据、使用 std::mem::take 转移状态,甚至在视频渲染管线中不断复制完整的图像缓冲区。
最终,一个 12,349 行的 Rust 文件诞生了。
作者将这种现象称为:
Borrow-checker appeasement debt——借用检查器迎合型技术债。
这不仅仅是一个 Rust 代码质量问题。它揭示了 AI 编程时代一个值得警惕的新趋势:AI 可以非常擅长解决局部问题,却未必真正理解系统设计的整体目标。
当我们把代码交给 AI 时,如果只关注编译通过、测试通过和功能正确,那么我们可能正在以惊人的速度生产满是“技术债”的下一代遗留系统。
【文章要点】
- 看似完美的迁移假象:Claude 将 1.2 万行 TypeScript 游戏引擎重写为 Rust,代码顺利编译且通过了全部 3,091 个确定性状态哈希检查,表面没有任何功能瑕疵;
- 迎合编译器的架构变形:为了消除借用冲突,AI 放弃了合理的数据解耦,把 19 个独立类强行压扁塞入单一 12,349 行的巨型 game.rs 文件中;
- 以性能为代价讨好检查器:AI 在模拟热循环中调用了 175 次 .clone(),滥用 std::mem::take 转移状态,甚至在视频渲染中每帧无脑深拷贝完整图像缓冲区(产生 5.9GB 堆分配与近 4000 个系统线程);
- 重构换来数倍性能暴增:人类工程师通过拆分 3 个 Crate、细化状态结构与复用缓冲区,在保持测试 100% 通过的前提下,模拟速度提升 1.9 倍、渲染提速近 3 倍、编译检查耗时锐减 90%;
- 警惕技术债生产自动化:编译通过与测试全绿不等于架构合理,AI 时代软件工程必须从单纯的功能验证转向目标驱动、架构硬约束(如 AGENTS.md)与多上下文独立审查。

Rust 想解决 40 年的技术债,AI 却带来了新问题
C++ 是一门非常成功的系统编程语言。
但它的成功也伴随着长期的历史包袱。
手动内存管理、悬垂指针、内存泄漏、数据竞争、复杂的对象生命周期……这些问题长期困扰着 C/C++开发者。
Rust 试图从语言设计层面改变这一切。
它引入了所有权(Ownership)、借用(Borrowing)和生命周期(Lifetime)等机制,让编译器能够在编译阶段检查大量潜在的内存安全问题。
这背后其实是一种很重要的设计哲学:
与其要求程序员永远正确地管理复杂状态,不如让语言和编译器从机制上限制错误发生的可能性。
Rust 的借用检查器正是这种哲学的代表。
例如,当一个结构体拥有某个数据时,其他代码不能随意创建相互冲突的可变引用。开发者必须认真考虑数据由谁拥有、谁可以访问,以及状态如何在不同组件之间流转。
这不仅是内存安全机制,也在一定程度上推动了程序架构的合理设计。
然而,AI 编程 Agent 的出现,带来了一个意想不到的反转。
AI 能够快速生成 Rust 代码,也能够不断修改代码,直到编译器不再报错。
但它有时选择的并不是最合理的架构,而是最容易消除当前编译错误的局部方案。
如果一个结构体的借用关系设计得不合理,优秀的 Rust 开发者通常会考虑拆分结构体、重新组织数据所有权,或者调整整个状态管理模型。
而 AI 可能直接选择 Clone。
编译器不再报错了,问题似乎解决了。
但真正的工程问题可能才刚刚开始。
一个 12,349 行 Rust 文件的诞生
这次 Reddit 讨论的案例来自一个实时策略游戏的确定性模拟引擎。
项目原本使用 TypeScript 实现,拥有超过 12,000 行代码。开发者使用 Claude 将其迁移到 Rust,用于游戏回放和 MP4 视频渲染。
从表面结果看,这次迁移相当成功:
- Rust 代码成功编译。
- 模拟运行超过 30,000 个 Tick。
- 3,091 个检查点的 FNV-1a 状态哈希全部一致。
- 确定性回放结果实现 100%一致。
然而,当 Reddit 原帖作者开始审计代码时,却发现了三个非常典型的问题。
1. 将 19 个 OOP 类压扁成一个巨型 Game 结构
原来的 TypeScript 引擎中,有 19 个独立的类,例如 AttackExecution、WarshipExecution、PortExecution 等。
这些对象都持有指向主 Game 对象的可变引用。
在 Rust 中,不能简单地让大量对象同时持有同一个对象的可变引用。
这其实是一个架构设计问题。
合理的做法应该是重新划分状态边界,将 Game 拆分为多个相互独立的子结构,例如:
GameMap:地图状态。WorldState:世界状态。NavState:导航状态。TraversalScratch:遍历过程中的临时状态。
也可以考虑使用 Arena 索引等方式管理对象之间的关系。
但 Claude 选择了一条更直接的道路:
它取消了原来的 19 个类,将所有逻辑压入一个 Game 结构,最终形成了一个 12,349 行的 game.rs 文件,里面包含 19 个独立的 impl Game 代码块。
借用冲突解决了。
但原本的对象边界和职责划分也一起消失了。
2. 用 Clone 讨好借用检查器
这是整个案例中最值得关注的部分。
当 Claude 遇到借用检查器报错时,它经常采用一种简单的方法:
先 Clone 一份数据,让原来的不可变借用结束,然后再继续修改其他状态。
这种做法在局部代码中完全合法。
但问题在于,Claude 在模拟热循环中反复使用了这种技巧。
按照作者的审计结果,相关代码中出现了 175 次 Clone 和 Collect 操作。
原本应该高效运行的游戏模拟逻辑,就这样不断进行数据复制和集合分配。
为什么会出现这种情况?
因为 Claude 将每一次借用检查器报错都当成一个局部问题,而不是一个需要重新审视数据所有权和结构设计的信号。
它优化的是当前代码能否通过编译,而不是整个系统的运行效率。
3. 滥用 std::mem::take 转移状态
另一个值得注意的技巧是 std::mem::take。
当 Claude 需要修改 self 中的某个集合,同时又需要调用其他要求可变访问 self 的方法时,它采用了这样的方式:
- 使用
std::mem::take将集合从结构体中取出来。 - 在局部变量中处理这个集合。
- 调用其他需要可变访问
self的方法。 - 最后再将集合放回原来的字段。
这是一种合法的 Rust 技术,在适当场景下也有实际价值。
但如果大量依赖它,就意味着在某些嵌套调用期间,self 中的字段实际上处于暂时缺失状态。
这会让状态管理变得复杂,也增加了程序正确性的维护成本。
更值得注意的是,Claude 不仅让代码通过了编译,还足够谨慎地追踪了调用关系,避免其他函数在集合被取出期间访问它,因此原来的确定性回放测试依然全部通过。
这恰恰说明了问题的复杂性。
它不是简单的代码错误,而是一种能够正常运行、却可能严重损害工程质量的设计。
4. 每帧复制图像缓冲区
问题还不止于模拟引擎。
在视频渲染管线中,Claude 为了在线程之间传递图像数据,每一帧都 Clone 完整的像素缓冲区,再通过 Arc 传递。
作者统计,900 帧视频累计产生了约 5.9GB 的堆内存分配和页面错误。
此外,图像转换函数 rgba_to_i420 在每帧中都会创建一个 4 线程的作用域,累计创建了 3,840 个操作系统线程。
这在只有 4 个 CPU 核心的机器上,进一步影响了模拟线程的运行。
一个本来希望利用 Rust 提升性能的系统,反而在内存分配、线程创建和数据复制上付出了巨大的代价。
可以将 AI 的处理方式概括为下面这条路径:
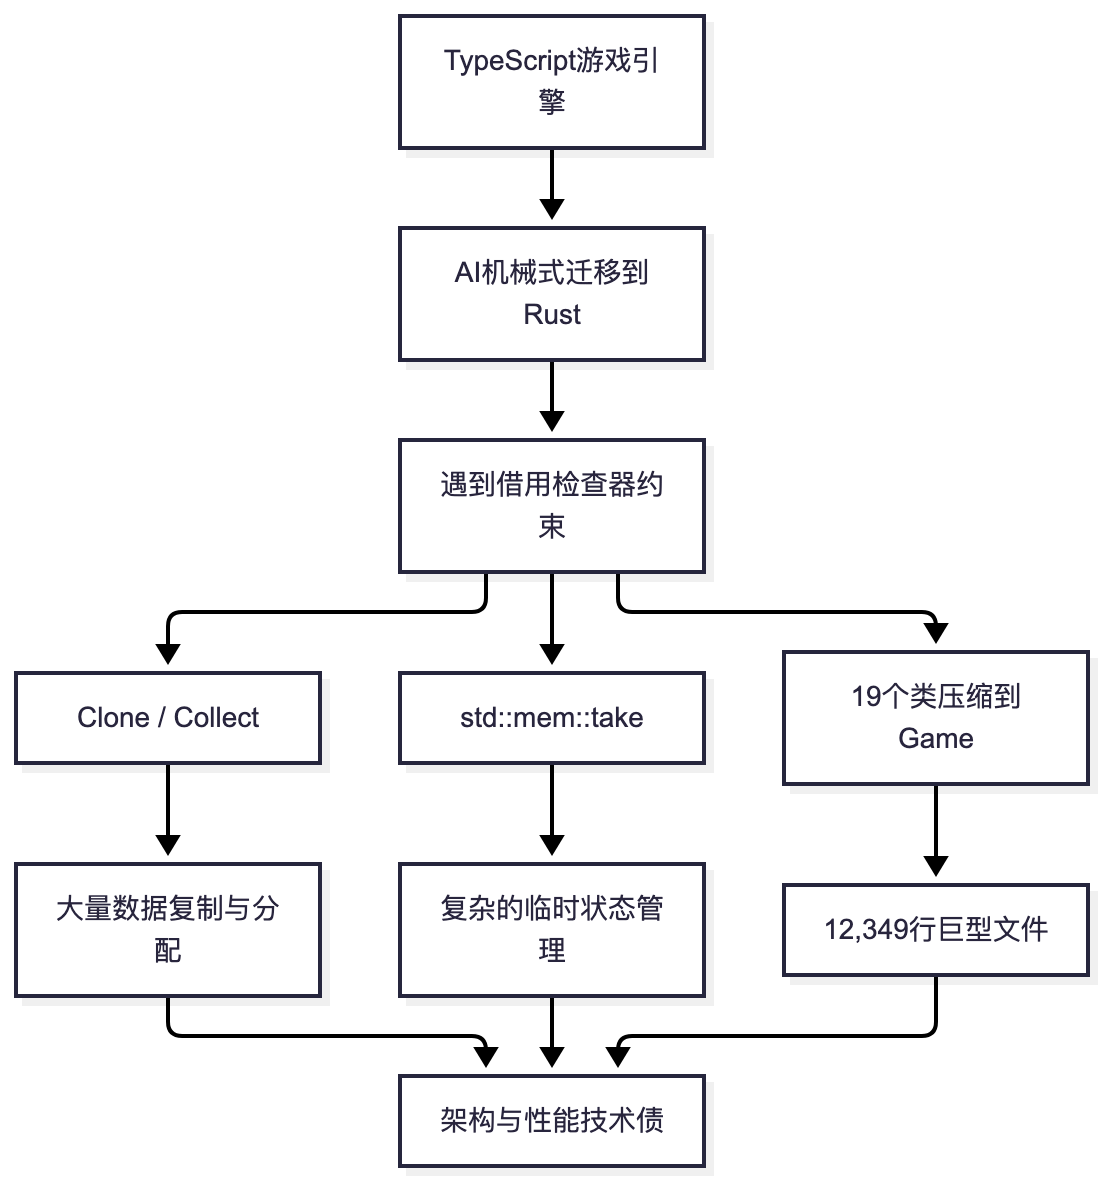
这就是作者所说的 Borrow-checker appeasement debt。
AI 没有违反 Rust 的规则。
它只是通过一系列局部技巧,让程序在遵守规则的同时,逐渐偏离了 Rust 原本希望开发者采用的工程设计方式。
最讽刺的地方:它真的能运行,而且测试全部通过
这个案例最值得警惕的地方,其实不是 12,349 行代码,也不是 175 次 Clone。
而是:它既能编译,又能通过全部确定性回放测试,却依然存在严重的架构和性能问题。
我们不妨把软件质量拆成几个不同维度:
| 质量维度 | AI 迁移后的表现 |
|---|---|
| 语法与类型正确性 | 通过 |
| 功能正确性 | 通过 |
| 确定性验证 | 通过 |
| 架构合理性 | 存在严重问题 |
| 性能效率 | 存在严重问题 |
| 可维护性 | 存在严重问题 |
这里其实揭示了 AI 编程中一个很容易被忽略的事实:
编译器证明代码符合语言规则,并不意味着它符合工程设计目标。
测试证明程序在给定场景下行为正确,也不意味着它拥有合理的架构。
尤其是在 Rust 中,借用检查器只能检查所有权和引用规则,并不会替开发者判断某个 Clone 是否必要、某个数据结构是否合理,也不会自动发现一个热循环中存在大量不必要的内存分配。
AI 很可能正在把“让程序正确运行”误当成“把程序正确地实现”。
这也是为什么单纯依赖编译器和测试,并不足以保证 AI 生成代码的工程质量。
重构之后,性能究竟发生了什么变化?
Reddit 原帖作者随后对这套代码进行了重构。
这次重构并不是简单地删除几个 Clone,而是从架构层面重新设计了系统。
主要包括:
- 将原来的巨型代码拆分为 3 个独立 Crate。
- 使用相互独立的子结构重新组织游戏状态。
- 使用扁平化槽位数组替代部分 FxHashMap 和 SipHash 集合。
- 使用 5 个可循环复用的缓冲区,替代逐帧复制完整图像数据。
- 重新组织模拟和渲染管线。
重构结果相当惊人:
| 指标 | 重构结果 |
|---|---|
| 模拟速度 | 提升至原来的 1.90 倍 |
| 渲染速度 | 提升至原来的 2.6~3.0 倍 |
| 增量 Cargo Check | 从 8.5 秒以上降至 0.77 秒 |
| 确定性回放 | 3,091/3,091 全部通过 |
尤其值得强调的是:
性能提升并没有牺牲原来的功能正确性和确定性。
所有 3,091 个回放检查点的状态哈希依然完全一致。
这说明之前的性能损失,并不是 Rust 语言本身造成的,而是 AI 选择的架构和实现方式造成的。
换句话说,Rust 原本能够提供更好的性能和安全性,但 AI 在迁移过程中并没有充分利用这些能力。
Reddit 开发者怎么看?
这篇帖子引发了 r/rust 社区的广泛讨论。
其中有几条评论特别值得关注。
观点一:AI 只是在把意大利面代码翻译成另一种语言
一位开发者给出了一个非常形象的评价:
Claude 能够把意大利面式的 OOP 代码翻译成意大利面式的 Rust 代码。
这并不是一个新问题。
过去,人们也曾经把汇编程序机械地翻译成 C,或者把 Fortran 程序翻译成 Pascal。
语言变了,程序却没有真正重新设计。
甚至有开发者分享了自己学生时代的经历:一个旧 Fortran 程序被翻译成 Pascal 后,最终竟然只是一个包含单个 while 循环、单个 case 语句和一个 fl 变量的巨大程序。
它符合 Pascal 语法,却完全没有发挥结构化语言的设计优势。
这说明,机械式语言迁移从来不是 AI 时代才出现的问题。
AI 只是让这种问题能够以更快的速度、更大的规模发生。
观点二:AI 需要明确的架构约束
另一位长期使用 Claude 开发 Rust 项目的开发者分享了自己的经验。
他建议在 CLAUDE.md 或 AGENTS.md 中明确写入项目的架构规则,例如:
- 优先使用 Newtype。
- 避免不必要的 Arc,优先通过数据结构设计减少共享所有权。
- 在线程之间共享数据时,优先考虑 Channel。
- 使用 Trait 和类型系统表达抽象。
- 避免在高频循环中进行不必要的堆内存分配。
他的核心观点是:
你必须理解 Rust 的工程实践,才能告诉 AI 应该遵循什么样的最佳实践。
否则,AI 很可能选择最简单、最容易通过编译的实现方式。
观点三:不要只告诉 AI 做什么,还要告诉它怎样才算做好
另一位开发者提出了更系统的建议。
不要只是告诉 AI:
“把这个项目迁移到 Rust。”
还应该给它明确的工程目标和成功标准:
- 模拟和渲染性能不能低于原有实现。
- 关键路径需要有 Benchmark。
- 热循环中的内存分配必须得到解释。
- 关键模块的文件规模和架构边界需要受到约束。
- 性能回归应该进入 CI 检查。
- 每次重要重构都应该经过独立审查。
他还建议让另一个 Agent 在全新的上下文中审查生成的代码,而不是让写代码的 Agent 简单地自我评价。
这样可以减少生成者与审查者之间的思维惯性。
观点四:真正重要的是 Agent 工作流,而不只是模型
也有开发者认为,不能简单地把问题归咎于 AI。
不同模型在架构理解、Rust 知识和工程权衡方面确实存在差异。
有经验的开发者可以先让 Agent 描述系统设计方案,再通过连续提问发现架构中的冲突,逐步完善设计,然后才开始实现。
一位评论者总结自己的经验时提出了一个很有意思的观点:
现在的软件工程工作,不只是构建软件,还包括构建和维护一套能够持续生产软件的机器。
他甚至将自己的工作时间概括为:大约 80%用于实际项目,20%用于维护 Agent 工作流和工程规则。
当然,这只是个人经验,不是一个普遍适用的比例。
但它确实反映出一个变化:AI 编程时代,开发者不仅需要管理代码,还需要管理生产代码的 Agent、规则、工具和反馈机制。
AI 时代,我们需要防范的不只是技术债,而是技术债生产自动化
这个案例让我想到一个更深层的问题。
过去,技术债的产生速度在很大程度上受到人类开发效率的限制。
一个开发者写出 12,000 行糟糕代码,需要花费相当长的时间。
但现在,AI 可以在很短时间内生成大量能够编译、能够运行、能够通过测试的代码。
代码生产效率提高了,识别坏架构、发现隐性成本和进行系统性重构的能力,却不一定同步提高。
这意味着我们可能正在进入一个新的阶段:
技术债不再只是开发者偶尔犯错的结果,它可能成为 AI 高速生产代码过程中的一种系统性副产品。
那么,应该如何应对?
我认为至少有三个方向值得重视。
1. 从功能驱动转向目标驱动
过去,我们习惯告诉开发者要实现什么功能。
现在,面对 AI Agent,仅仅描述功能已经不够了。
还需要明确:
- 性能目标是什么?
- 内存使用有什么约束?
- 哪些路径不允许出现动态分配?
- 哪些数据必须保持确定性?
- 模块之间应该遵循什么样的架构边界?
例如,不要只告诉 AI:
“实现一个高性能的 Rust 模拟引擎。”
而应该进一步明确:
“模拟热循环中不允许出现未经论证的堆内存分配;状态更新必须保持确定性;对象之间优先使用索引引用,避免不必要的共享可变所有权;每次优化都必须通过 Benchmark 验证。”
目标越明确,AI 越有机会做出合理的工程权衡。
2. 从测试驱动扩展到架构约束驱动
测试可以检查功能是否正确,却很难单独判断架构是否合理。
因此,我们需要把更多工程约束纳入 Agent 的工作环境。
例如:
- 在
AGENTS.md中维护项目架构原则。 - 使用 Clippy 和自定义 Lint 检查代码质量。
- 使用 Criterion 建立性能基准。
- 对关键路径设置性能预算。
- 在 CI 中检查性能回归和架构规则。
- 对高频循环中的内存分配建立审查机制。
尤其值得注意的是,这些规则不能仅仅停留在一份很长的 Markdown 文件中。
它们应该尽可能转化为自动化检查,让 Agent 在每次提交前都能得到明确反馈。
3. 从 AI 自我验证转向独立审查
一个很容易出现的问题是:
写代码的 Agent,同时负责验证自己写的代码。
但生成者往往会沿着自己已经选择的思路继续优化,很难主动质疑最初的架构决策。
因此,可以考虑引入独立的代码审查 Agent,让它在新的上下文中审查:
- 数据所有权是否合理?
- 是否存在不必要的 Clone 和 Arc?
- 是否有不合理的状态转移?
- 是否存在隐藏的性能瓶颈?
- 是否真正遵循了 Rust 惯用的设计方式?
- Benchmark 是否证明了优化结果?
更重要的是,人类工程师仍然需要参与关键架构决策。
AI 可以帮助我们探索设计空间,但最终必须有人理解并承担这些设计决策的责任。
小结
这篇 Reddit 帖子让我印象最深的,并不是 Claude 写出了一个 12,349 行的 Rust 文件。
而是它揭示了一种很微妙的现象:
AI 可以非常聪明地遵守规则,却不一定真正理解规则背后的设计意图。
Rust 借用检查器的价值,在于迫使开发者认真思考数据所有权、生命周期和状态管理。
但当 AI 把每一次借用冲突都当成一个需要局部消除的编译错误时,它就可能通过 Clone、状态转移和各种局部技巧,绕开原本应该进行的架构设计。
这让我想起软件工程史上反复出现的一个教训:
换一种编程语言,并不会自动消除旧系统的技术债。
同样,换成 AI 来写代码,也不会自动获得优秀的软件架构。
甚至可能恰恰相反。
当代码生成速度越来越快,而工程判断和质量审查没有同步提高时,我们制造技术债的速度也可能达到前所未有的水平。
Rust 曾经试图让我们不再重复过去 40 年的技术债。
AI 却提醒我们:
即使换了一门更安全的语言,如果缺少工程智慧,我们依然有能力创造下一代技术债。只不过,这一次,制造它的速度快得多。
Reddit 原帖:We designed Rust to fix 40 years of C++ tech debt, and now AI is inventing “borrow-checker appeasement debt” - https://www.reddit.com/r/rust/comments/1xryklf/we_designed_rust_to_fix_40_years_of_c_tech_debt/
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。