本文永久链接 – https://tonybai.com/2026/09/28/go-vs-rust-portable-simd-2026
大家好,我是Tony Bai。
【导读】
2026年9月24日,Go官方博客发布了一篇关于Go 1.27中SIMD支持进展的文章;几乎同一时间,Rust社区资深开发者Sergey Davidoff也放出了年度重磅长文,系统盘点了Rust生态里SIMD编程的现状。两篇文章单独看都是硬核的“工程八卦”,放在一起看,却像是两个语言阵营对同一道难题交出的两份完全不同的答卷:如何既能“一次编写、到处飞快”,又不必人人都去写汇编。
【文章要点】
- 同一道考题的两份答卷:2026 年 9 月 24 日,Go 官方发布 Go 1.27 可移植 SIMD 进展博客,Rust 社区同日发布年度 SIMD 生态全景长文,两大系统级阵营同台亮出对“无痛向量化”的解题思路;
- Go 1.27 的自顶向下路线:全新实验性 simd 包借鉴 C++ Highway 哲学,类型层面彻底抹平向量宽度,通过编译器 AST 重写、启动期硬件特化生成以及全平台纯软件模拟兜底,追求“写一次、到处能跑且接近汇编性能”;
- Rust 的自底向上生态:官方 std::simd 仍未走出 Nightly,社区形成“自动向量化 + 平台 Intrinsics + 第三方抽象库(wide/pulp/macerator/fearless_simd)”百花齐放的格局,甚至尝试用类型系统给 CPU 特性签发“安全通行证”;
- 设计哲学的硬核交锋:Go 宁可牺牲部分极端调优空间也要由语言和编译器包揽复杂度,换取标准库的稳定与极简心智;Rust 信任生态自发竞争,性能上限极高但普通开发者面临繁重选型成本;
- 硬件演进与未来风向:面对 AVX-512、ARM SVE 及 RISC-V 变长向量的硬件碎片化现实,SIMD 正在从“少数性能极客的手写汇编玩具”蜕变为现代编程语言不可或缺的核心基础设施。

引子:同一天的两篇文章
如果你不写高性能计算相关的代码,SIMD(Single Instruction Multiple Data,单指令多数据)这个词可能有点陌生。但它其实无处不在:图片解码、字符串搜索、哈希计算、向量数据库的相似度检索、甚至Go自己的垃圾回收器,背地里都在偷偷用它加速。
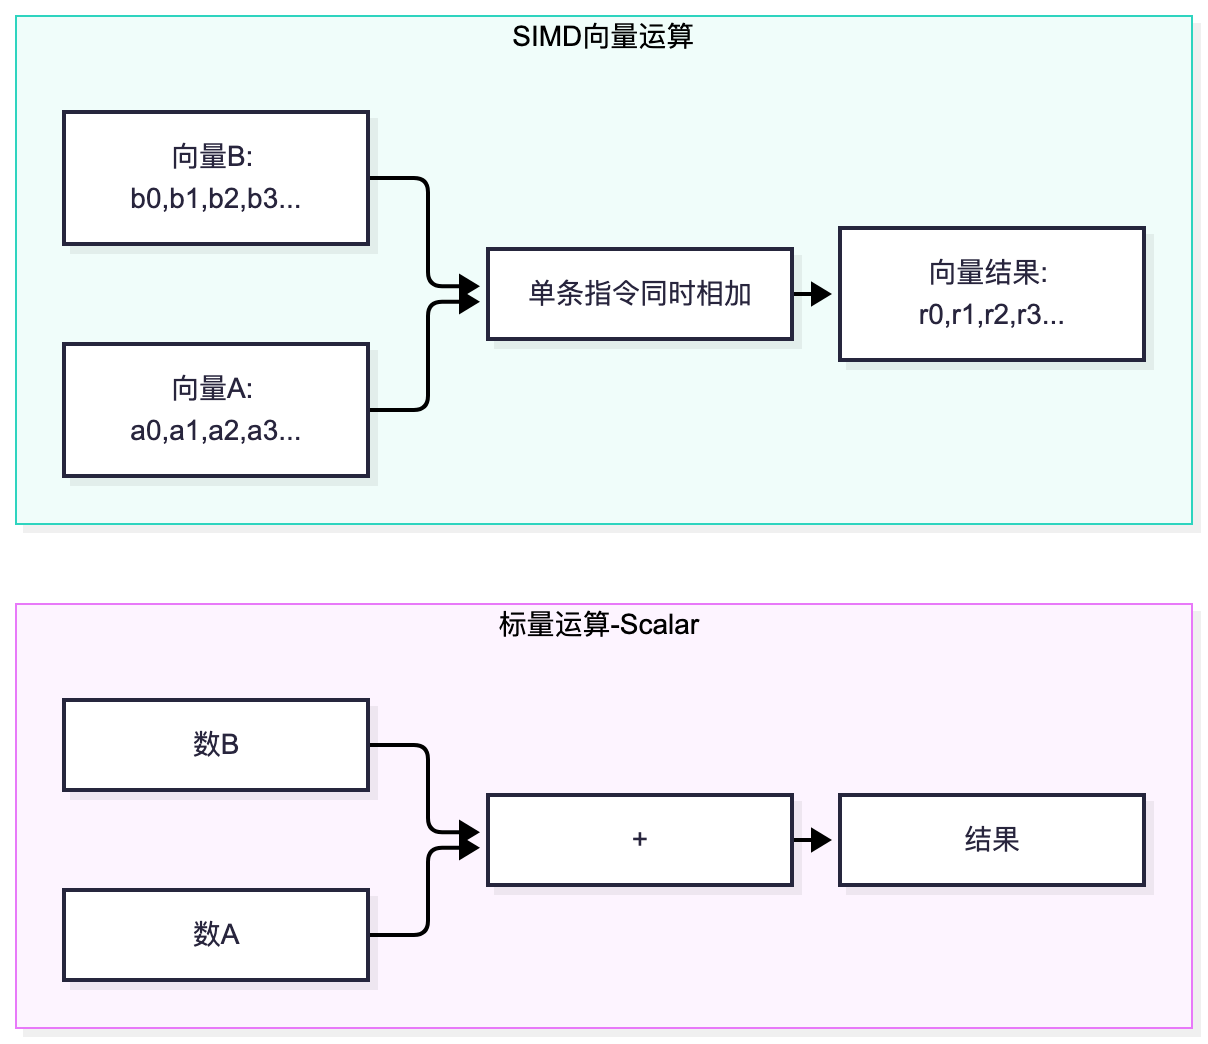
简单说,普通CPU指令一次只能处理一个数:把两个数加起来,占用一条指令;但SIMD指令可以让CPU一次性把8个、16个甚至64个数同时加起来,几乎是“同样的时间,多干好几倍的活”。问题是,这份“福利”长期以来只有写汇编或者调用平台专属指令集(Intrinsics)的人才能真正吃到嘴里,普通业务代码很少能沾光。
于是,“怎么用一种优雅、可移植的方式暴露SIMD能力”,就成了几乎所有系统级编程语言都要面对的共同难题。而就在这个九月,Go和Rust两个阵营几乎同时交出了各自的最新答卷——但答案却南辕北辙。
SIMD是什么,为什么最近又被反复提起
先简单铺垫一下背景。
现代CPU的算术运算单元其实非常廉价,一颗芯片里塞满了加法器、乘法器,但真正的瓶颈在“指令译码”这个环节——CPU一次只能高效地译码和调度有限数量的指令。SIMD的思路就是:既然算术单元这么多,不如一条指令喂给它一整“批”数据,而不是一个一个数地喂。
于是同样是做加法,标量(Scalar)指令一次只加一对数,SIMD向量(Vector)指令一次可以加8对、16对甚至更多,理论上能拿到数倍到数十倍的吞吐提升。
但天下没有免费的午餐,SIMD的“坑”主要来自硬件的碎片化:
- x86平台上,SSE2、AVX、AVX2、AVX-512是逐代叠加的扩展,同一颗x86_64 CPU未必支持最新指令集;
- ARM平台的NEON倒是64位ARM芯片标配,相对省心;
- WebAssembly也有自己的128位SIMD扩展,但需要单独编译一份支持SIMD的二进制;
- 更不用说RISC-V、LoongArch这些还在发展中的架构,向量宽度甚至是运行时才能确定的变量。
正是这种“同一个概念,十种实现方式”的现状,逼着Go和Rust都不得不认真面对“可移植SIMD”这道题。
Go 1.27的答案:一个“抹平差异”的simd包
两层架构:archsimd与simd
Go的解法分成了两层。
第一层是Go 1.26就已经引入的archsimd包:这是一个架构相关(architecture-dependent)的API,amd64、arm64(NEON)、wasm各有各的实现,力图尽量贴近底层指令,性能拉满,但代码要按平台分别编译。
第二层,也是这次Go 1.27真正的主角——全新的、实验性的simd包。它的设计思路松散地借鉴了C++的高性能SIMD库Highway,目标是提供一套完全平台无关、向量宽度无关的接口。换句话说,写一份simd代码,不用关心自己到底跑在AVX2还是NEON上,编译器会在背后把它落地成最匹配当前硬件的实现;如果目标平台压根没有SIMD硬件,simd包还会自动退化为纯软件模拟,保证代码“总能跑起来”,只是快慢有别。
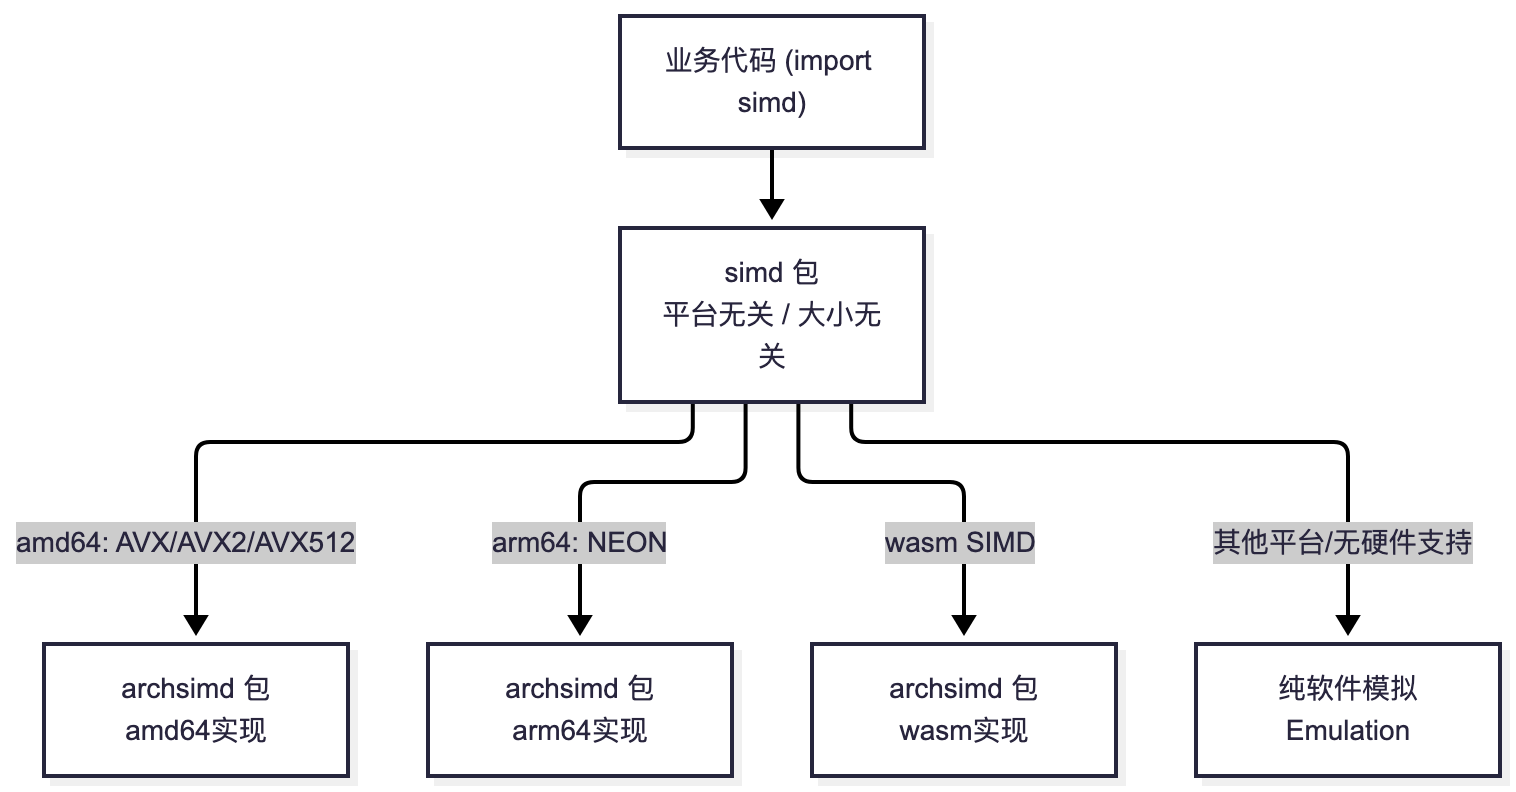
要启用这个实验特性,需要在编译时加上GOEXPERIMENT=simd。
平台差异到底有多大
Go团队在文章里花了不小篇幅解释“为什么这事儿这么难”。差异主要体现在三个维度:
向量宽度不统一:wasm、PowerPC、s390x只有固定的128位向量;amd64同时支持128、256、512位;RISC-V的向量宽度甚至在128到65536位之间浮动,且要运行时才能确定;ARM64更是“一鱼两吃”,NEON固定128位,SVE则是128到2048位的可变宽度。
掩码(Mask)机制五花八门:SIMD里经常需要“按条件只对部分元素生效”的操作,不同架构实现这件事的方式完全不同——有的靠位运算模拟掩码(wasm、AVX、AVX2、NEON),有的有专门的掩码寄存器、一个比特对应一个向量元素(AVX512、RVV),SVE则是一个比特对应一个字节,情况相当复杂。
具体指令支持参差不齐:比如wasm就不支持64位整数向量的比较操作;同一个架构内部,还要看具体的“特性位”(feature)才能确定某条指令到底存不存在。
设计目标:能力取交集,缺口靠模拟
面对这种碎片化现实,Go团队给simd包定下的设计目标是:
- 覆盖大多数向量化算法所需的常见操作,但不绑定具体向量长度;
- 当源码操作能精确对应到硬件指令时,效率要做到接近汇编;
- 其余情况,尽量高效地用软件模拟补齐;
- 代码要足够易读——用官方原话说,“即使是LLM来写这段代码,也得写得明白”。
具体做法是:
- 先把所有主流架构都支持的操作取“交集”,做成
simd包的基础能力; - 交集之外但确实重要的操作(比如密码学和CRC校验用到的无进位乘法),就手写模拟实现补上;
- 实在没法通用的高阶操作(比如“横向相加”这种依赖向量长度的原语),干脆换个思路,直接提供更上层、跟向量长度无关的语义(比如求和归约
ReduceSum)。
代码示例:一次编写,多平台跑
官方给出的一个典型例子是向量内积计算,思路很直白:一次装载一批float32,用MulAdd(乘加)指令批量计算,循环结束后再处理不足一批的“零头”:
// innerProduct returns the inner product of x and y.
func innerProduct(x, y []float32) float32 {
    var a simd.Float32s
    var i int
    for i = 0; i < len(x)-a.Len()+1; i += a.Len() {
        u := simd.LoadFloat32s(x[i : i+a.Len()])
        v := simd.LoadFloat32s(y[i : i+a.Len()])
        a = u.MulAdd(v, a)
    }
    if i < len(x) {
        u, _ := simd.LoadFloat32sPart(x[i:])
        v, _ := simd.LoadFloat32sPart(y[i:])
        a = u.MulAdd(v, a)
    }
    return sum(a)
}
注意这里全程没有出现任何“256位”或者“AVX2”字样,a.Len()会在运行时返回当前平台实际的向量长度——这正是“平台无关”的核心体现。当然Go 1.27的第一版还有些功能缺口,比如横向求和ReduceSum要等到下一个版本才补上,目前示例里还得手写一个辅助函数。
编译器怎么把它变快:AST重写与特化
这一层“看不见的魔法”值得单独说一说。Go团队坦言,simd其实同时是一个包、一个内部实现包,外加编译器前端的一段AST(抽象语法树)重写逻辑。
编译器会为所有涉及simd类型的函数、变量和类型生成多份"特化副本",分别对应128位、256位、512位向量或者纯模拟这几种情况,并在函数名后面加上类似@simd256这样的后缀。
程序启动时先检测硬件实际支持的SIMD级别,之后统一走到对应的特化版本,特化函数之间互相调用不再需要额外的判断开销,甚至可以直接内联。这算是一种在“代码体积”和“运行时性能”之间的折中:把判断开销尽量往调用链上层推,但又不会推得太高,SIMD计算内部完全没有额外分支负担。
GODEBUG调试开关
为了方便开发者在没有对应硬件的情况下也能测试各种SIMD路径,Go还提供了一组GODEBUG=simd=...开关,比如强制走纯模拟(simd=0)、强制使用128/256/512位向量、甚至允许“明知道某些特性缺失也硬上”(用+前缀),方便针对Raspberry Pi、Apple Silicon的amd64模拟环境这类“能力不全”的场景做兼容性测试。
Rust的答案:一场持续了七年的“群雄逐鹿”
如果说Go的策略是“编译器亲自下场,标准库统一收口”,那么Rust给出的答案完全是另一种画风——生态百花齐放,至今没有收敛出一个“官方唯一答案”。
Sergey Davidoff(社区里更熟悉的名字是Shnatsel,Rust安全代码工作组负责人)这篇《2026年Rust SIMD生态现状》,正是延续他去年同名系列的年度盘点。有意思的是,他这次不再是纯粹的“第三方观察者”——去年写完调研之后,他一头扎进了当时看起来最有前途的SIMD库,如今已经成为fearless_simd的维护者之一。这本身就说明了一个事实:Rust的SIMD生态,还处在“需要外部人才亲自下场推一把”的阶段。
三条路线:自动向量化、可移植抽象和平台intrinsics
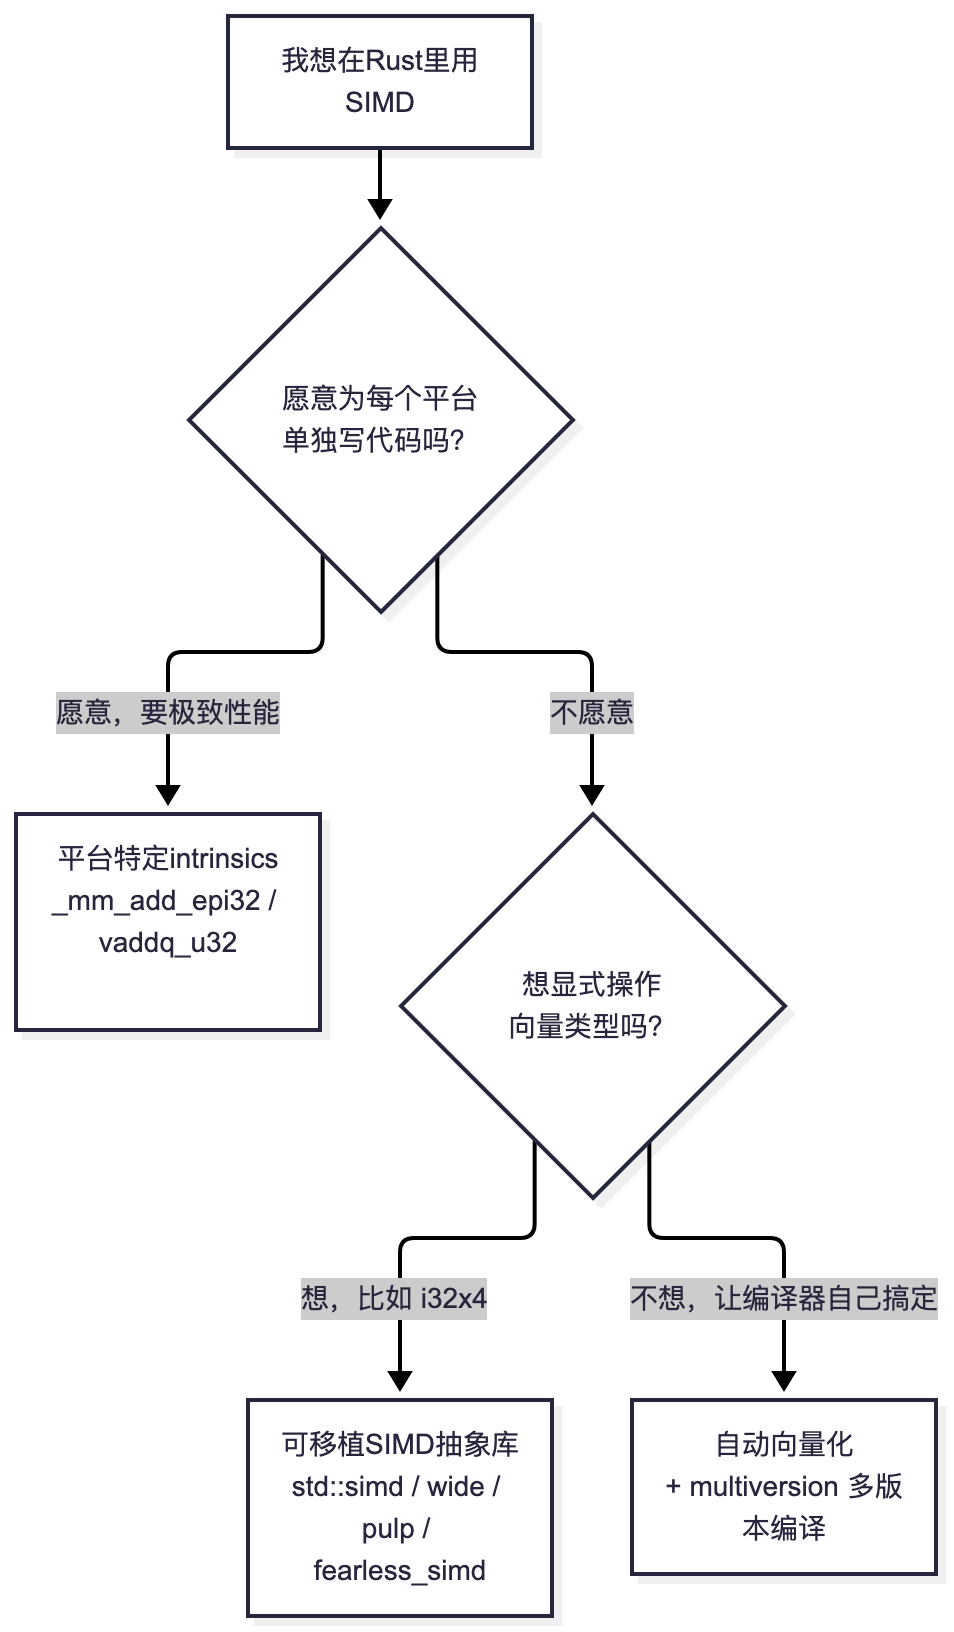
Rust里用SIMD,Shnatsel把可行路径归纳为三条:
自动向量化:什么都不用管,写普通Rust代码,让编译器自己做优化,比如直接调用&[i32].sum()。
可移植SIMD抽象:用类似i32x4 + i32x4这样的向量类型直接编程,语义清晰,但需要引入库或者语言特性支持。
平台特定intrinsics:直接调用类似_mm_add_epi32(x86)或vaddq_u32(ARM)这样的原始硬件指令,性能最强,但要为每个平台、每个指令集单独写一份实现,代码量瞬间膨胀。
自动向量化的甜蜜与陷阱
自动向量化最大的优点是零依赖、代码即插即用,理论上能吃到编译器支持的所有指令集,包括一些冷门架构。
但坑也不小:函数越大越复杂,编译器“猜不中”你想向量化的意图的概率就越高;性能表现还会随编译器版本、周边代码的细微改动上下浮动,稳定性堪忧。
浮点数运算尤其麻烦。过去,出于“不能改变程序可观察结果”的严格要求,编译器几乎不敢对浮点数组求和这类操作做自动向量化,因为向量化往往意味着换一种加法顺序、进而改变浮点精度。这个限制直到今年8月发布的Rust 1.98才有所松动——新版本稳定了一批“代数运算”(algebraic ops)API,允许开发者显式声明“我允许结果精度发生变化”,这才为浮点数的自动向量化打开了口子(当然,这也带来了一个绕不开的老问题:想要精确控制浮点数求和精度本身就是一门学问,感兴趣的读者可以搜一下“Taming Floating-Point Sums”这篇经典文章)。
即便编译器愿意向量化,“多版本编译”(function multiversioning)依然是绕不开的一关:同一个函数得针对不同的CPU特性编译出多份实现,运行时再检测硬件、选择合适的版本。社区里专门有一个multiversion库来干这件事,只需要给函数加一个#[multiversion(targets = “simd”)]标注就能用,非常省心;但它也有一个不太起眼的代价——被标注的函数每次调用都会带来大约十条指令左右的额外开销,如果函数本身特别小、调用特别频繁,这点开销就会被放大成明显的性能损失。经验法则是:循环体用#[multiversion],处理少量数据的小函数则搭配#[inline(always)]使用。
可移植SIMD库生态盘点
抛开自动向量化,Rust生态里真正在“抢占官方标准”位置的,是一批可移植SIMD抽象库。它们衡量的维度通常包括:能否支持固定宽度向量(如f32x4)、能否支持硬件原生宽度(不用事先知道具体多宽)、能否泛型化到不同元素类型、能否泛型化到不同向量宽度。
| 方案 | 现状 | 特点 |
|---|---|---|
std::simd |
仍在nightly,尚未稳定 | 官方"亲儿子",语法最接近语言原生,但迟迟没有转正 |
wide |
生产可用 | 使用简单,但不含多版本编译能力,需要自己额外解决 |
pulp |
生产可用,被faer线性代数库使用 |
支持运行时特性检测与多版本调度,但仅支持硬件原生宽度 |
macerator |
pulp的分支 |
指令集覆盖更广(含LoongArch),泛型能力更强 |
fearless_simd |
快速发展中,作者本人已成为维护者 | 用"标记类型"在类型系统层面证明CPU特性存在,力图把unsafe彻底挡在库内部 |
值得一提的是fearless_simd的设计野心:它试图用一种“标记值”(marker values)机制,把“当前CPU支持某个特性”这件事编码进Rust的类型系统里,相当于给SIMD操作补上一张“类型系统签发的安全通行证”,从而让上层业务代码几乎不用再直接接触unsafe。这个思路和Go编译器做AST重写、生成特化版本,在工程直觉上其实颇为相似——都是想办法把“平台差异”这件脏活挪到用户看不见的地方。
作者亲自下场维护fearless_simd说明了什么
Shnatsel在文章开头特意交代了这段“转身”经历:去年调研完一圈之后,他判断fearless_simd是当时最有潜力的方案,于是干脆加入进去做了维护者;而为了避免“王婆卖瓜”,他特意邀请了std::simd、wide、pulp、macerator等其他库的作者共同审阅这篇文章的草稿。
这段插曲本身就是对Rust现状最真实的注脚:在一个由语言核心团队亲自收口的领域(比如Go的simd包),你很难想象某个第三方开发者会因为“觉得某个方案最有前途”就亲自下场当上维护者——因为压根不需要,官方已经把标准定好了。而在Rust的SIMD领域,这恰恰是常态:真正有话语权的往往是最活跃的社区贡献者,而不是某个“官方唯一实现”。
正面交锋:Go vs Rust的设计哲学
把两篇文章放在一起读,能看出的差异其实远超“SIMD”这一个技术点本身,更像是两种语言一贯风格的缩影。
| 维度 | Go | Rust |
|---|---|---|
| 决策主体 | 语言团队 + 编译器 + 标准库统一收口 | 社区生态自行竞争,官方方案std::simd仍在nightly |
| 抽象层级 | 类型系统彻底抹去向量宽度(simd.Float32s不含长度信息) |
多数方案仍需在固定宽度、硬件原生宽度之间做选择 |
| 兜底策略 | 官方提供统一的软件模拟,保证"到处能跑" | 各库各自实现,兜底能力参差不齐 |
| 安全模型 | 编译器特化 + 运行时检测,用户几乎不接触底层细节 | fearless_simd等库尝试用类型系统"证明"特性存在,仍处于探索期 |
| 现阶段成熟度 | 实验阶段(GOEXPERIMENT=simd),但路线已经比较清晰 |
三条路线并行发展,尚未收敛到统一标准 |
这背后其实是Go和Rust一贯的“性格”差异:Go向来倾向于“少即是多”,宁可牺牲一部分极致性能和灵活性,也要保证一套标准库API能覆盖大多数场景,把复杂度留给编译器和语言维护者;Rust则更信任“生态的自然选择”,鼓励百花齐放,让不同取舍的方案同台竞争,代价是官方标准迟迟难产,普通开发者选型成本更高。
有意思的是,两边都不约而同地走向了“用编译器/类型系统把复杂度往下沉”这条路——Go靠AST重写和函数特化,Rust靠fearless_simd的标记类型和multiversion的属性宏。方向殊途同归,只是“由谁来兜底”这件事上,Go选择了语言,Rust选择了社区。
对开发者意味着什么
如果你只是想知道"我该怎么选",这里给一个务实一点的建议:
- 如果你在写Go:Go 1.27的
simd包目前仍是实验特性,功能还有明显缺口(比如缺横向求和),生产环境慎用,但值得现在就动手写几个benchmark熟悉一下这套API的思路,等它转正之后基本可以无缝迁移。 - 如果你在写Rust:追求极致省心,
wide是不错的起点;需要多版本编译又不想写太多样板代码,pulp或macerator更合适;如果你愿意接受一个还在快速迭代、但设计理念更前沿的方案,fearless_simd值得关注;至于std::simd,除非你能接受nightly,否则短期内还是先观望。 - 不管用哪种语言:SIMD从来不是“无脑加速器”,向量化以后未必总是更快(比如AVX-512在部分CPU上会触发降频),务实的做法永远是先测再上。
尚未解决的问题与下一步
Go这边,官方已经明确表态:Go 1.28计划给archsimd加上ARM的SVE支持,并争取同步带进simd包;同时会补齐一批当前缺失的操作,比如OnesCount(统计比特数)、掩码相关操作、归约操作和向量重排操作;针对像树莓派这种“支持向量指令但缺个别操作”的平台,还打算引入一批“特性变体”,避免直接整体降级到纯软件模拟。
Rust这边的核心悬念,则是std::simd到底什么时候能从nightly转正——这个问题已经悬了相当多年,年复一年地出现在Shnatsel的年度调研里。与此同时,第三方生态还在继续演化:fearless_simd的安全模型能不能真正跑通,multiversion的调用开销问题能不能被彻底解决,都还是进行时。
小结
Go和Rust这次几乎同时交卷,某种意义上是一次巧合,但也不完全是巧合——SIMD编程的“可移植性焦虑”这些年一直在系统编程社区里发酵,只是不同语言选择了不同的时间点、不同的方式去回应它。
Go选择了一条更“收敛”的路:先由编译器和标准库把复杂度扛下来,代价是牺牲一部分灵活性和当前阶段的功能完整度。Rust则继续信任生态的自我进化,代价是普通开发者面对std::simd、wide、pulp、macerator、fearless_simd这一长串名字时,多少会有点选择困难。
无论哪条路线更快抵达终点,可以确定的是:SIMD正在从“少数性能极客的专属玩具”,变成越来越多语言愿意认真投入、正面解决的基础设施问题。这场关于“可移植性”的路线之争,才刚刚开始。
参考资料
- David Chase, Junyang Shao. Platform-independent SIMD in Go. The Go Blog, 2026-09-24. https://go.dev/blog/simd-experiment
- Sergey “Shnatsel” Davidoff. The state of SIMD in Rust in 2026. 2026-09-25. https://shnatsel.github.io/state-of-simd-rust-2026/
- Sergey “Shnatsel” Davidoff. The state of SIMD in Rust in 2025(上一年度调研). https://shnatsel.medium.com/the-state-of-simd-in-rust-in-2025-32c263e5f53d
- Linebender. Towards fearless SIMD, 7 years later. https://linebender.org/blog/towards-fearless-simd/
- Highway:Google开源的C++可移植SIMD库,Go
simd包的设计灵感来源。https://google.github.io/highway/en/master/index.html
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。