本文永久链接 – https://tonybai.com/2026/09/22/jev-engineering-the-decision-layer-for-agentic-systems
大家好,我是Tony Bai。
【导读】
几乎所有陷入泥潭的 Agent 开发者都在犯同一个错误:试图用一个通用大模型去搞定一切——既让它写文案做推理,又让它做分类路由、自我评估和工具调度。这种“大包大揽”不仅响应迟钝、成本高昂,更让每一次工作流故障都变成无法定位的黑盒。由 TypeSafe AI 与 0xCodila 团队总结的前沿技术综述,正式确立了“Jev 工程学”这一全新架构范式:彻底解耦为“大模型负责生成、Jev 负责决策、代码负责执行”的三层体系。本文将系统拆解这套专为智能体系统打造的高频决策层设计,从类型化契约、置信度门控,到 7 大工程法则与 10 套实战蓝图,带你掌握下一代高密度 Agent 架构的核心密码。
【文章要点 (TL;DR) 】
- 三层权责解耦:确立“大模型负责生成、Jev 负责决策、代码负责执行”的现代 Agent 架构,将非结构化文本与高频类型化决策彻底剥离,实现模块化故障溯源;
- 三大类型化决策原语:通过 Choice(单选)、Score(打分)与 Noul(二值概率)输出附带概率分布和置信度的标准数据结构,从根源上消灭输出解析失败与格式幻觉;
- 状态即证据,问题即契约:状态必须是结构化事实数据而非散文指令,每次外部动作后必须实时重建;问题必须具备原子性且准则客观可观测,支持单次调用并发求解多个问题(延迟降低 10 倍、成本降低 12 倍);
- 置信度门控与闭环验证:依照业务风险严重度设定阶梯阈值(低风险 0.70,工具动作 0.90,不可逆操作强制人工审批与代码校验),牢守“代码决定动作是否被允许执行”的底线;
- 严防“无证据完工”反模式:模型输出的“DONE”绝不能作为最终事实,系统的完工验收必须物理探查外部真实世界(文件、页面、数据库)的改变;
- 决策密度带来复合价值:在浏览器自动化(调用开销骤降 10 倍)、内容全量审查(0.7秒裁定777项判断,提速25倍且降本580倍)、简历排序与邮件路由等实战场景中展现出颠覆性效能。
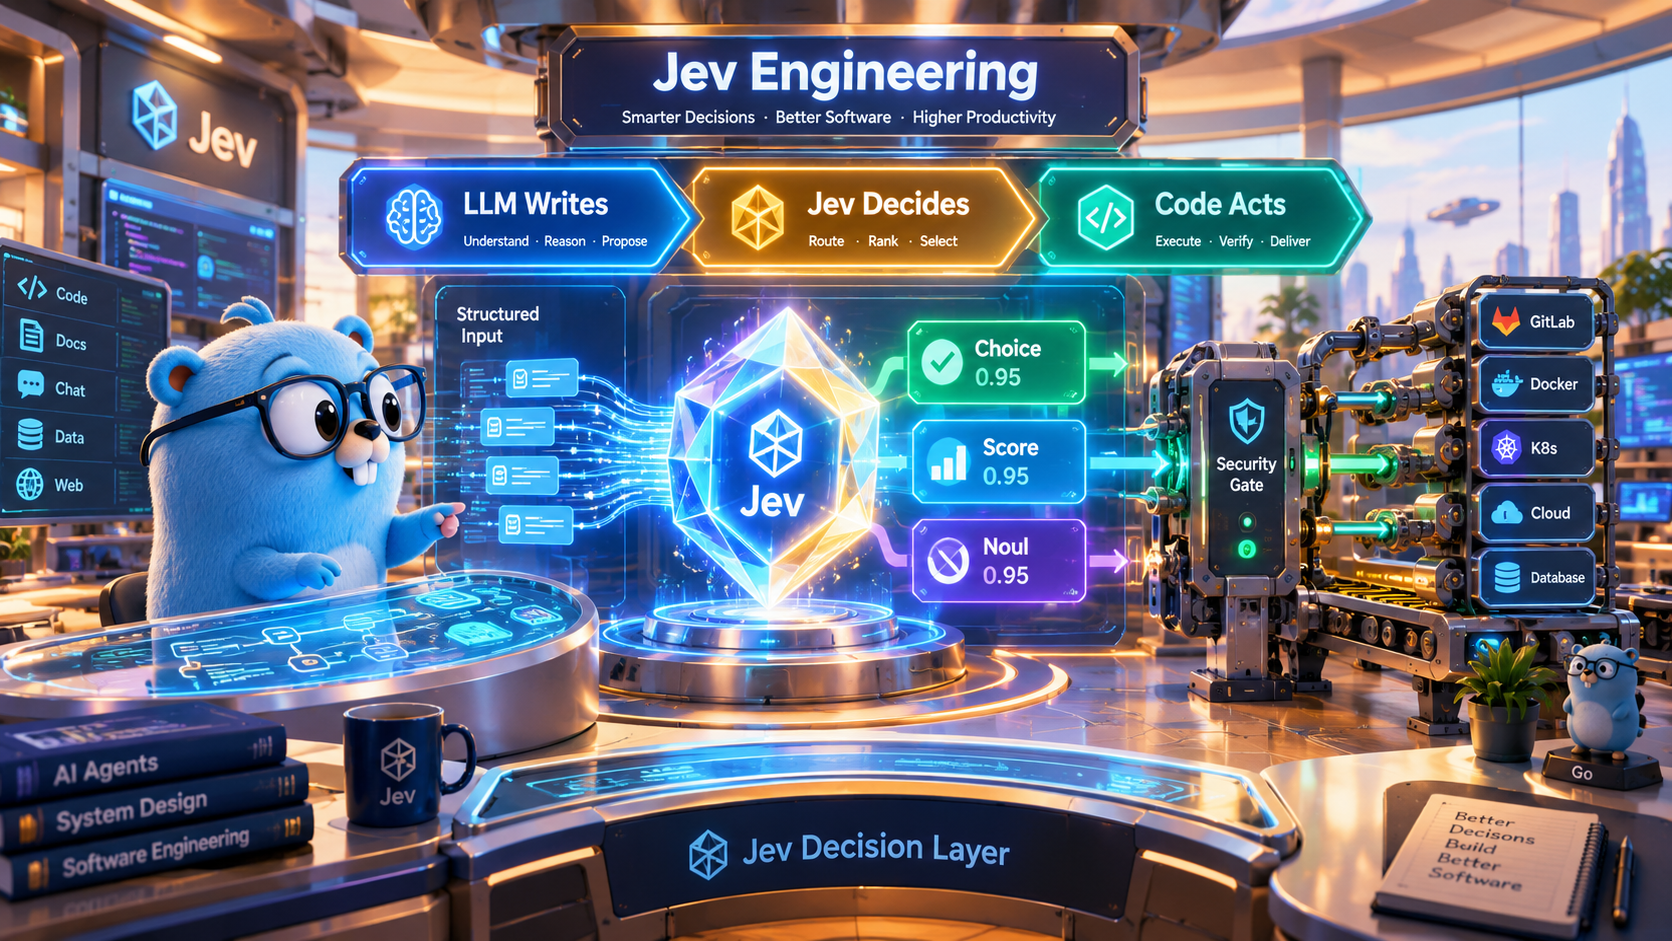
在构建 Agent(智能体)系统的实践中,几乎所有开发者都会踩进同一个“泥潭”:让同一个通用大语言模型(LLM)去承担所有事情——既让它写文章、做推理,又让它做路由选择、自我评估、工具调度和安全审核。这种架构设计不仅响应迟缓、成本高昂,更致命的是它极其难以调试——当工作流崩塌时,你根本分不清究竟是模型生成了劣质文本、做出了错误的路线选择,还是它在自我验证时产生了幻觉。
本文翻译自一份前沿工程技术综述,系统性地介绍了由 TypeSafe AI 提出的专用决策模型 Jev 及其工程方法论(Jev Engineering)。该框架提出了一种高度解耦的现代 Agent 架构哲学:“大模型负责生成,Jev 负责决策,代码负责执行。” 通过将非结构化的自由文本生成与高频、确定的“类型化决策(Choice, Score, Noul)”剥离,并引入置信度门控与闭环验证机制,Agent 系统在速度、成本与稳定性上展现出了数量级的提升。
无论你是正在为复杂的 Agent 工作流稳定性发愁的架构师,还是探索低延迟工具调用与路由的开发者,本文总结的 7 条工程法则、5 大常见反模式、10 大设计蓝图及落地检查清单,都具备极高的实操借鉴价值。
以下是全文:
JEV 工程学:智能体系统的决策层
大模型负责生成。Jev 负责决策。代码负责执行。
(An LLM Writes. Jev Decides. Code Acts.)
一份用于研讨的技术综述
参考来源: TypeSafe AI 官方技术文档、0xCodila 工程操作手册(Playbook)、Browser Use、Every、HiringCafe、LangChain 公开集成
注:本文独立成篇,未受 TypeSafe AI 或文中所提及的任何机构赞助或认可
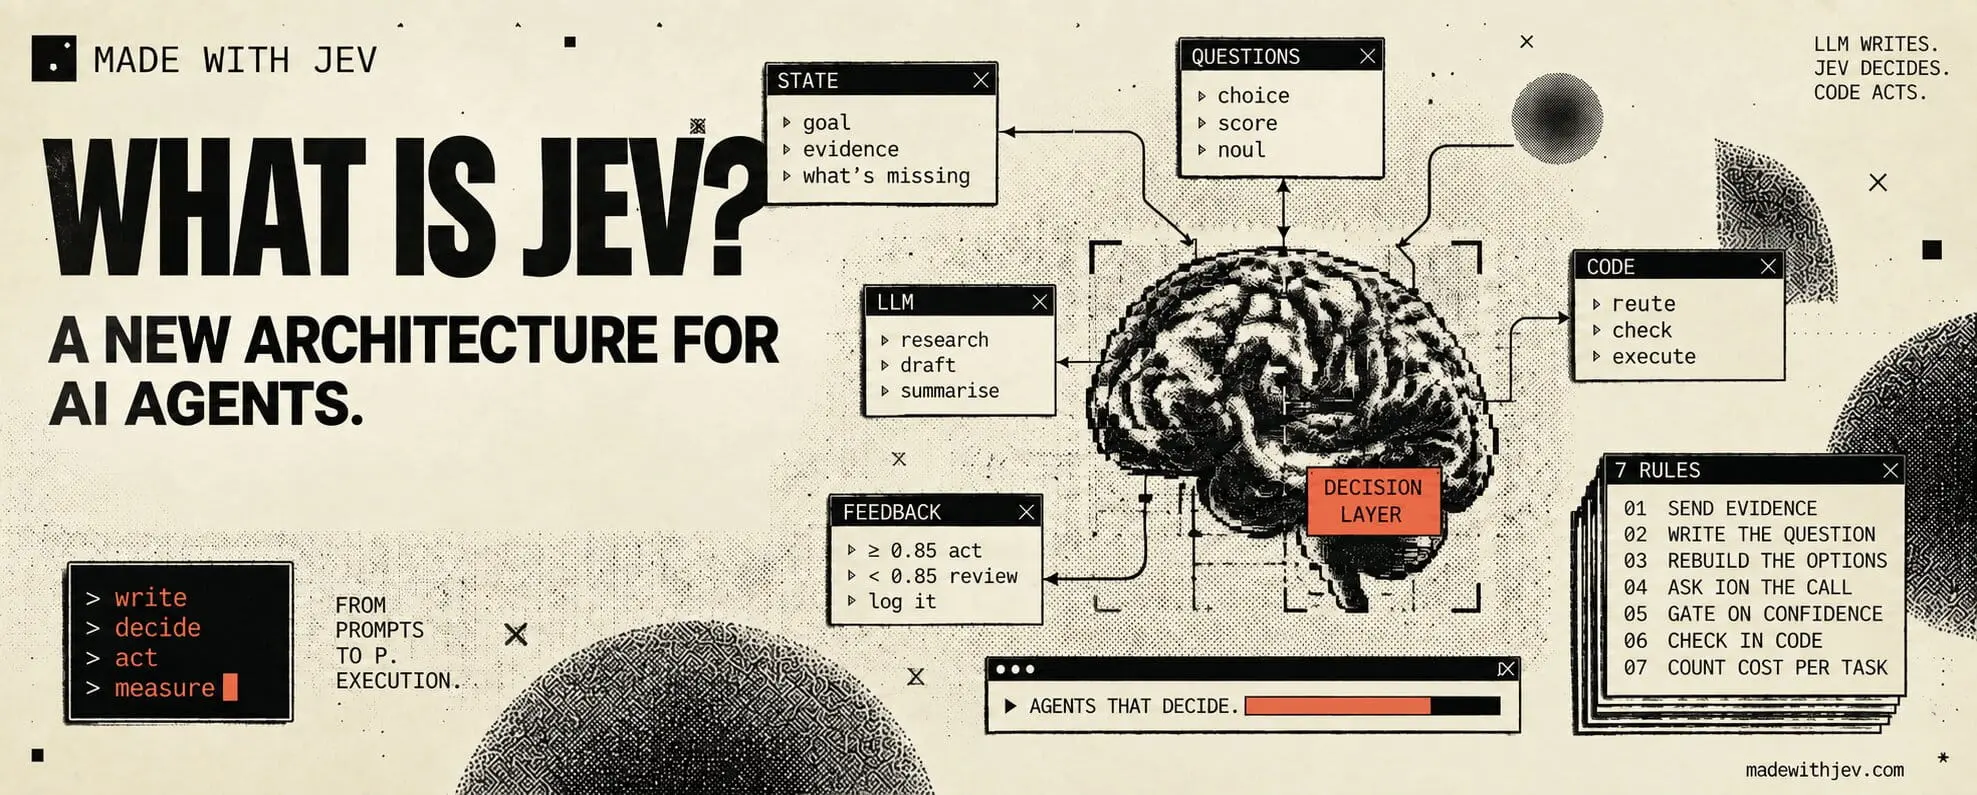
图 1. 智能体系统中的 Jev。应用程序状态与预定义问题进入中间的决策层(Decision Layer)。Jev 返回带有概率和置信度分数的类型化决策。外部模型、智能体、工具以及确定性代码负责执行实际工作。右侧的“7 条规则”面板规定了工程不变式。下方的反馈循环基于置信度阈值对执行进行门控。
摘要——Jev 是一种面向智能体(Agentic)系统的决策模型,它将结构化的上下文状态转化为类型化(Typed)输出:选项、评分和概率估计。Jev 并不生成自由格式的自然语言文本,而是作为系统内部的一个专用组件运行,用于评估选项、估算相关性并决定工作流中的下一步行动。本文结合 TypeSafe AI 的官方文档与 0xCodila 工程操作手册,对“Jev 工程学(Jev Engineering)”框架进行了系统性梳理。我们主要探讨三个核心问题:什么是 Jev(一个类型化决策层,而非对话机器人)、如何使用它(状态设计、问题契约、置信度门控路由),以及它在何处能带来可量化的商业价值(浏览器智能体、内容流水线、销售线索评分、安全门控)。本文提炼出了 7 条工程法则、5 大反模式,并为所有 Jev 落地应用提供了一份可复用的评估检查清单。文中所引用的所有基准评测数据均附带测试范围、注意事项及对比基线。
索引词——Jev 工程学,决策层,类型化决策,系统一(System One),Choice(单选),Score(评分),Noul(二值概率),置信度门控,智能体路由,TypeSafe AI,智能体系统。
一、引言
A. 决策瓶颈
几乎所有智能体系统都在犯同一个错误:试图用一个模型搞定一切——写作、推理、路由、评估、决策和执行。其结果完全在预料之中:整个系统变得缓慢、昂贵且根本无法调试。当一个工作流执行失败时,工程师根本无法断定究竟是模型生成了劣质文本、做出了错误的路由选择,还是对输出结果做出了误判。这三项职能全部纠缠在同一个模型补全(Completion)调用中。
Jev 工程学通过将系统明确划分为三个层级来破除这一瓶颈:
- 大模型负责生成(LLM writes): 它负责深入研究、起草内容与生成摘要;
- Jev 负责决策(Jev decides): 它负责评估选项、对相关性打分并把控执行门控;
- 代码负责执行(Code acts): 它负责路由转发、逻辑检查、接口执行与状态验证。
每一层都有不同的接口、不同的评估准则以及完全独立的故障模式。这种拆分使得每一次系统故障都变得可追踪、可调试,因为工程师能立刻定位问题是由哪一层引发的。
B. 本文贡献
本文主要做出三项贡献:
- 阐明 Jev 工程学的本质: 它并不是一种新的大语言模型,而是一个返回概率而非散文文本的类型化决策接口;
- 总结工程实操方法: 详细阐述状态设计、问题契约、置信度阈值以及“观察-决策-门控-执行-验证(observe-decide-gate-execute-verify)”闭环;
- 梳理量化价值场景: 标定 Jev 能够带来可衡量投资回报的构建场景、评测基准与业务用例,展示类型化决策在速度、成本与稳定性上超越通用 LLM 调用的实际表现。
二、什么是 JEV 工程学
A. 核心原则
Jev 是 TypeSafe AI 研发的专用决策模型。它位于智能体系统的中枢,接收应用程序当前的最新状态以及一组预定义好的问题,随后返回附带相关概率和置信度分数的类型化决策。外部模型、智能体、工具和确定性代码随后执行所选定的动作。这种决策权与执行权的彻底分离,使得系统具备了更高的可靠性、模块化程度与可扩展性。
其底层逻辑是从自由提示词(Prompts)向类型化契约(Typed Contracts)的根本转变。传统的 LLM 调用是发送一段提示词并接收一大段文本段落;而 Jev 调用则是发送结构化的应用状态与类型化问题,并接收带有概率分布的结构化答案。它的响应结果不是段落,而是一个以问题名称为键的答案对象(Answers Object)。你的主程序可以直接读取这些数据,完成校验并选择对应分支。
B. 系统一(System One)接口
Jev 通过其“系统一(System One)”接口对外暴露三种基础问题类型。每种类型返回不同形态的答案,分别针对不同维度的判断场景:
表 I:三种类型化问题
| 问题类型 | 返回值 | 适用场景 |
|---|---|---|
| Choice(单选) | 唯一胜出项 + 概率分布 + 置信度 | 严格只应有一个选项胜出(路由分流、动作选定) |
| Score(评分) | 标尺评分区间 + 概率分布 + 置信度 | 需要有序等级度量(复杂度评级、相关度、输出质量) |
| Noul(二值概率) | 为“是”的概率值(0 到 1) | 二元判断(审批放行、任务是否完工、风险识别) |
这种限制是经过深思熟虑的。通过将输出严格限定在这三种类型化格式内,Jev 彻底消除了困扰自由格式 LLM 输出的解析难题。模型返回的内容不存在任何歧义:Choice 必然返回一个胜出项;Score 必然返回标尺上的数值;Noul 必然返回一个概率值。代码可以直接消费这些结果,无需编写复杂的正则表达式、JSON 提取逻辑或通过繁复的提示词工程来硬性约束格式。
C. 状态即证据,而非提示词
“状态(State)”是 Jev 在做评估时所依赖的当前应用程序快照。一份有效的状态应当清晰列出目标、已验证的证据、规则策略、当前可用操作以及历史操作记录。0xCodila 操作手册明确提出了这一原则:状态“不应把指令隐藏在散文中,也不应强迫模型去费力重构你的软件本来就已经掌握的事实信息。” Jev 是分别接收状态数据与各个类型化问题的。这种解耦保证了决策上下文始终是结构化、机器可读的,绝不会被掩埋在大段的文字描述中。
state = {
 "goal": task,
 "evidence": verified_facts,
 "rules": policy,
 "available_actions": live_actions,
 "previous_actions": history
}
每次外部动作发生后,必须重新构建状态。 浏览器的点击改变了页面,工具调用修改了数据库,工作进程生成了新的产物——下一次决策必须看到最新鲜的真实状态,而不是缓存的陈旧摘要。这种“实时重建”的要求正是 Jev 系统具备自我纠错能力的核心基石:确保每一次决策都基于当下的真实环境,而非过时的旧表征。
D. 问题即契约
每一个问题都必须具备原子性(Atomic):即一个具备领域知识的人根据给定的证据能够迅速做出的单一判断。如果一个问题同时混杂了紧急程度、安全风险与业务相关性,操作手册要求必须将其拆分为三个独立的问题,并在业务代码中对三者的输出结果进行组合判定。这种原子性保证了 Jev 决策的可组合性。在单次 API 调用中,你可以针对完全相同的状态并发提出多个互不干扰的独立问题,每个问题都会返回独立的类型化答案。
判定准则(Criteria)应当描述客观可观测的情境,而不是机械地重复标签名称。手册中给出了一个生动的例子:为一个名为“research(调研)”的路由分支配置“research”作为判定准则,是非常薄弱的;更强有力的准则是:“该任务在动笔撰写之前,需要检索或验证外部证据”。之所以有这一要求,是因为模型评估的是准则文本的具体内涵,而不是选项标签本身。薄弱模糊的准则会导致路由分流模棱两可;严谨具象的准则才能带来始终一致的决策。
三、如何使用 JEV
A. 七大工程法则
综合官方文档与 0xCodila 实践手册,构建高可用 Jev 系统需遵循以下七条工程法则:
表 II:JEV 工程学的七大法则
| # | 核心法则 | 为什么重要 |
|---|---|---|
| 1 | 传递证据,而非提示词 (Send evidence, not prompts) |
状态必须是供模型评估的结构化数据,而不是供其盲目遵循的指令。 |
| 2 | 将问题写成契约 (Write the question as a contract) |
具备显式准则的类型化问题能从根本上消除文本解析的歧义。 |
| 3 | 每步执行后重建选项 (Rebuild options after each step) |
陈旧的动作菜单会导致模型选择已经在环境中不存在的无效动作。 |
| 4 | 单次调用合并提问 (Ask in one call) |
针对同一状态并发提交多个判定问题,能将网络延迟和调用成本降低 10 至 12 倍。 |
| 5 | 基于置信度进行门控 (Gate on confidence) |
利用置信度阈值,将低风险的自动路由与高风险的人工介入严格区分开。 |
| 6 | 在代码中做检查,而非在模型中 (Check in code, not in model) |
权限认证、调用预算和速率限制属于确定性策略,绝不能交由模型去主观臆断。 |
| 7 | 按完整任务核算成本 (Count cost per task) |
整个工作流的真实成本应涵盖数据检索、多步决策、失败兜底、重试机制以及人工介入的总开销。 |
B. 决策闭环
Jev 的部署应用是一个持续迭代的闭环,而非孤立的单次调用。0xCodila 手册将该循环定义为六个阶段:观察(Observe)、决策(Decide)、门控(Gate)、执行(Execute)、验证(Verify)、重复(Repeat)。每个阶段都有明确的责任归属:
- 观察: 从外部系统中采集新鲜真实的状态;
- 决策: 将状态与预设问题提交给 Jev;
- 门控: 在业务代码中应用置信度阈值进行合规拦截;
- 执行: 严格只执行单一选定动作;
- 验证: 再次读取外部系统,确认动作产生的实际影响;
- 重复: 根据验证后的最新结果重新构建状态,重新进入下一轮循环。
其最核心的技术洞见在于:Jev 只掌管分叉路口的选择权,而代码与工作智能体始终掌握执行权、记忆管理与最终验证权。 模型永远不会直接去执行任何外部操作。它只能在宿主程序提供的严格受限的选项集合中做选择。代码首先校验该选择是否合规,随后才调用底层执行。这种边界控制赋予了系统极强的容错与故障恢复能力:选错的路径可以被完整记录并升级上报;而一个由大模型凭空幻觉出来的未知工具名称在物理上根本无法执行,因为候选集合中压根就不存在这项配置。
C. 置信度门控路由
置信度是从答案的概率分布中推导得出的,它绝不等于 100% 的正确性保证。手册建议根据业务后果的严重程度来划定差异化的阈值门槛:
- 低风险的内部打标分类任务,达到 0.70 的置信度即可自动放行路由;
- 浏览器端自动化操作,通常需要达到 0.85 以上;
- 涉及对外公开发布内容、发起资金支付或删除数据的高危操作,必须要求确定性代码规则检查加上人工最终审批。
这一操作铁律被清晰地定性为:“模型负责提议分支,代码决定该分支是否被允许执行。绝不允许模型概率越过系统权限、预算上限、调用频率限制或不可逆操作的控制底线。”
表 III:各动作类型的置信度准入门槛
| 动作类型 | 初始准入门槛(Starting Gate) | 失败兜底策略(Fallback) |
|---|---|---|
| 内部打标(Internal label) | 0.70 | 直接采纳(Accept) |
| 智能体交接(Agent handoff) | 0.80 | 重新评估(Re-evaluate) |
| 浏览器/工具动作(Browser/tool action) | 0.90 | 请求人工介入(Ask human) |
| 公开发布/支付/删除(Publish/pay/delete) | 确定性策略检查 + 人工审批 | 阻断执行(Block) |
D. 并行问题:单次状态,单次调用
在实际生产中,最显著的性能优化来自于消除串行的决策调用。TypeSafe 在其公开的 GDPR 合规判定实验中展示了这一机制:针对一篇长达 53,777 个字符的法规条款,在单次调用中并发评估 13 个独立问题仅耗时 0.27 秒,成本为 0.000497 美元;而如果将这 13 个问题以串行方式分批次单独发送,总耗时达 2.71 秒,费用为 0.006090 美元。单次调用在速度上提升了 10 倍,成本降低了 12.2 倍。 唯一的前提约束是:共享同一次调用的多个问题,必须能够基于完全相同的输入状态独立作答。如果问题 B 的判定必须依赖问题 A 的结论,则必须拆分为第二个决策步骤。
E. 环境搭建:路径 A 与路径 B
实践手册定义了两种接入路径:
- 路径 A(Path A): 直接使用 TypeSafe 官方提供的 SDK,并配置 Jev 原生 API Key;
- 路径 B(Path B): 采用“系统一适配器(System One Adapter)”。这是一个即插即用的客户端模块,底层代理至 OpenAI 或 Anthropic 的接口,但能输出完全一致的类型化响应格式。
需要明确的是,适配器方案本质上并不是 Jev,它无法完全还原 Jev 的极低延迟、极低成本与概率标定水准;但它能完整复刻相同的软件交互接口,使得工程师在正式接入 Jev 之前,就能完成整套外围系统的构建与测试评估。一旦获得原生访问权限,团队只需切换客户端连接层,重放相同的已标注测试集,并重新校准置信度阈值即可——因为通用 LLM 与专用 Jev 输出的概率分布形态是不可互换的。
四、JEV 在何处创造价值
A. 决策密度论
当以下三个条件同时满足时,Jev 将释放出巨大的工程价值:
- 决策空间严格有界(路由分流、排序筛选、审批判定);
- 决策行为呈现超高频重复;
- 输出结果直接流向下游软件接口(完全无需人类阅读散文)。
当单次决策的成本低到可以忽略不计时,软件系统便有能力去全面评估每一条消息、每一个候选对象、每一份草稿、每一次工具调用和每一次智能体之间的交接,而无需再像过去那样为了节省成本而只在关键节点做小样本抽检。这就是决策密度论(Decision Density Thesis):系统的工程价值会随着决策执行频次的提升而产生复合式增长。
B. 浏览器智能体
开源项目 Browser Use 对 Jev 的集成最为典型地体现了这一模式。该智能体将当前网页渲染解析为一个可见 UI 元素的结构化表格,Jev 负责挑选一个操作指令以及与之匹配的控件目标;只有当确实需要在输入框中撰写大量文本时,才会唤起一个轻量级文本模型。每次鼠标点击后,系统会重新感知页面并立即重建可用操作菜单。
在 Google Flights 自动订票演示中,该任务在 7.073 秒内全部完成。更深层次的突破在于其底层浏览器协议的交互调用次数:从常规方案的 1,092 次骤降到了 101 次,观测开销缩减了整整 10 倍。这种速度的跃升并不单纯来自决策模型本身,更来自前端观察管道与候选生成流程的协同瘦身。
C. 规模化内容质量审查
写作平台 Every 测试了利用 Jev 作为文章质量代码检查器(Linter)的表现。该测试涵盖 27 篇真实文章与 10 个合成样本,设置了 21 项质量检查规则(排查观点重复、虚假对称修辞、多余解释说明及各类编辑瑕疵)。整个批处理在不到 0.7 秒内产出了 777 项判断结果。
这是“系统一”最完美的落地形态:针对同一篇输入文档进行大规模的并行独立判断。其与 Fable 5.1 的对比极具指导意义:Jev 处理每个段落的延迟中位数仅为 0.35 秒,而 Fable 在高推理(High effort)模式下为 8.83 秒——Jev 快了约 25 倍,且成本便宜了 580 倍。不过,Fable 成功识别出了全部 7 个预先埋设的文章缺陷,而 Jev 识别出了 6 个。这清晰地确立了生产环境的标准架构:由 Jev 在边界明确的常规检查项上做持续全量过滤,仅将高度存疑的边界案例交由更强大的顶级模型做二次深度研判。
D. 销售线索评分与产品排序
求职招聘平台 HiringCafe 在其拥有 250 万月活用户的真实业务场景下,发布了一组基于人工标注的“简历-职位契合度”评测基准。Jev 的斯皮尔曼等级相关系数(Spearman correlation)达到了 0.79,单次评估成本仅为 0.02 美元;相比之下,Gemini Flash-lite 的相关系数为 0.72(成本 0.29 美元),DeepSeek Flash 的相关系数为 0.77(成本 0.14 美元)。
这并不意味着 Jev 在一切领域都全面占优,它所证明的是:在排序召回流水线内部,一个类型化的 Score 完全可以取代冗长反复的文本生成过程,在取得与人类主观裁定相同甚至更高契合度的同时,将计算成本压缩 7 到 14 倍。
E. 法律检索与重排序
在一份官方示例手册中,针对 40 个 CLERC 法律查询,首先使用 BM25 算法粗筛出 30 个段落的候选短名单,随后调用一个 Noul 判定问题来研判每个候选段落是否构成本案所引用的前置判例。通过对模型返回的置信概率由高到低重新排序,Top-1 检索准确率从 5% 飙升至 18%,Top-10 准确率从 38% 跃升至 62%。全部 1,200 次决策调用的累计总费用仅为 0.0645 美元。
该架构具备极强的普适性:先通过毫秒级确定性检索算法将成千上万的候选实体快速聚拢为一个较小的候选集,随后利用极速语义决策仅对该候选短名单进行二次高精度重排。
F. 安全与审批门控
Vercel 内部团队尝试将 Jev 用作在服务器终端执行 Shell 脚本或底层工具调用前的安全审核把关者,其 p95 延迟相比原有的全量 LLM 审查方案实现了 5 到 18 倍的加速。极速门控让“针对每一次底层操作执行逐一代码级审查”在经济上真正变得可行。当然,它依然不能取代权限隔离体系、沙箱隔离以及硬性的确定性规则策略,但它的核心价值在于,把过去由于过于昂贵、迟缓而无法逐次执行的安全合规检查,下沉到了每一次动作中。
G. 技能路由
TypeSafe 的 Hermes 实战手册基于包含 182 种技能的 Nous Research 技能库进行了路由测试:第一步请求针对全局技能索引进行排序,并判定当前交互轮次是否需要加载任何外部技能;第二步请求读取排名前三的技能详情,并保留“拒绝所有候选项”的权力。在针对 Claude Haiku 4.5 开展的 488 次真实请求测试中,错误技能挂载率从 16.8% 下降至 7.3%,多余技能加载率从 9.8% 降至 4.0%。
但测试同样揭示了一条不可忽视的客观现实:在纠正 37 个错误初选判定的同时,系统也伴生了 7 个原本正确但被意外打乱的新错误案例。这一现象提醒开发者:引入外部建议机制,有可能对智能体原先能够正常处理的简单请求造成干扰。
五、五大反模式
表 IV:JEV 工程学五大反模式
| # | 反模式名称 | 典型表象(Symptom) | 修复方案(Fix) |
|---|---|---|---|
| 1 | 提示词即状态 (Prompt-as-State) |
状态对象中充斥着隐晦的自然语言指令,而非机器可读的结构化客观证据。 | 严格使用标准化显式字段:目标(goal)、证据(evidence)、规则(rules)、动作选项(options)、操作历史(history)。 |
| 2 | 单选冒充多标签 (Choice-as-Multi-Label) |
在多个条件可能同时并存成立的场景下,强行要求 Choice 单选接口只挑选一个胜出者。 | 针对多标签场景采用相互独立的 Noul 进行二元判定,并在业务代码中对结果执行逻辑合并。 |
| 3 | 无证据完工 (DONE Without Proof) |
仅仅因为模型声称任务“DONE”,智能体便直接全盘采纳完成状态,完全不读取外部世界真实数据。 | 每次模型主张完工后,必须重新读取外部产物并强制运行自动化验收测试(Acceptance Test)。 |
| 4 | 动作菜单陈旧 (Stale Action Menu) |
状态发生变更迁移后,供模型选择的操作集合仍然包含已失效或不可达的历史选项。 | 在发起每一次决策判定前,必须基于最新真实状态重新计算并生成候选动作菜单。 |
| 5 | 置信度等同真实性 (Confidence-as-Truth) |
将模型返回的高置信度直接等同于事实逻辑上的绝对正确。 | 在带标签的数据集上实测划定阈值,永远在代码中保留兜底放弃(Abstain)分支,高危场景必须强制引入人工二次确认。 |
在生产环境中,反模式 #3(无证据完工,DONE Without Proof)是破坏性最大、最危险的设计陷阱。 实践手册给出了极其明确的准则:“永远不要把模型输出的完工标签当作最终事实。系统验证必须物理检查受影响的文件、页面、数据库记录、支付凭证、消息通知或外部真实状态。”
这正是演示 Demo 与工业级生产系统之间的分水岭:Demo 只要模型吐出“DONE”就戛然而止,而生产系统只有在外部客观现实通过状态验证后才会确认终止。
六、JEV 与通用大模型调用的对比
表 V:结构化架构对比
| 评测维度 | Jev(系统一) | 通用大模型调用(General LLM Call) |
|---|---|---|
| 输入形式 | 结构化状态 + 类型化问题契约 | 自然语言自由提示词(Prompt) |
| 输出形式 | 数值概率、分布区间、置信度 | 自由格式的非结构化散文/文本 |
| 解析开销 | 无(原生类型化数据结构) | 繁复的正则表达式、JSON 字段提取、解析重试死循环 |
| 并行查询能力 | 支持单次调用并发解答多个问题 | 单次调用仅限单个问题(或依赖长链提示词串行推理) |
| 调试与排障 | 直接审查输出的概率分布与阈值截断线 | 重新人工通读长篇大论的生成文本找问题 |
| 计费定价模式 | 按决策次数计费(每次决策仅几厘钱) | 按 Token 吞吐计费(随输出文本长度成倍递增) |
| 最适配场景 | 高频次、边界清晰的有界决策 | 开放式文本生成、发散性创意创作 |
这一对比清晰地表明,两者是协同互补关系,而非零和竞争关系。Jev 在分叉路口取代了笨重的大模型;而在一切需要内容生产与生成的环节(写作、提炼长文本、开放式调研、初稿起草),通用 LLM 依然是无可替代的中坚力量。
当两个层级各自在其专属的优势域内运转时,整个智能体系统才能爆发出最强性能。0xCodila 手册将其架构哲学精辟地凝练为十二字箴言:
“代码负责计算,大模型负责创造,Jev 负责决策,最新状态验证一切。”
(Code computes. LLMs create. Jev decides. Fresh state proves the result.)
七、实战案例
A. 邮件自动分流与处置流水线
业务场景: 利用 Jev 驱动的分类引擎处理 500 封日常涌入的企业邮件。
- 第 1 步:构建状态(State Construction)。 针对每封邮件组装专属状态对象,涵盖发件人元数据、主题、历史往来记录、发件人信誉分、企业通信合规规则以及当前可用路由分支(回复 reply、等待 wait、归为垃圾 junk、上报升级 escalate)。
- 第 2 步:并发提问(Parallel Questions)。 针对单封邮件发起一次合并 API 请求,同时提出四个问题:
- Choice:选定最佳路由路径;
- Noul:判定时效紧迫性(是否需要当天紧急响应?);
- Noul:研判伪造发件人冒充欺诈风险;
- Noul:判定操作是否需要人工审批。四个问题针对同一状态各自完成独立评估。
- 第 3 步:置信度门控(Confidence Gating)。 应用预设防线:置信度高于 0.90 自动打标归入垃圾邮件;置信度高于 0.80 自动归入等待队列;置信度低于 0.70 或发件人伪造概率超过 0.30 时,系统自动挂起并打上标记移交人工审核。只有顺利跨过置信度门槛的“回复”邮件,才被允许放行流转至下游的草稿生成 LLM。
- 第 4 步:动作执行(Execution)。 生成式大模型接单并自动拟写回复草稿。Jev 全程不参与文字生成。业务代码完成邮件标签的物理变更。人工审核团队最终只需面对过滤后极少数被打标的复杂边缘邮件。
- 第 5 步:外部验证(Verification)。 动作落地后依次复核:垃圾标签是否成功打在数据库中?草稿箱内是否生成了对应草稿?升级告警工单是否被客服系统成功接收入库?将本次决策链路的完整数据追踪落盘记录,用于后续安全审计。
最终成效: 工程师 Riley Brown 的实网测试显示,系统在短短数秒内完整处理了 500 封邮件,总 API 成本仅花费 3.5 美分。人工审核队列大幅收缩,技术人员只需聚焦于真正模棱两可的棘手个案。其核心工程价值远不仅是单纯的吞吐速度,更在于它彻底拔掉了原先卡住整条业务流的人工邮件分拣“大栓塞”。
B. 学术研究动态流分类流水线
业务场景: 将 1,018 篇最新 AI 学术论文自动聚类、筛选到 24 个精选垂直研究专题中。
- 第 1 步:生成层处理(Generation Layer)。 调用极低廉的文本生成模型,将每篇论文的标题和摘要提炼浓缩为一个结构化表达:包括核心创新贡献、方法论和所属领域。这是生成式 LLM 最擅长的工作:为 Jev 的评估清洗出高纯度的输入表征。
- 第 2 步:决策层处理(Decision Layer)。 Jev 接收该提炼摘要作为状态,并在单次调用中并发回答三个问题:
- Choice:在 24 个细分主题中匹配归属(24 个选项);
- Score:针对目标读者画像申报的学术兴趣进行相关度标尺打分;
- Noul:二元判定该论文是否具备足够质量入选精选信息流。
- 第 3 步:代码层处理(Code Layer)。 系统代码层执行硬性过滤拦截:仅当收录概率超过 0.60 且相关性评分达到预设阈值时,论文才会被落盘写入数据库。被评定为高相关性的标杆论文,会进一步触发高阶写作模型去撰写详细深度解读;低价值论文则仅做后台访问日志留存,不对前端展现。
最终成效: 公开评测表明,该流水线平均每篇论文的端到端处理延迟仅为 256 毫秒,全部 1,018 篇论文的判定总成本仅为 0.08 美元(不含前置摘要生成的常规成本)。这展现了一条极其清爽的层级级联:大模型提炼状态表征,Jev 做出高置信类型化决策,代码完成最终存储路由。分层的结构使得每一层都可以被单独做单元测试、基准优化以及无缝替换。
八、十大 JEV 架构蓝图
以下整理了十个通用的标准化工程蓝图,详细列出了每个场景所需的状态输入、类型化问题、触发动作与验证规范:
表 VI:十套高复用 JEV 架构蓝图
| # | 蓝图名称 | 提问契约设计(Questions) | 验证指标与闭环方式(Verify) |
|---|---|---|---|
| 1 | 幕僚长路由器 (Chief of Staff Router) |
Choice: 任务分派指派人。 Score: 任务紧急严重程度。 Noul: 是否必须询问打扰用户。 |
目标微服务/部门已成功接收并确认创建该任务工单。 |
| 2 | 模型调度路由器 (Model Router) |
Choice: 匹配路由(极速小模型 / 旗舰大模型 / 人工)。 Score: 上下文复杂度打分。 |
下游处理器的 Schema 校验和输出质量检查全部通过。 |
| 3 | 技能路由器 (Skill Router) |
Choice: 最优匹配的核心技能插件。 Noul: 当前会话是否真正需要调用任何技能。 |
目标调用工具环境完成挂载并成功暴露给执行上下文。 |
| 4 | 邮件防火墙 (Email Firewall) |
Choice: 处置路由(回复 / 搁置 / 归为垃圾)。 Nouls: 紧急度判定、冒充欺诈风险分析。 |
任何对外真实发送邮件的物理动作必须经过人工点击确认。 |
| 5 | 研究动态流 (Research Feed) |
Choice: 归属专题分类。 Score: 读者画像相关性。 Noul: 是否确认入选精选流。 |
外部数据源成功去重,原始论文原始 URL 完好保存。 |
| 6 | 销售线索打分器 (Lead Scorer) |
Scores: 客户画像匹配度、采购时机成熟度。 Noul: 是否应立即触发销售人工外呼。 |
CRM 客户关系管理系统中对应的字段与状态机成功更新。 |
| 7 | 浏览器动作器 (Browser Action) |
Choice: 底层交互操作与对应目标 UI 元素。 Noul: 本阶段工作目标是否已彻底达成。 |
重新感知并截图比对网页 DOM 结构,验证动作是否产生预期改变。 |
| 8 | 安全审核门禁 (Safety Gate) |
Noul: 该操作在安全准则下是否被允许执行。 Score: 潜在有害性指数。 Choice: 处置策略(放行 / 拦截 / 人工审批)。 |
系统的不可篡改审计日志中成功写入并同步该次安全事件。 |
| 9 | 输出校验核验器 (Output Verifier) |
Nouls: 针对各项业务验收标准(Acceptance Criteria)逐一设置独立的 Noul。 | 独立运行的下游 Schema 校验、死链检查和静态文件校验均无报错。 |
| 10 | 引用与出处检查器 (Citation Checker) |
Choice: 证据是支持还是推翻前述断言。 Score: 论据支撑力度评分。 |
外部系统真实打开所声明的引用出处段落,并精准定位原文锚点。 |
这十大架构设计遵循完全相同的选型法则:
只有当候选答案空间可以被清晰约束收敛,且该决策需要以高频次发生时,才使用 Jev。
当需要凭空凭据创造内容产物时,调用通用大语言模型;
当结果可以通过公式或确定性逻辑推导得出时,直接编写代码。
同时,这十大蓝图同样受制于同一条完工铁律:
永远不要轻信模型自称已经“完成”。
闭环验证必须物理探查该动作原定应该改变的外部世界状态。
九、深入讨论
A. Jev 不适用的场景
操作手册对能力的边界保持了足够的清醒与克制:
- 确定性数学计算、日期时间的加减推算以及时间戳标准化等场景,严格属于代码的管辖范围,绝不应交给 Jev。
- 状态对象若极其臃肿,或者混入了不可信的外部脏数据,依然会给文本诱导与对抗攻击留下敞开的面。
- 类型化的固定输出结构并不能免疫提示词注入攻击(Prompt Injection)。
- 一切开放式长文创作、创意构思与自由发散的研究分析,必须依赖通用大模型,这些都不是决策模型的能力范畴。
总结起来,决策标准极其简明:答案空间有界且决策反复发生,用 Jev;必须产出全新内容,用大模型;能用公式精确算出来的,写代码。
B. 成本的反例
在 Retriever AI 的真实基准测试中,基于 Jev 驱动的 LinkedIn 和 Amazon 网页数据爬取任务虽然在速度上提升了 31% 和 43%,但由于针对包含大量冗余 DOM 节点的大型页面频繁打分,前置处理产生了额外工作,使得整体总耗费反而上涨了 38% 和 51%。
这一反例极为深刻地敲响了警钟:如果为了喂饱决策模型而导致候选数据的前置抓取与清洗准备无限膨胀,单纯决策模型单价的低廉并不能保证整个工作流最终变得更便宜。 评估 Agent 系统的唯一诚实指标是端到端单任务总成本(Total Task Cost),而非仅仅盯着单次决策调用的标价。系统的综合经济效益取决于全链路上的每一个环节,而不单单由决策层决定。
C. 与谷歌“外挂Harness假说(Harness Thesis)”的关系
谷歌在其《工业级智能体工程》(Industrial Agentic Engineering, Medrano Llamas, 2026)中提出了一个核心论点:外围的“Harness工程)”比模型本体更重要。
Jev 工程学进一步延伸了这一假说——它将线束中过去最混乱的一块拼图做了独立解耦与显式抽象:即决策职能。 在谷歌的原有语境下,Harness是由提示词、工具集合以及外挂护栏揉杂在一起的单一混合工程面;Jev 则将纯粹的“决策分叉”从这一团乱麻中彻底剥离出来,封装为一个带有严格契约的类型化接口。在文本生成领域,底层基础模型的好坏依然至关重要;但对于工作流中那些星罗棋布的决策分叉点,这种类型化的接口体系(严格契约、概率分布、置信度门控)要比底层究竟是由哪一颗模型在驱动重要得多。 这也从理论上解释了为什么前文的“适配器模式”同样能跑得通:因为在系统工程层面,接口规范与边界划分的确定性,要远远跨越底层模型权重的变迁。
D. 无人值守跨夜运行的难题
面对无人值守的离线复杂任务,工程手册给出的设计准则是:系统只允许自主执行可逆向撤回的研究分析与草稿起草;一旦遭遇关键审批红线,必须保存断点快照并主动挂起等待。每一个自治执行闭环都必须在代码层强制注入:最大迭代步数、超时断流时长、消费额度上限以及中断恢复机制。
每次因异常中断后恢复执行时,系统所要做的第一件事必须是检查外部物理世界中最后一次经过确认成功的真实动作状态,然后才允许决定是否发起幂等重试。其底层原则直截了当:
“置信度永远无法证明一份文件已经真正存盘、一条消息已经真实推送到位,或者一笔银行付款已经交易成功。”
这是 Jev 工程中最严苛的工程纪律:系统的首要设计准则是能够安全地踩下刹车并优雅停机,而不是只顾着一路狂飙盲目求快。系统的故障恢复能力是整个工作流图谱不可分割的骨架,绝非事后补救的创可贴。
E. 本文分析的局限性
文中所引述的各项基准测试数据,均采纳自业界公开发布的演示 Demo、示例手册以及特定配置下的单点测评。它们应当被视作可供复现追踪的技术线索,而非颠扑不破的通用物理常数。
Jev 属于内部机制不对外公开的商业闭源产品;“系统一适配器”能够完整映射其接口定义,但并不能完全复制其实际生产中的概率校准水准。业内目前仍缺乏大范围、独立的长期可靠性基准评测。文中所给出的各项置信度阈值建议,仅仅是推荐的工程冷启动基准线,在未经特定业务域充分的数据标定与校准前,绝不可盲目作为工业生产标准直接硬套。
十、小结
Jev 工程学为智能体系统引入了一套清晰的权责解耦哲学:大模型负责生成,Jev 负责决策,代码负责执行。
基于 Choice、Score、Noul 构建的类型化决策接口,从根源上扫除了长期以来因自由格式 LLM 输出而带来的解析脆弱性与系统不确定性。提炼出的七条工程法则,为工业界构建高可用、高自愈的决策闭环提供了高度可复用的实战框架。大量的实战用例早已印证,系统价值会随着决策密度的提升而爆发:0.7 秒内并发裁定 777 次质量审查、以 3.5 美分的极低成本完成 500 封邮件的精准分流、浏览器底层调用开销从 1,092 次骤降至 101 次。
这套方法论的生命力并不受限于 Jev 这一单一商业产品本身。任何一套软件系统,只要它坚持将决策逻辑与最终执行权做物理隔离、采用类型化契约取代黑盒自由提示词、依托置信度阈值对高危操作实行门控拦截,并始终面向外部客观状态做物理闭环验证,它所能达到的工程可靠性,就必然能够全方位碾压那些把所有鸡蛋装在同一个 LLM 补全调用里的脆弱系统。
Jev 是这一先进工程设计理念在当下的具象化落地,而这套方法论所蕴含的严密工程纪律,其生命周期必将远比任何单颗具体的模型更加持久。
下一代智能体系统的技术突围,绝不再取决于让模型坐着冥想死磕更长的时间。真正的赢家,必将属于那些在别人还在慢吞吞憋单次长思考输出时、就已经在毫秒级内完成成千上万次有界决策的系统。
原文链接:https://drive.google.com/file/d/1msvc8bs373_RuM5BpBgcKifgFWJyPcqm/view
致谢
本综述文档旨在提供学术研讨与技术学习参考。内容综合整理并提炼自 TypeSafe AI 官方公开资料、0xCodila 团队工程实践手册及开源社区公开的系统集成案例。本文未受 TypeSafe AI、0xCodila 或文中所提及任何商业实体的赞助、背书或授权。文中所含结构图示均为重新绘制的原创架构表达。
参考文献
- [1] TypeSafe AI, “System One API Reference,” docs.typesafe.ai, 2026.
- [2] TypeSafe AI, “State Design,” docs.typesafe.ai, 2026.
- [3] TypeSafe AI, “Typed Primitives: Choice, Score, Noul,” docs.typesafe.ai, 2026.
- [4] TypeSafe AI, “Confidence and Thresholds,” docs.typesafe.ai, 2026.
- [5] 0xCodila, “Jev Engineering: 10-Page Playbook,” Sept. 2026.
- [6] Browser Use, “Jev Ultrafast Agent,” open-source, 2026.
- [7] Every, “Independent Jev Quality Test,” public report, 2026.
- [8] HiringCafe, “Resume-to-Job Relevance Benchmark,” public evaluation, 2026.
- [9] TypeSafe AI, “Legal Re-Ranking Cookbook (CLERC),” 2026.
- [10] TypeSafe AI, “Hermes Skill Suggestion Cookbook,” 2026.
- [11] Riley Brown, “Email Classification Demo,” public post, 2026.
- [12] Retriever AI, “LinkedIn and Amazon Browser Benchmark,” 2026.
- [13] Vercel, “Safety Gate Testing,” public report, 2026.
- [14] LangChain, “ModelRouterMiddleware Integration,” public, 2026.
- [15] TypeSafe AI, “Parallel Questions GDPR Experiment,” 2026.
- [16] Cua, “Computer-Use Experiment,” public demo, 2026.
附录 A:术语速查表
表 VI(附):核心术语释义
| 核心术语 | 工业定义 |
|---|---|
| Jev | 由 TypeSafe AI 研发的专用决策模型,能够基于输入状态返回附带概率分布的类型化解答(Choice, Score, Noul)。 |
| 系统一(System One) | 应用程序向 Jev 提交状态并获取类型化判断结果的标准 API 接口。 |
| Choice(单选) | 一种类型化提问形式,用于从限定候选项中决出单一胜出者,并同步返回各选项概率分布与置信度。 |
| Score(评分) | 一种类型化提问形式,用于在预设的连续/离散标尺上锚定评分,并返回其数值结果与置信度。 |
| Noul(二值概率) | 一种类型化提问形式,用于输出特定是/否判断命题为真的概率值(介于 0 到 1 之间)。 |
| 状态(State) | 应用程序当下的结构化快照,通常包含目标(goal)、证据(evidence)、规则(rules)、可用动作(options)与历史(history)。 |
| 置信度(Confidence) | 从模型返回的概率分布离散度中数学推导得出的指标;专门用于下游路由门控分流,绝不可直接当成绝对事实正确性的背书。 |
| 决策密度(Decision Density) | 一种工程假说:当单次决策的边际成本趋近于零时,在系统运行的每一个微小原子步骤都注入严密决策,能催生出巨大的复合系统价值。 |
| 适配器(Adapter) | 一套即插即用的客户端垫片组件,底层通过接入 OpenAI/Anthropic 等通用 LLM 接口,完全模拟出系统一的输出规范,用于项目早期的前置开发与流程验证。 |
附录 B:上线部署检查清单
在将任何基于 Jev 驱动的工作流正式发布上线前,请逐一核验以下工程规范:
- 明确基准线: 明确一项可重复发生的有界决策场景,并搭建好一套未接入 Jev 的传统对比基线用于效能对照。
- 构建标定集: 收集整理完备的标注数据集:必须覆盖明确正例、模糊边缘案例、无匹配无效输入以及恶意诱导对抗样本。
- 显式状态建模: 严格定义状态数据 Schema,确保具备清晰的显式字段(目标 goal、客观证据 evidence、策略规则 rules、动作选项 options、操作历史 history)。
- 契约原子化: 编写具备原子性、且判定准则客观可观测的 Choice、Score 和 Noul 类型化提问契约。
- 动作受限闭环: 交互菜单中严格只提供当下真实存活、且具备完整授权的操作项,并在选项中强制常驻人工接管或主动弃权(Abstain)分支。
- 数据量化定标: 在带标注验证集上实测评估系统的决策质量、概率校准曲线、响应延迟、综合成本及请求打回升级率。
- 差异化安全门禁: 根据下游动作的破坏性与商业后果严重级别,精细化配置阶梯式的置信度准入门槛。
- 版本锁定与归档: 在生产配置中死锁决策模型的具体发布版本号,并在数据湖中完整落盘保存包含所有输入输出的结构化审计日志。
- 单步可逆执行: 规定系统的每次迭代循环物理上严格只准许执行一步具备逆向撤销能力的操作,并在执行完毕后立刻物理重读全新状态。
- 外部真实性核验: 编写自动化探针,严格依据物理外部环境的客观改变来做业务完成度验收,绝不相信模型单方面的完工主张。
- 鲁棒容灾压测: 强制进行异常边界注入测试,全面演练网络超时中断、Token/资金预算耗尽以及意外断电后的状态断点自愈机制。
- 端到端全口径核算: 综合考量涵盖数据前置检索、多次辅助决策、失败回退处理、重试容错以及人工介入在内的全口径单任务总成本,而非仅仅计算决策接口的 API 标价。
本文档为研究性综述。文中所有图表均为重新制作的原创设计。文章所涉技术剖析均基于截至 2026 年 9 月公开可查的技术资料编写。
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。