本文永久链接 – https://tonybai.com/2026/09/20/jev-typesafe-system-one-model-intro
大家好,我是Tony Bai。
【导读】
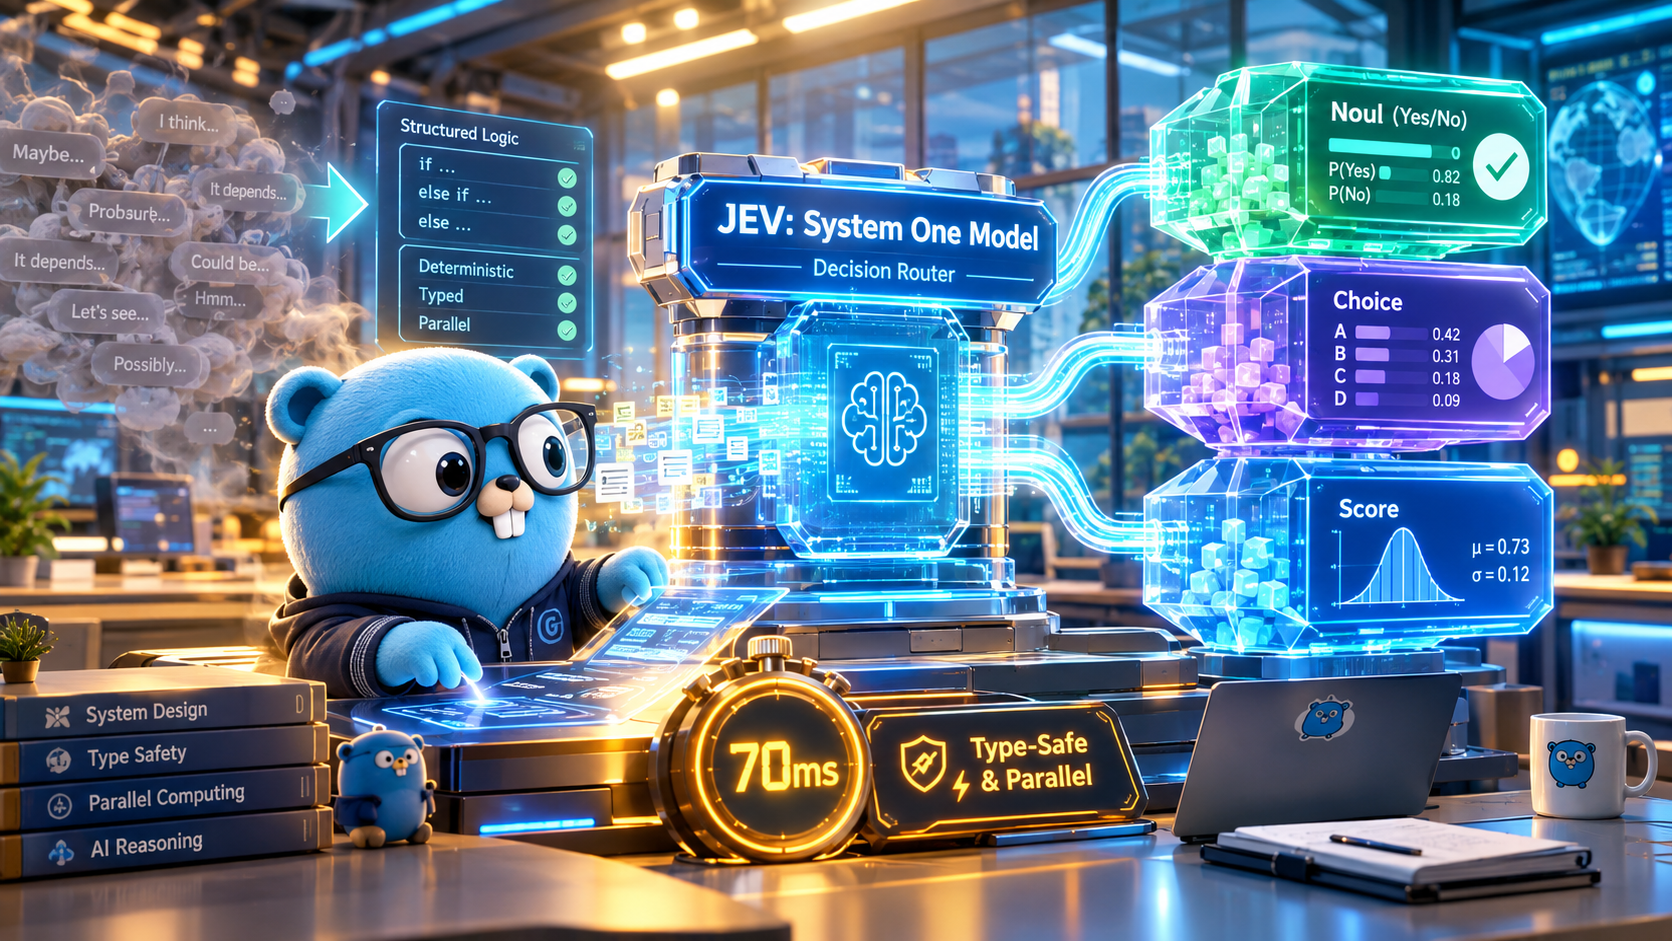
一个只会做判断题、不会聊天的 AI 模型,近日在硅谷杀出重围:响应时间以毫秒计,价格便宜到“输出免费”,官方甚至放话“结构上不可能产生幻觉”。它不是又一个大模型,而是想成为软件里那个最聪明的 if 语句。
【文章要点】
- 新物种:TypeSafe 发布的 JEV 不是聊天模型,而是“System One 模型”——一个只做结构化判断、不生成文本的决策引擎。
- 性能颠覆:官方宣称响应时间在 70~500 毫秒之间,比同等智能的大模型快 40~200 倍;输入价格约为每百万 token 0.042 美元,输出免费。
- 三种原语:JEV 只支持三类问题——Noul(是非判断)、Choice(多选一)、Score(打分),每个答案都自带概率分布和置信度。
- 结构性“零幻觉”:由于输出永远落在预先定义的选项集合内,JEV 在类型层面不可能“答错格式”,但这不等于判断内容一定正确。
- 生态已跟进:LangChain 推出
TypeSafeClassifier与AutoModeMiddleware,Vercel AI SDK 通过experimental_evaluate原生支持 JEV,用于模型路由、工具风险拦截等场景。 - 边界清晰:JEV 不会写代码、不会生成文本、不擅长精确计数和日期比较,本质上是给软件系统“装了一个更聪明的 if 语句”,而不是替代大模型。

一个只会做判断题、不会聊天的 AI 模型,正在悄悄接管软件里的每一个 if 语句。
今天,硅谷 AI 实验室 TypeSafe AI 正式结束隐身状态,发布了自己的首个产品:一个名为 JEV 的模型。
如果你以为这又是一个“更快、更便宜的 GPT 平替”,那可能猜错了方向。JEV 的创始人 Diogo Almeida 曾在 OpenAI 参与打造了让大模型学会“听懂指令、好好聊天”的关键方法,那套方法后来成为了 ChatGPT 的技术基石之一。但这一次,他给出的答案完全相反:JEV 不生成文字,甚至不会写一个完整的句子。
它的唯一任务,是把一段“状态信息”和一组“预先定义好的问题”,转换成一份带概率的、类型安全的答案——是或否、选项 A 还是选项 B、在一个量表上打几分。TypeSafe 把这一类模型统称为 System One 模型,JEV 是其中第一个公开产品。
官方给出的数字相当夸张:端到端响应时间 70~500 毫秒,比同等智能水平的大模型快 40~200 倍;输入价格约为每百万 token 0.042 美元(十亿 token 仅 42 美元),输出完全免费;因为答案永远落在你预先定义好的选项范围内,官方称这在结构上“不可能产生幻觉”。
这篇文章会带你搞清楚三件事:JEV 到底是什么、它是怎么做到这些数字的、以及它应该被放在你系统里的哪个位置。
JEV 是什么:一句话讲清楚
最简单的理解方式是这样的:JEV 是一个会思考的 if 语句。
普通代码只能对“能被计算机直接判断”的条件分支,比如 if (order.total > 100)。但现实世界里,大量判断依赖的是语义而非数值:这条工单是不是很紧急?这封邮件属于哪个部门?这段代码改动的风险有多高?以前,这类“模糊判断”要么靠人工规则硬编码,要么训练一个专用分类器,要么直接调用一个通用大模型让它输出结构化 JSON。
JEV 提供了第四条路:你在请求里预先定义好所有可能的答案形状(是非题、多选题、打分题),JEV 只需要在这个封闭空间里给出一个带概率的答案,然后把控制权交还给代码。
一次典型的调用大概长这样(示例改写自官方文档场景):
{
  "model": "jev-latest",
  "state": {
    "ticket": "支付页面在 Safari 上点击导出按钮会直接崩溃,Chrome 上正常。"
  },
  "questions": {
    "category": {
      "type": "choice",
      "instructions": "这条工单属于哪一类?",
      "criteria": {
        "bug_report": "系统出现异常或行为不符合预期",
        "feature_request": "希望获得一个尚不存在的功能",
        "billing": "涉及扣费、发票、退款"
      }
    },
    "severity": {
      "type": "score",
      "instructions": "这个问题有多严重?",
      "criteria": [
        "纯外观问题,不影响功能",
        "功能受损但存在绕过方案",
        "阻断性问题,没有绕过方案"
      ]
    }
  }
}
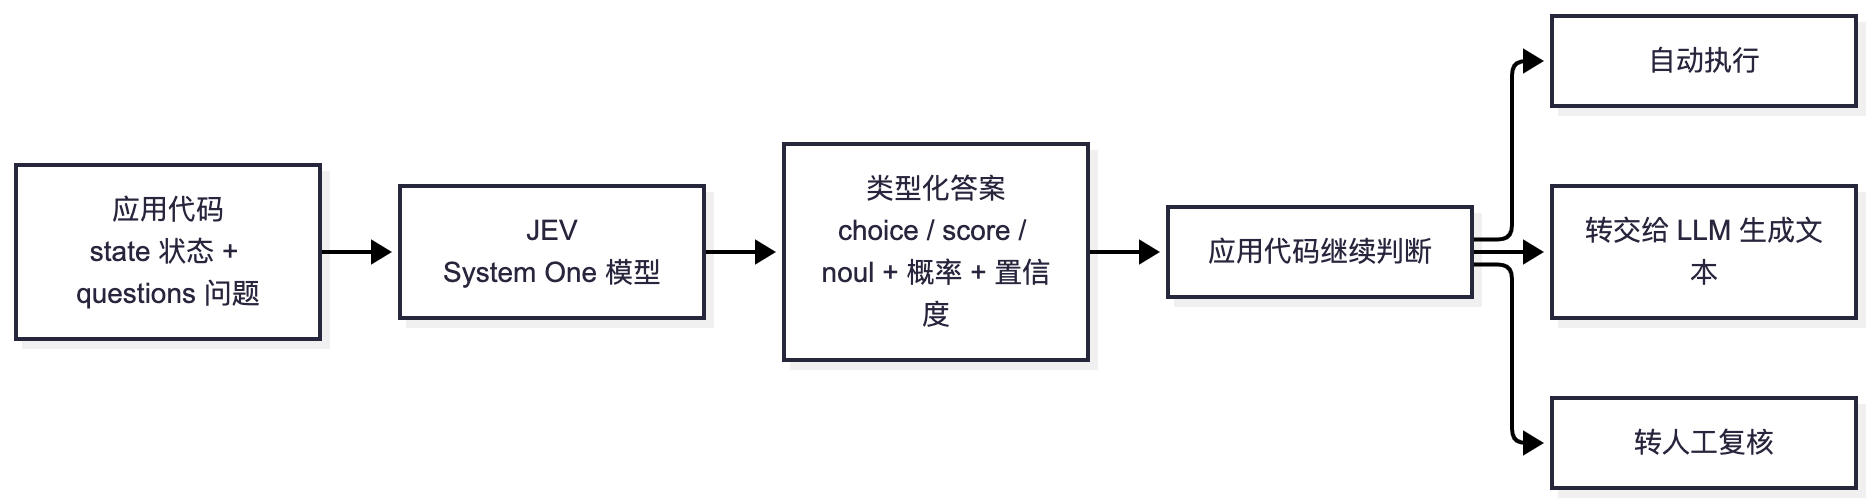
返回结果不是一段话,而是一份结构化数据:每个问题对应一个答案、一份概率分布,外加一个置信度分数。代码拿到这份结果后,剩下的事情——路由到哪个团队、要不要自动回复、需不需要转人工——全部由普通的 if / switch 逻辑完成。整个过程里,没有一行需要被“解析”的自然语言。
下面这张图展示了 JEV 在一次调用中所处的位置:
名字从哪来:System One 与 Jevons 悖论
TypeSafe 在官方博客里专门解释了命名逻辑,这两个典故也能帮助理解产品定位。
System One(系统一) 来自行为经济学家丹尼尔·卡尼曼的《思考,快与慢》。书中把人类思维分为快速直觉的“系统一”和缓慢深思的“系统二”。TypeSafe 的类比是:JEV 负责的是那些“系统一”式的快速判断,而需要深度推理、生成长文本的任务,仍然应该交给通用大模型这样的“系统二”选手。
Jev 这个名字,则致敬了 19 世纪经济学家威廉·斯坦利·杰文斯(William Stanley Jevons)。他提出的“杰文斯悖论”指出:蒸汽机效率提升之后,煤炭消耗量不但没有下降,反而因为新用途的出现而上升了。TypeSafe 的押注逻辑是:当“做一次判断”的成本被打到接近于零,原本“不划算调用 LLM”的场景会被大规模开启,智能的总消耗量只会更高,而不是更低。
技术内核:从“逐词生成”到“并行采样”
要理解 JEV 为什么快,得先理解它和传统 LLM 在采样方式上的根本区别。
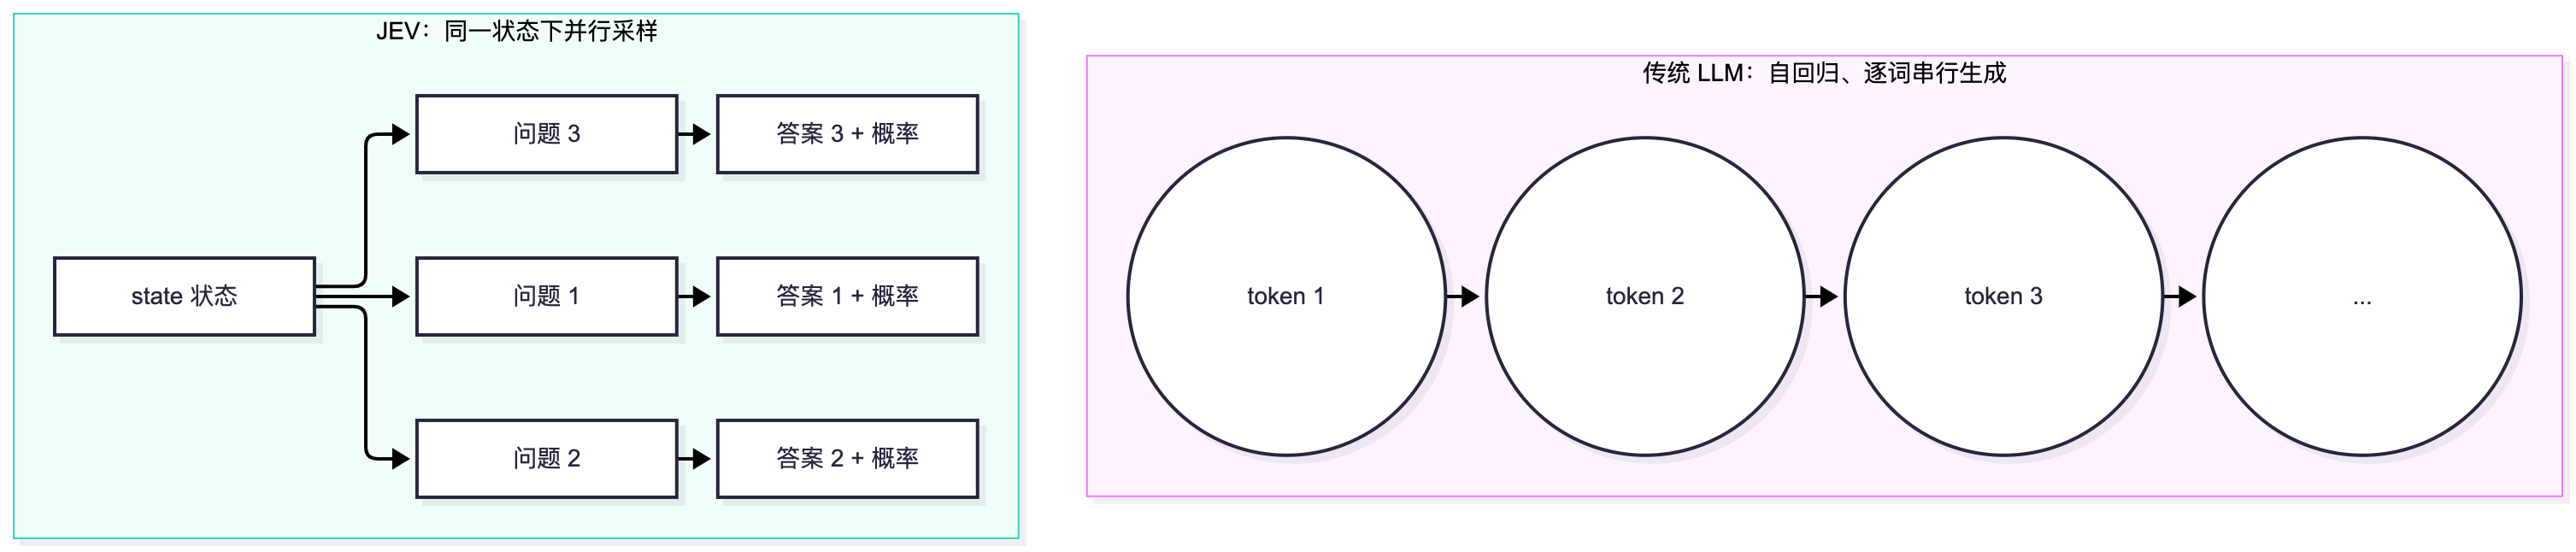
一个通用大模型生成 {"category": "billing", "urgent": true} 这样的结构化输出时,本质上仍然是在逐个 token 地生成文字,每一个 token 都依赖前面已经生成的内容——哪怕外面套了一层 JSON Schema 约束,生成过程本身依然是串行的、按顺序进行的。这也是为什么给大模型加“结构化输出”能保证格式基本正确,但没办法从根本上改变响应延迟。
TypeSafe 采用的架构不同:同一个 state 下的所有 questions,会被模型并行、独立地评估,一次查询直接输出所有问题对应的概率分布,而不需要像文字生成那样“边写边想”。这意味着往一次请求里多加几个问题,几乎不会显著拉长响应时间——它消耗的只是这几个问题本身的 token 成本。
三种问题原语:Noul、Choice、Score
JEV 把所有可能的判断,收敛成了三种“问题类型”,这也是理解它使用方式的关键。
| 类型 | 对应的问题形态 | 返回内容 |
|---|---|---|
| Noul | 是非判断(是不是、有没有) | noul:一个 0 到 1 之间的概率值 |
| Choice | 多选一(在若干选项中选一个) | choice(最高概率选项)+ probabilities(全部选项的概率分布)+ confidence(置信度) |
| Score | 在一个有序量表上打分 | score(概率加权后的连续值)+ legend(各档位说明)+ probabilities + confidence |
三者的设计有一些共同的使用经验,值得单独说明:
Noul 适合“是不是”这种二元判断,比如“用户是否要求退款”。返回值越接近 1 代表越可能为真,越接近 0.5 说明模型本身也很纠结——这时候提高问题描述的清晰度,往往比换个模型更有效。
Choice 适合互斥的分类问题,比如“这条消息应该路由给哪个部门”。官方文档建议,只要选项列表可能覆盖不到所有情况,就应该加一个“其他”选项,否则模型会被迫在不合适的选项里“矮子里拔将军”。
Score 适合有顺序、但没有精确数值的判断,比如“这个 bug 有多严重”。这里有一个容易踩的坑:档位描述应该写“具体情境”,而不是写“轻度 / 中度 / 重度”这类抽象程度词——前者能让模型有东西可以比对,后者只会让概率被摊得到处都是。
三种类型合在一起使用时,还能组合出更复杂的判断逻辑。比如把“问题严重度”、“客户情绪”、“工单信息完整度”分别拆成三个 Score,再在代码里按权重加权求和,就得到一个可解释、可调参的优先级打分——这比让模型直接给出一个“综合优先级”要稳定得多,也更方便事后调试。
State 与 Confidence:喂什么数据、怎么读结果
State(状态) 是所有问题共享的上下文,可以是一段纯文本,也可以是一个带字段的 JSON 对象,甚至是一组对话记录。资料中反复强调的一条经验是:state 里只放问题真正需要的信息,无关内容混进去只会拉低判断准确率——这和往大模型 prompt 里塞一堆无关材料会拖累效果是同一个道理。
Confidence(置信度) 则是 JEV 相比“普通结构化输出”最实用的差异点。每个 Choice 和 Score 答案都自带一个置信度分数:概率集中在某一个选项上,置信度就高;概率被摊得很分散,置信度就低。开发者可以据此设计一套“分层响应”策略——
- 高置信度:直接自动执行;
- 中等置信度:执行但加一道确认,或者标记复核;
- 低置信度:转交人工,或者转交给更强的通用大模型重新判断。
这里有一个容易被忽视但很重要的细节:置信度高,只代表“在大量类似判断里,这个置信度对应的准确率会更高”,不代表这一次具体答案一定正确。把阈值设在哪里,本质上取决于“判断错了要付出多大代价”——这是一个业务决策,而不是模型能替你做的决策。
性能与成本:官方给出的数字
以下是 TypeSafe 官方发布博客中给出的对比数据:
| 维度 | 传统大语言模型 | JEV / System One |
|---|---|---|
| 训练方法 | 基于人类反馈的强化学习(RLHF)/ 可验证奖励强化学习(RLVR) | 面向校准决策的强化学习(RLCD) |
| 优化目标 | 人类更偏好的回答、可程序化验证的输出 | 概率与真实结果相匹配的"校准"决策 |
| 输出形态 | 自由文本字符串,需要额外解析和校验 | 预先定义好结构的类型化数值,天然合法 |
| 采样方式 | 逐 token 串行生成 | 同一状态下并行评估所有问题 |
| 输入价格 | 每百万 token 约 0.2~10 美元 | 每百万 token 约 0.042 美元 |
| 输出价格 | 通常是输入价格的数倍 | 免费(几乎无需计量) |
| 端到端响应时间 | 3~329 秒(视模型而定) | 70~500 毫秒 |
| 典型场景 | 人机对话、编程助手、可验证问题求解、原型演示 | 工作流中的智能判断、大规模数据打标、实时交互场景 |
需要提醒的是,官方也在文中做了不少“划重点”式的自我修正:所测速度是在美西自有服务器上跑出来的,实际跨区域访问会有额外网络延迟;193.6 倍更快、444.6 倍更便宜这两个headline数字来自官方自建的 workflow 评测集,官方自己也承认这属于“现实场景中的较高值”,不建议直接当作普遍预期。
JEV 在 Agent 循环中的位置:不是替代者,而是“守门员”
一个常见的误解是,把 JEV 理解成“更便宜的 ChatGPT”。但从 LangChain 官方博客的解读来看,JEV 更准确的定位,是塞进 Agent 循环里的一个高频、低成本决策节点。
一个典型的 Agent 循环大致是:
大模型决定下一步做什么 → 调用工具 → 观察结果 → 再决定下一步,如此循环直到任务完成。
这个循环里的每一次“决定”如果都调用一次完整的大模型对话,既慢又贵。LangChain 给出的思路是,把循环里那些“其实只是判断题”的环节,替换成一次 JEV 调用——比如判断某个工具调用是“只读操作 / 可逆操作 / 不可逆操作”,从而决定要不要在执行前先向用户确认。
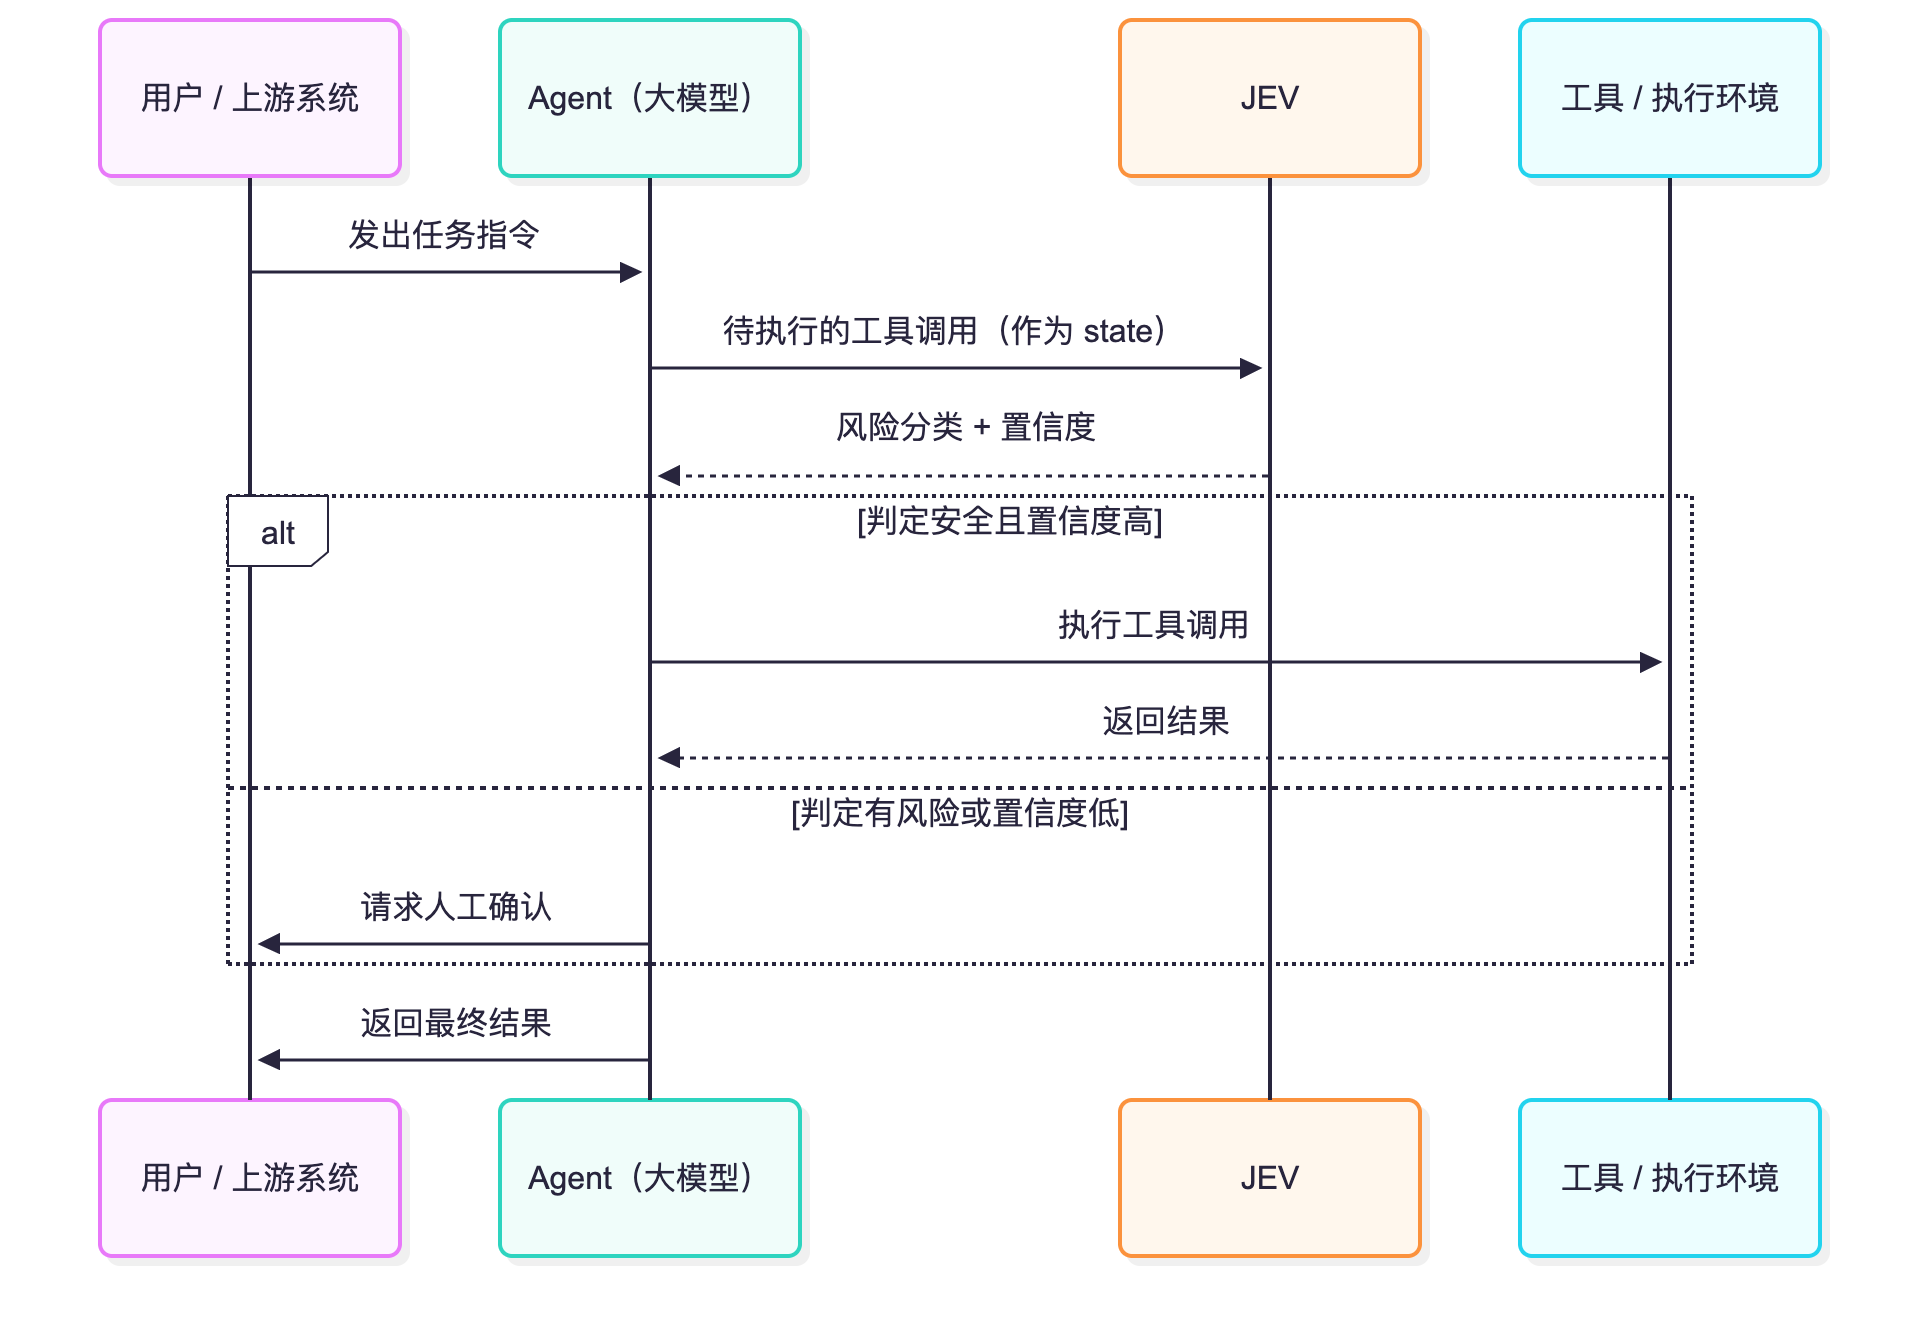
这套模式此前一直是 Claude Code、Cursor、Codex 这类商业化编程 Agent 产品闭源部分里的能力;LangChain 认为,随着 JEV 这类廉价分类模型的出现,任何自建 Agent 都可以把同样的“危险动作预判”能力接进来,而不再依赖某个厂商的闭源护栏。
生态跟进有多快:LangChain 已经把它做成中间件
JEV 发布当天,LangChain 就上线了官方集成,提供了两个开箱即用的能力:
TypeSafeClassifier:把 JEV 包装成标准的分类调用接口,输入 state 和 questions,直接拿到结构化判断结果,state 可以是文本、结构化数据,也可以是 LangChain 的消息对象,可以很方便地嵌入到已有节点或中间件里。
ModelRouterMiddleware(模型路由中间件):根据用户请求的复杂程度,让 JEV 先判断这次任务该交给“便宜快速”模型还是“强大昂贵”模型,再让 Agent 用选定的模型继续跑完整个任务。
AutoModeMiddleware(自动模式护栏中间件):在工具真正被执行之前,先用 JEV 对工具调用做一次风险分类,从而拦截可能有害的动作——这正是上一节讲到的“守门员”模式的官方实现。
除了 LangChain,Vercel AI SDK 也在同期加入了原生支持:通过 experimental_evaluate 函数直接调用 JEV,也可以通过同一个函数把同样的问题发给 OpenAI、Anthropic、Google 等模型做结构化输出对比,方便开发者在自己的数据上验证“JEV 是否真的划算”。
典型应用场景:从数据打标到实时交互
结合公开资料里出现的早期实践案例,JEV 目前被尝试用在这样几类场景里:
数据打标与分类:把大批量文本(研究论文摘要、商品列表、简历)批量跑一遍 Noul / Choice / Score 问题,成本和延迟都远低于用大模型逐条打标。
意图路由与模型路由:在真正调用昂贵模型之前,先用一次 JEV 判断用户想做什么、这次请求需要多复杂的推理能力,再决定走查数据库、走轻量模型、还是走高阶推理模型。
Agent 护栏与工具风险拦截:如上文所述,在工具执行前对动作做只读 / 可逆 / 不可逆的分类,为高风险操作加一道确认。
实时交互场景:因为单次调用只需要几百毫秒,JEV 可以被塞进“用户每次停顿打字”、“每一步游戏状态更新”这类高频场景,做实时的语气判断、危险动作判断等,这在过去调用大模型是难以承受延迟成本的。
检索与校验环节:给检索出来的候选段落打相关性分数、给生成内容里的每一句话做“是否有原文支持”的校验,都可以拆成一批 Noul / Score 问题并行完成。
需要强调的是,以上大多数还是发布仅几天内的早期实验,还谈不上大规模生产验证,读者在评估收益时,最好用“每完成一个任务的实际成本”而非“每 token 单价”来衡量,因为省下来的单价,很可能会被额外的重试、人工复核环节部分吃掉。
能力边界:JEV 不擅长什么
一个专注于结构化判断的模型,注定要在别处付出代价。这里也提一下JEV模型的几个明确边界:
- 不会生成文本:JEV 无法写邮件回复、写代码、写摘要,这类任务依然需要通用大模型。
- 不擅长精确计数与比较:数字符个数、比较两个日期先后、判断十六进制颜色是否接近,这些“计算类”任务交给 JEV 都不可靠,官方建议把这类工作交还给普通代码,JEV 只负责语义层面的抽取和分类。
- 对间接指代敏感:问题里出现“某个属性的属性”这种多层嵌套,或者双重否定,都会明显拉低准确率,最好直接点名要判断的那部分内容。
- 仍可能被误导性文本影响:state 本质上是数据,如果里面混入了刻意设计的诱导性文字,判断结果依然可能被带偏,官方也承认这是需要持续改进的方向。
- 类型安全不等于判断正确:JEV 保证返回值一定落在你预先定义的选项集合内,但并不保证选中的那个选项就是“正确答案”——这是两个完全独立的问题,值得反复强调。
写在最后
如果说过去几年 AI 领域的主线是“模型能聊多好、能写多好、能推理多深”,JEV 代表的是一条相对少有人认真投入的支线:把 AI 判断变成一种像调用函数一样廉价、可预测的基础设施能力。
它不追求成为你和 AI 对话的入口,也不打算取代任何一个生成式大模型。它想做的,是钻进你系统里那些原本靠正则表达式、硬编码规则、或者“顺手调一次 GPT”来解决的角落,把这些判断变成一次几十毫秒、几乎免费的调用。
这条路能走多远,现在下判断还为时尚早——毕竟距离发布才过去几天,大部分案例都还停留在“能跑起来”的阶段,离“扛得住真实流量”还有距离。但从 LangChain、Vercel 生态第一时间跟进集成的速度来看,至少已经有相当一部分开发者,愿意认真评估:软件里是不是真的需要一个更聪明的 if 语句。
参考资料:
- TypeSafe AI 官方发布博客:Introducing System One Models & Jev
- Flavio Copes:A deep dive into Jev, TypeSafe’s System One model
- LangChain 官方博客:Building a Harness with Jev
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。