本文永久链接 – https://tonybai.com/2026/11/22/ai-agents-apache-datafusion-influxdb-3-database-architecture
大家好,我是Tony Bai。
【导读】
过去几十年,数据库的发展一直在追求更强的通用性:一个数据库产品集成存储、索引、查询优化、执行引擎和分布式计算,尽可能满足各种业务需求。
但这种模式正在发生变化。
Apache DataFusion 的主要贡献者、InfluxDB 3.0 核心开发者 Andrew Lamb,在一次深度专访中分享了一个颇具启发性的判断:随着 AI Coding Agent 大幅降低软件开发成本,未来企业可能重新走向专用软件和定制化基础设施。
这不仅意味着 AI 正在改变应用开发,也可能改变数据库的构建方式。
从 DataFusion 如何通过动态过滤避免扫描不必要的数据,到 Parquet 如何演进以适应 AI 和向量检索,再到分布式查询引擎的构建,以及 AI 生成代码给开源社区带来的新挑战,这次专访实际上揭示了下一代数据基础设施的几个重要方向。
【文章要点】
- 数据库正在走向组件化。DataFusion 更像数据库领域的 LLVM,为开发者提供可组合的查询处理能力,而不是一个封闭的数据库产品。
- 查询优化的核心是尽可能少做无用功。动态过滤让查询执行过程中产生的信息反向影响数据扫描,实现运行时剪枝。
- 数据布局决定查询性能上限。分区、排序、聚簇以及 Parquet 元数据,共同决定查询引擎能够跳过多少数据。
- Parquet 正在适应 AI 时代的新负载。Variant、地理空间类型、向量支持和新型编码,正在扩展这一开放存储格式的能力边界。
- 分布式查询的难点不只是分配任务。Shuffle、Join、数据重分布以及故障恢复,才是真正复杂的部分。
- AI Agent 可能让专用基础设施重新繁荣。软件开发成本下降后,企业更有动力组装适合自身业务的数据系统。
- AI 也在冲击开源协作模式。代码生成越来越容易,但维护者的审查时间和社区治理能力并没有同步增长。

引言:数据库,为什么又要重新构建?
过去几十年,数据库行业形成了一种非常成熟的产品模式:数据库厂商负责存储引擎、索引、查询优化器、执行引擎和分布式调度,用户只需要选择一个数据库产品。
这种模式创造了大量优秀的数据库产品,但也带来了一个问题:每当有人想构建一种新的专用数据库,往往就不得不重新实现大量已经被解决过的问题。
例如,一个基因组分析数据库,可能需要 SQL 查询能力;一个地理空间数据库,需要复杂的空间数据处理;一个时序数据库,需要针对时间范围查询进行深度优化。
这些系统的业务领域不同,但底层有大量相同的技术需求。
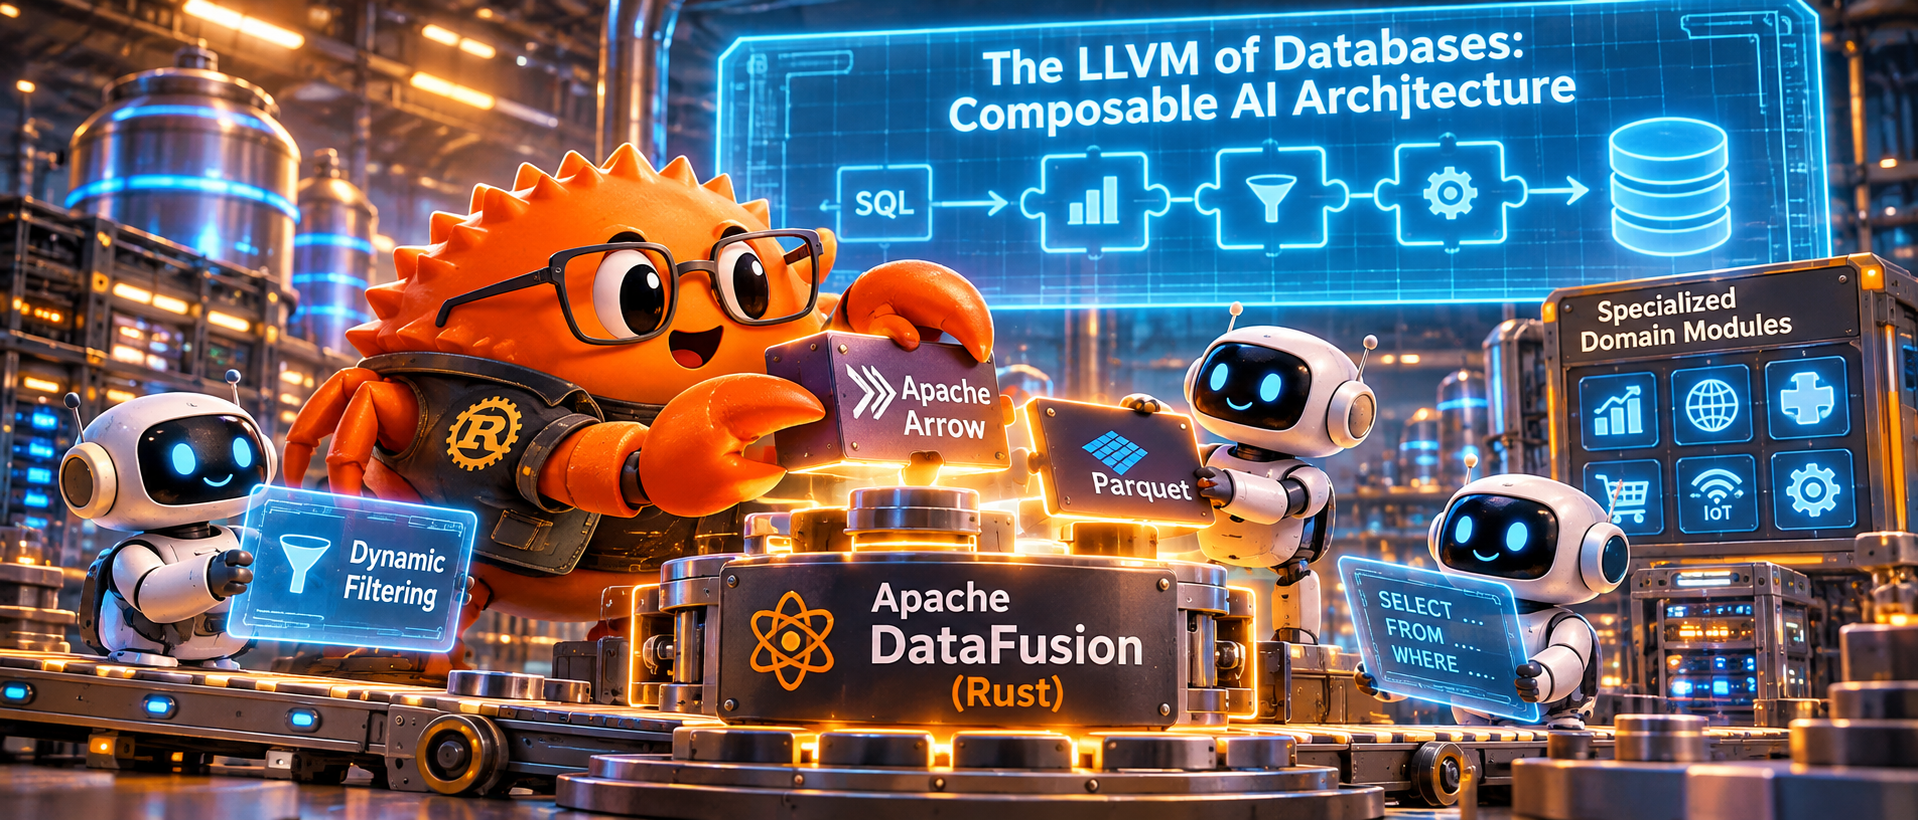
Andrew Lamb 在专访中提出了一个值得关注的趋势:数据库行业正在走向组件化。未来开发者不一定需要从零构建一个完整数据库,而是可以通过组合成熟的开源组件,构建自己的专用数据系统。
而 AI Coding Agent 的出现,可能让这一趋势进一步加速。
要理解这个变化,我们先从 Apache DataFusion 开始。
数据库领域的 LLVM:Apache DataFusion 究竟是什么?
Andrew Lamb 是 InfluxData 的 Staff Engineer,也是 Apache DataFusion、Apache Arrow 和 Apache Parquet 社区的重要贡献者。
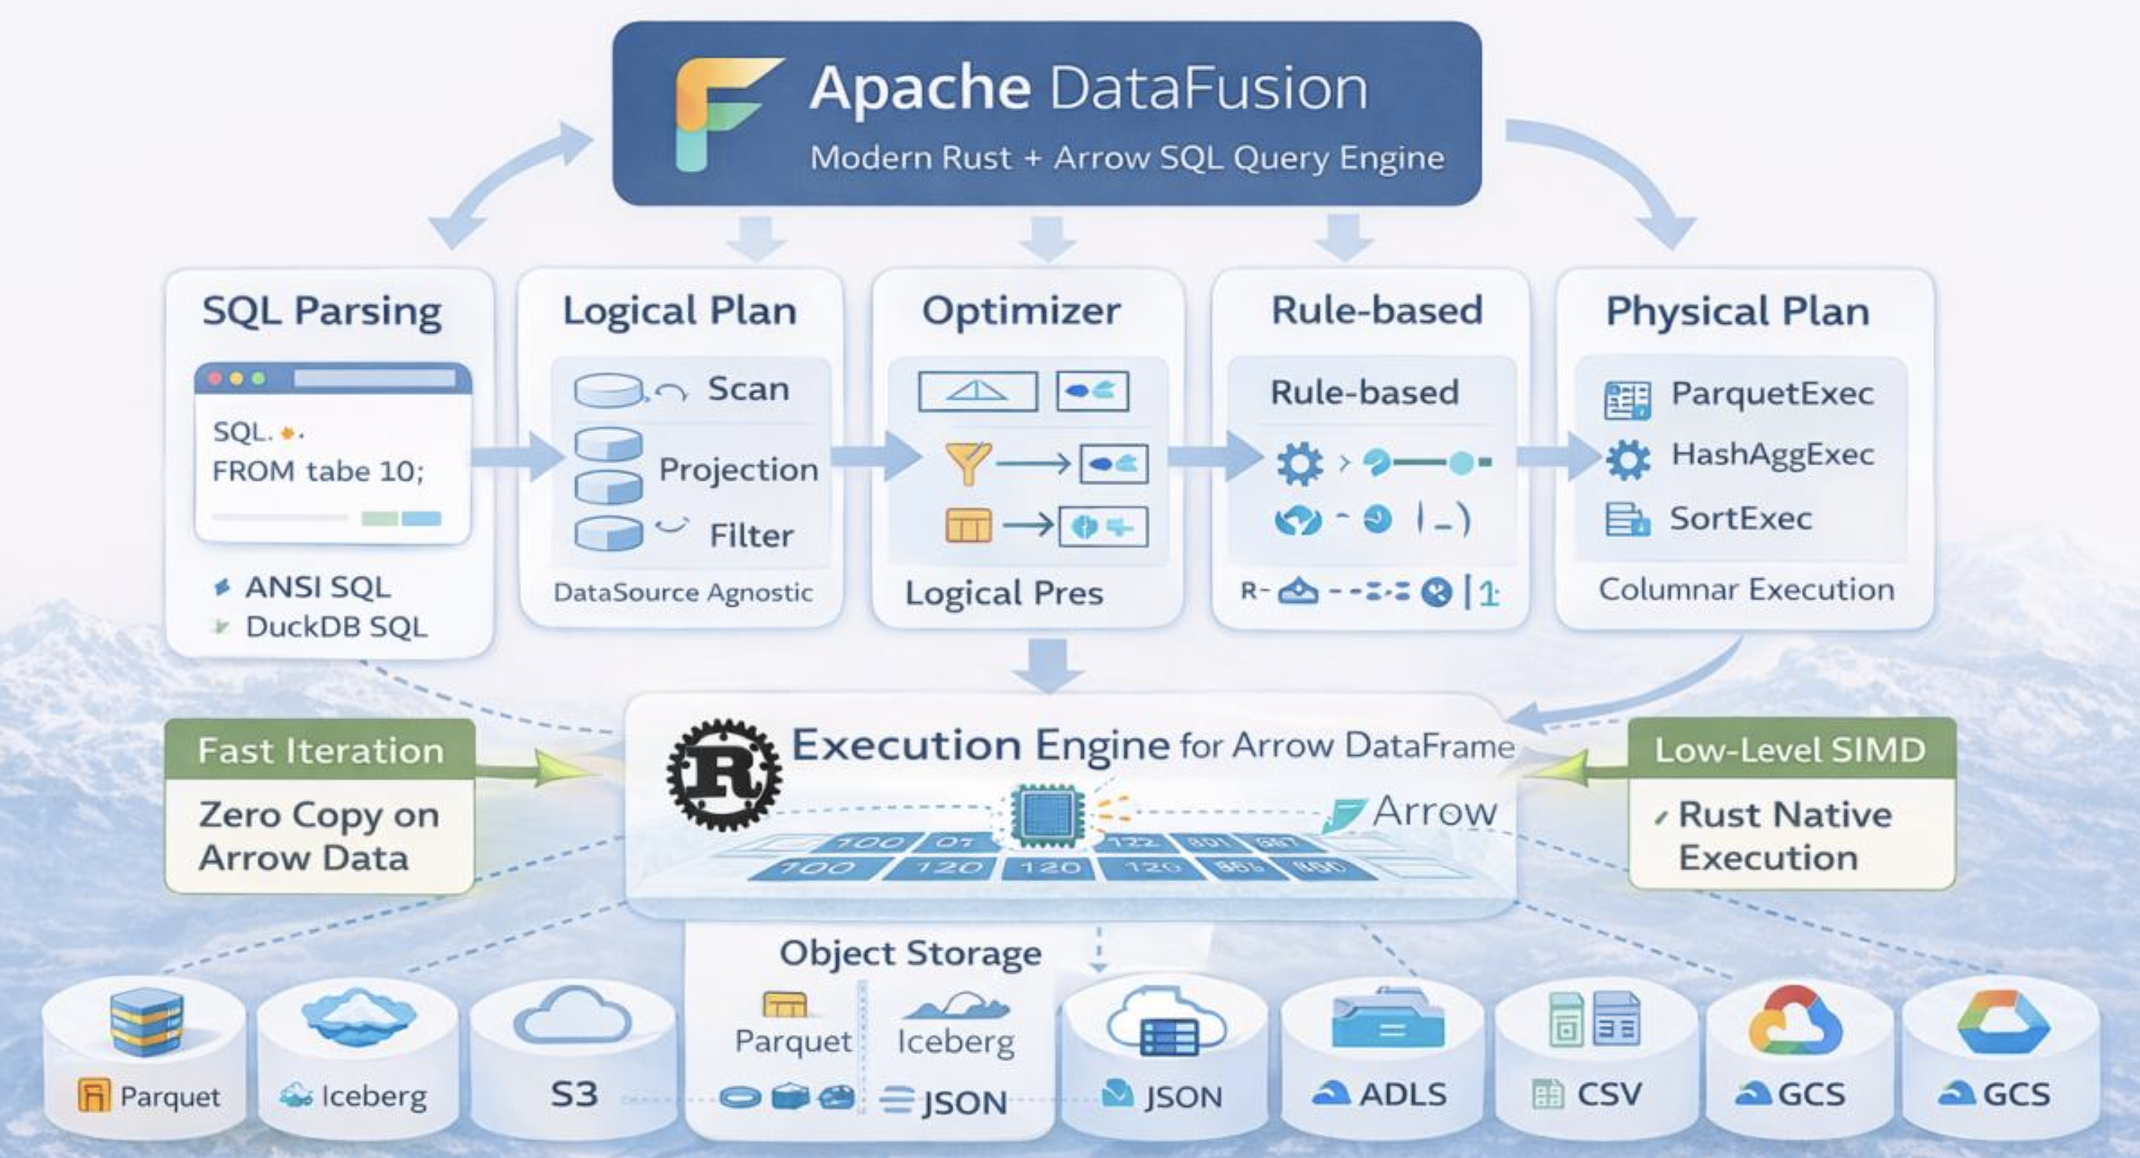
DataFusion 是一个使用 Rust 编写、基于 Apache Arrow 内存模型的可扩展查询执行框架。
它不是一个开箱即用的完整数据库,而是一套可以嵌入其他系统的查询引擎基础设施。
这里可以引入 Andrew 使用过的一个类比:DataFusion 之于数据库,有点像 LLVM 之于编译器。
LLVM 并不替你决定要构建什么编程语言,但它提供了中间表示、优化和代码生成等基础设施,让不同语言可以复用成熟的编译技术。
DataFusion 也有类似的定位:
- SQL Parser:负责 SQL 解析。
- Logical Plan:描述需要完成什么计算。
- Optimizer:对查询计划进行优化。
- Physical Plan:决定具体采用什么执行算法。
- Execution Engine:负责真正执行查询。
- Extension API:允许开发者扩展数据源、算子、Catalog、统计信息和优化规则。
这意味着,开发者可以专注于自己的业务领域,而不必重新实现一套完整的 SQL 查询引擎。
FDAP:InfluxDB 3.0 的技术基础
这里引出 InfluxDB 3.0 使用的 FDAP 技术栈:
| 组件 | 职责 |
|---|---|
| Apache Flight | 高性能数据传输 |
| Apache DataFusion | 查询规划与执行 |
| Apache Arrow | 列式内存数据表示 |
| Apache Parquet | 持久化列式存储 |
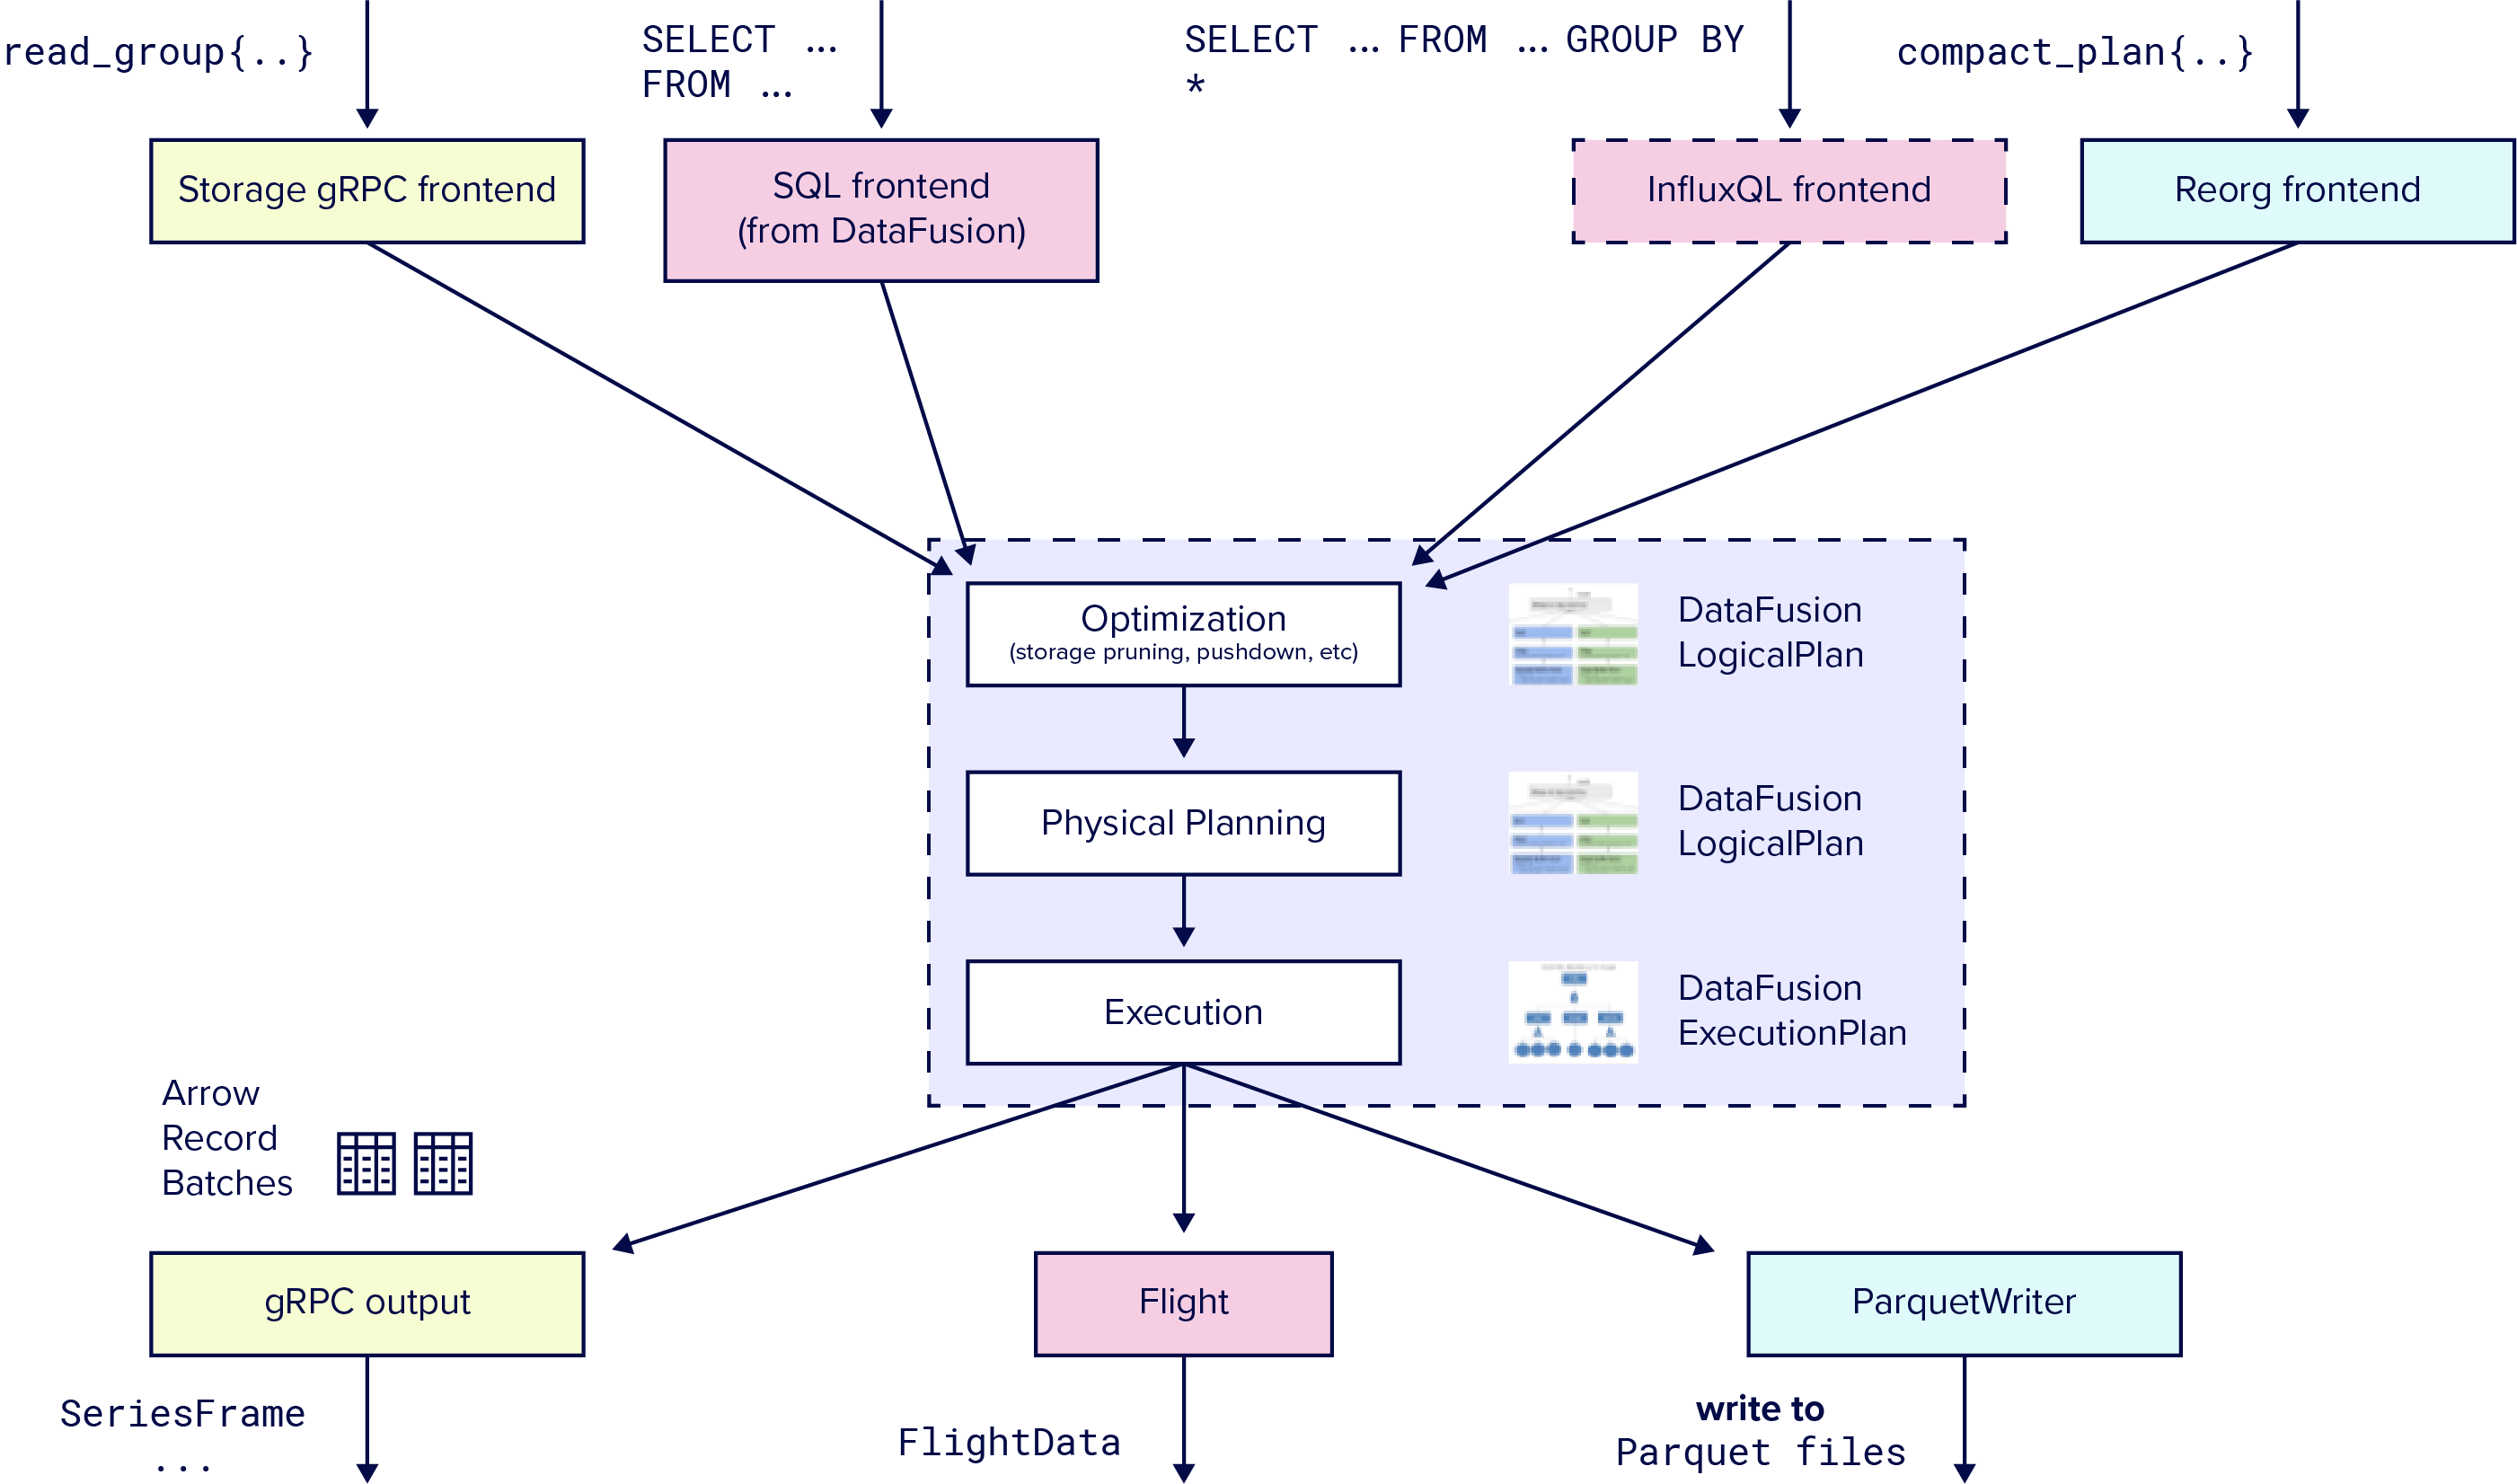
这套架构的价值在于,每个组件都可以独立演进,也可以被其他项目复用。
Andrew 提到,Apple、Cloudflare、Palantir 等公司已经在产品中使用 DataFusion。它的生态也逐渐从一个查询引擎扩展为一组可组合的基础组件。
查询引擎如何做到只读需要的数据?
为了更好地理解专访中 Andrew 提及的技术理念和架构,我们这里使用一个贯穿文章的例子。
假设我们有一个存储在 S3 上的日志系统,数据被组织成 1000 个 Parquet 文件。现在执行:
SELECT *
FROM logs
ORDER BY timestamp DESC
LIMIT 10;
我们只需要最近的 10 条日志。
一个简单的实现可能会读取全部 1000 个文件,然后排序,再取出前 10 条。
显然,这种方式浪费巨大。
DataFusion 的优化思路是:不仅要减少排序工作,还要尽可能避免读取那些不可能出现在最终结果中的数据。
从 SQL 到执行:查询经历了什么?
Andrew 将查询执行过程拆解得非常清楚。
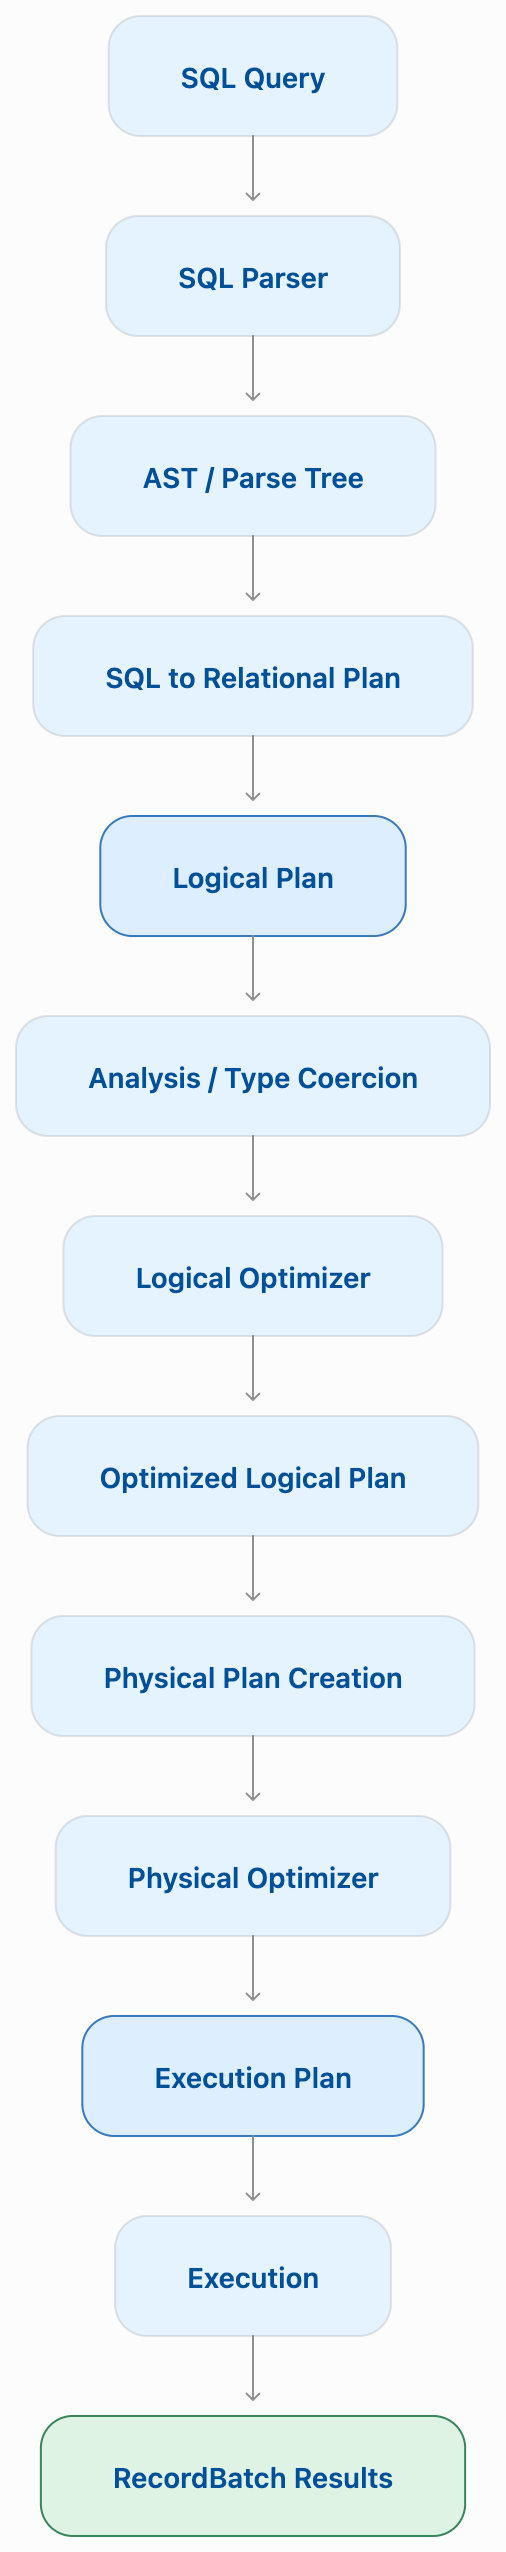
这里需要重点解释逻辑计划和物理计划的区别。
逻辑计划回答的是:我要计算什么?
例如:
- 扫描 logs 表。
- 按 timestamp 排序。
- 取前 10 条。
它不关心底层究竟有多少文件,也不决定具体使用什么排序算法。
物理计划回答的是:具体怎么计算?
例如:
- 使用哪种 Scan 算子。
- 采用 TopK 还是完整排序。
- 是否可以利用已有的数据排序属性。
- 如何读取 Parquet 文件。
- 如何利用统计信息跳过数据。
这也是数据库系统中非常重要的设计:将计算意图与具体执行方式分离。
Parquet 的多级剪枝:文件、Row Group、Page
DataFusion 不会一上来就读取全部数据。
它会充分利用 Parquet 中的元数据。
一个 Parquet 文件可以看成由多个 Row Group 组成,每个 Row Group 又包含多个 Page。
每个层次都可以提供统计信息,帮助查询引擎判断数据是否值得读取。
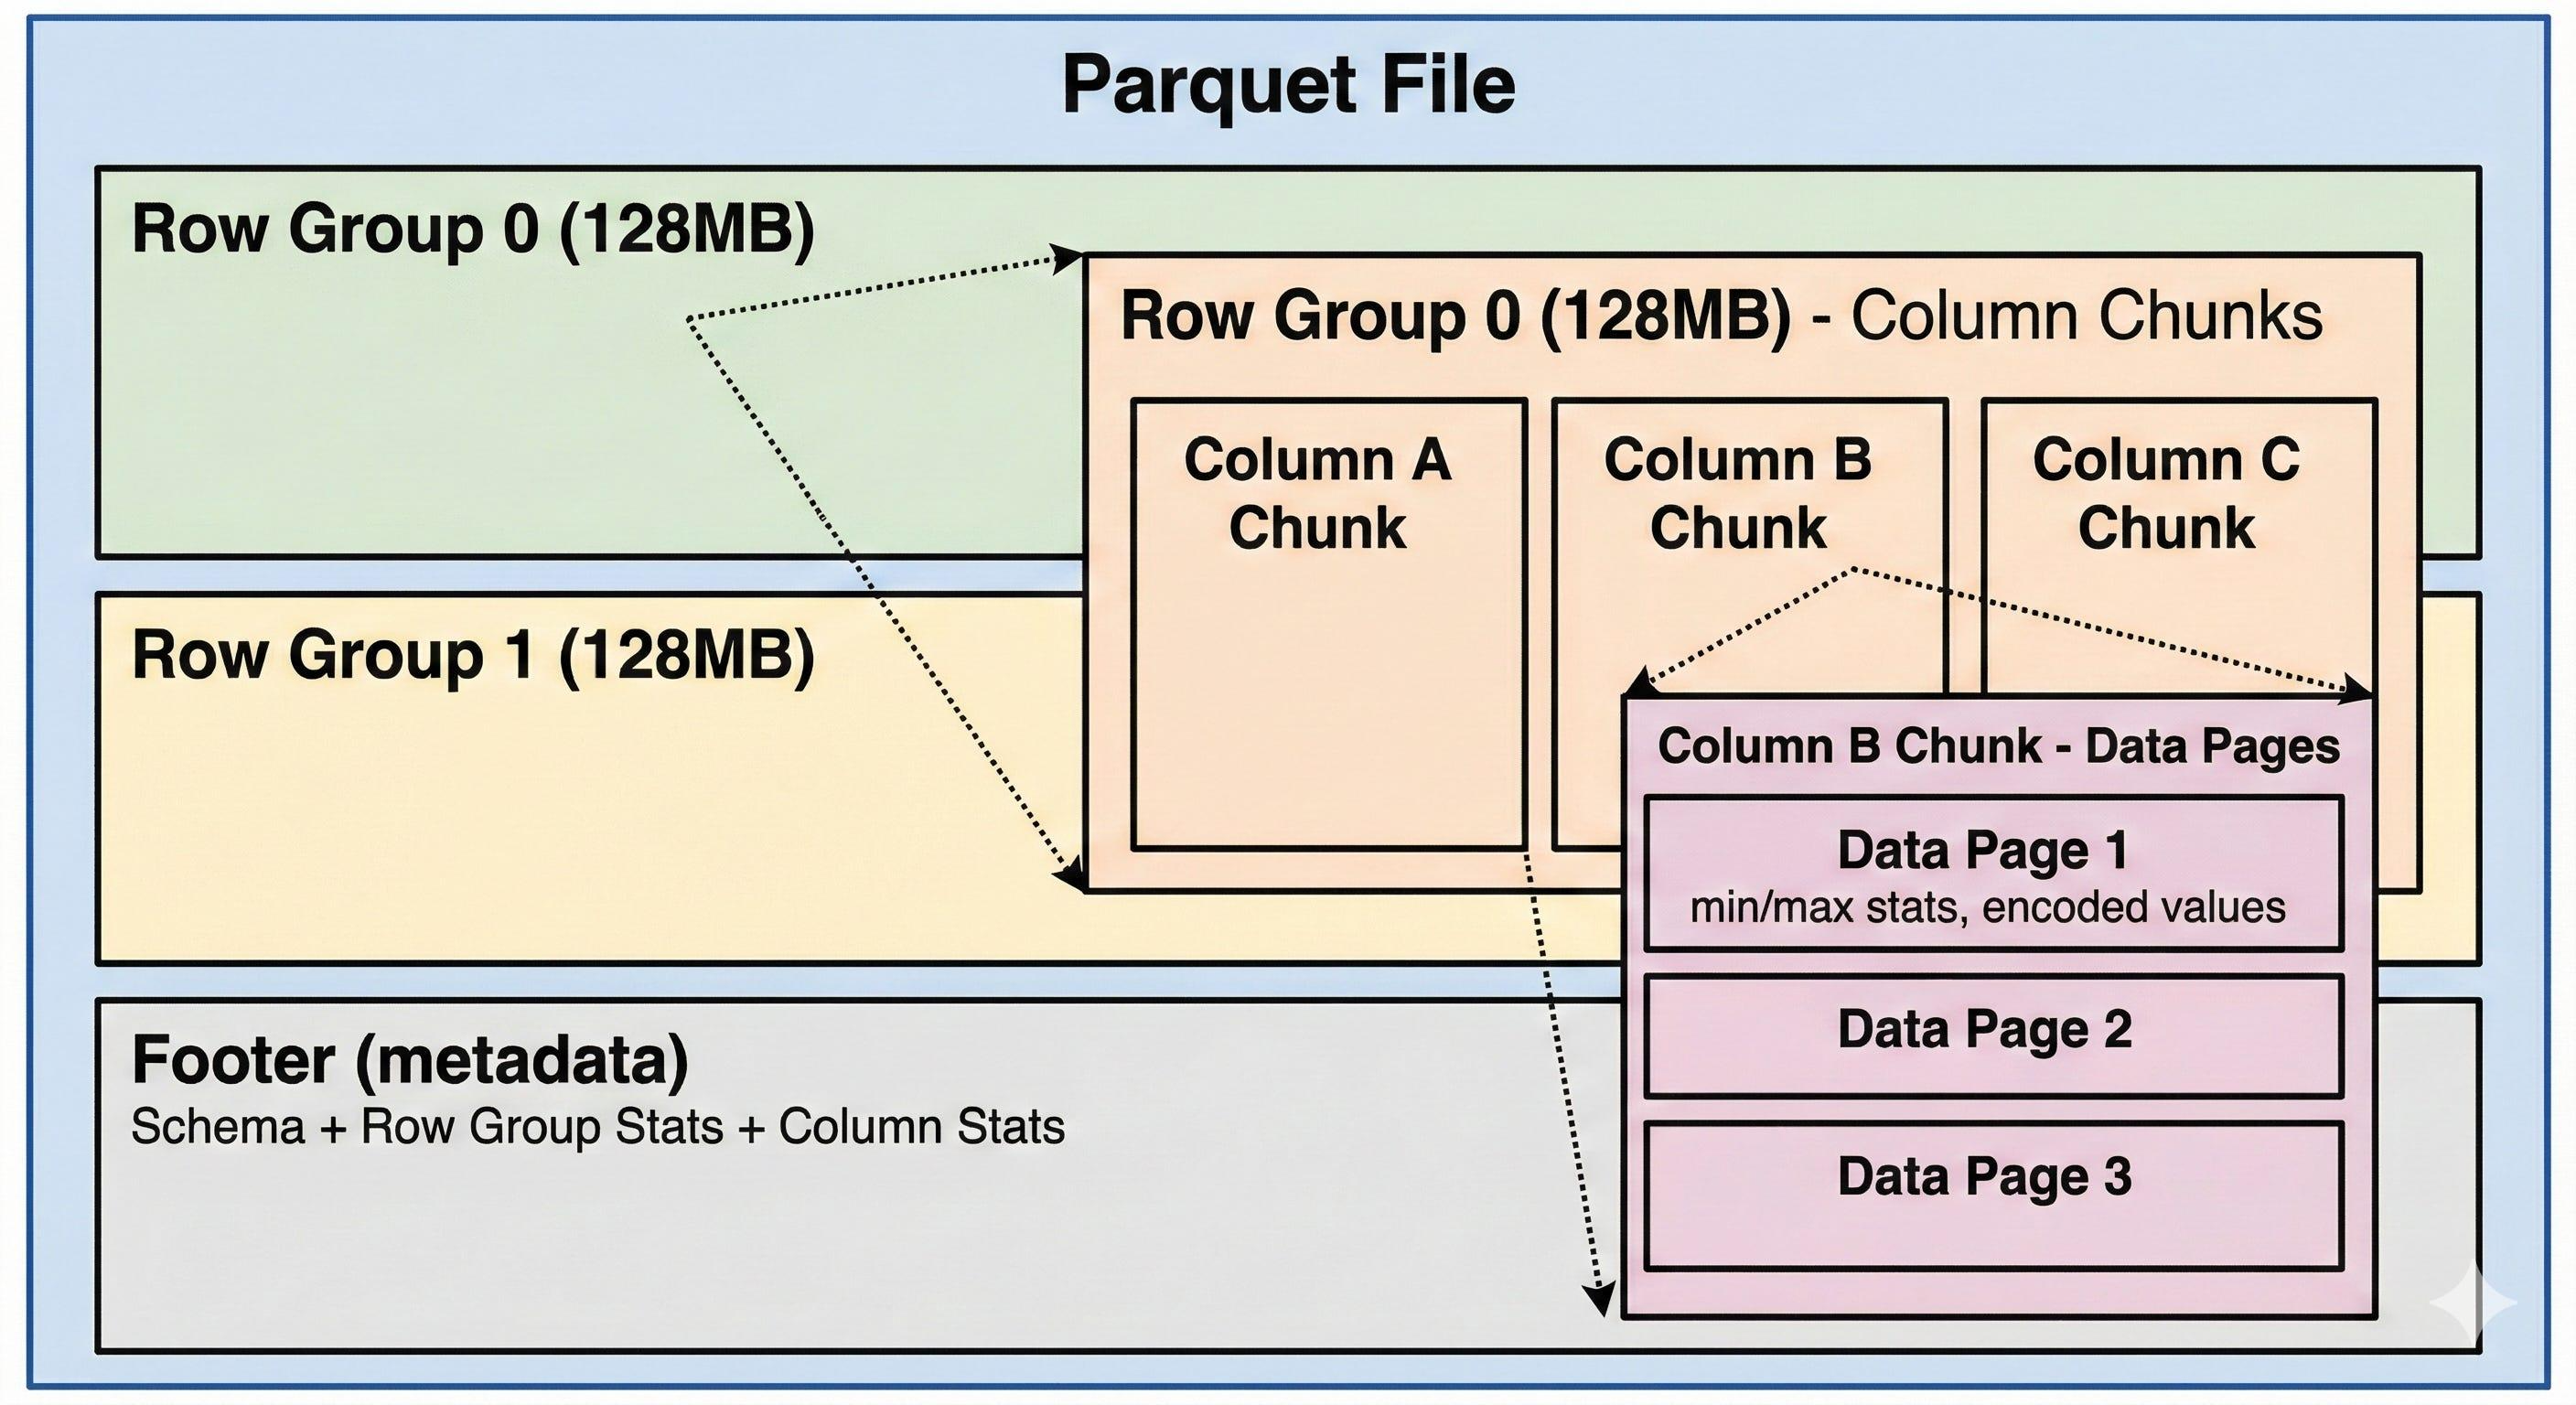
典型的优化过程:
- 文件级剪枝:根据目录分区和文件统计信息,跳过不符合条件的文件。
- Row Group 级剪枝:利用 Footer 中的 Min/Max 等统计信息,排除不可能满足条件的 Row Group。
- Page 级剪枝:利用 Page Index 等元数据,进一步缩小读取范围。
- 数据解码:最终只读取真正需要的数据。
这实际上是一种层层缩小搜索空间的策略。
动态过滤:让查询执行过程反过来指导数据扫描
这是整场专访中最值得深入展开的技术亮点。
传统的谓词下推和静态剪枝,主要依赖查询开始之前已经知道的信息。
但 TopK 查询存在一个特殊问题:我们一开始并不知道最终的第 10 大时间戳是多少。
因此,查询开始时,无法准确判断哪些文件可以被跳过。
DataFusion 引入的 Dynamic Filters(动态过滤)解决了这个问题。
其工作过程如下:
- TopK 算子使用一个 Heap,维护当前最好的 10 条记录。
- 随着数据不断进入,TopK 持续更新当前第 10 名的边界值。
- TopK 将这个边界值传递给底层 Scan 算子。
- Scan 根据最新边界,动态判断后续文件、Row Group 是否还有读取价值。
- 一旦能够证明某些数据不可能进入最终结果,就直接跳过。
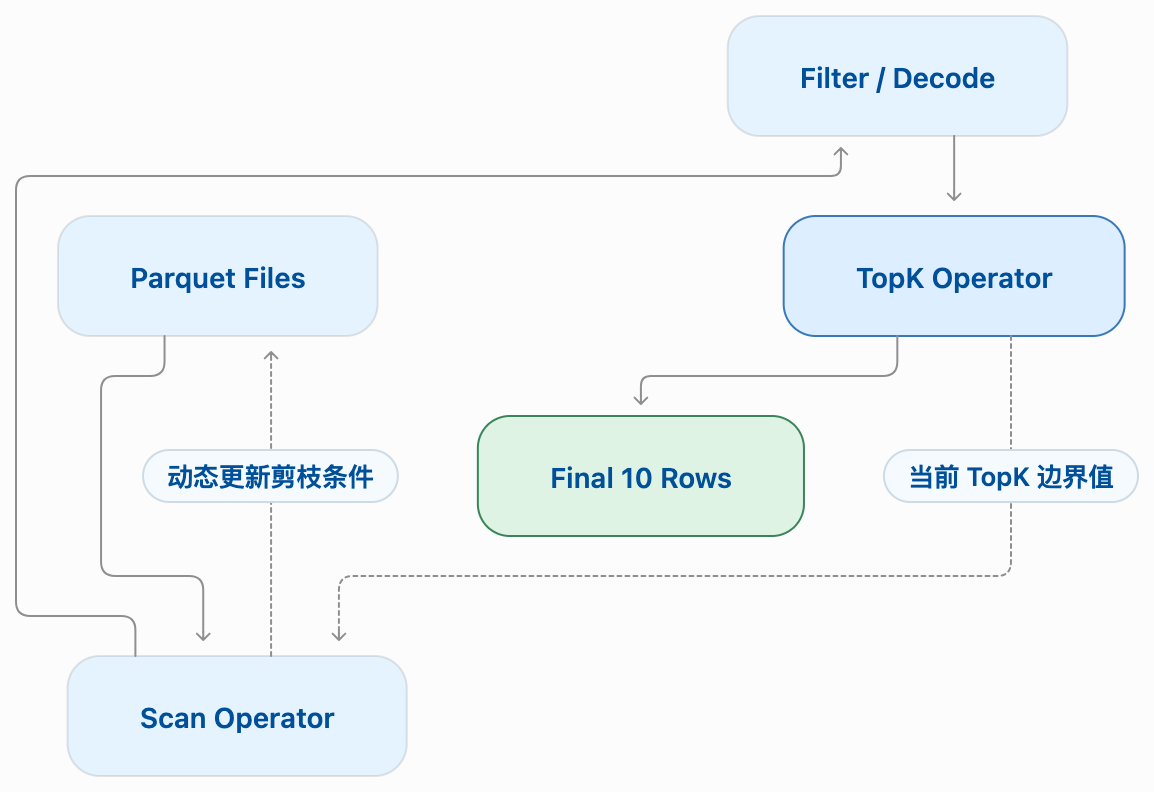
这意味着,查询优化不再只是执行之前的一次性决策,而是贯穿整个查询执行过程。
Andrew 在专访中也举了一个非常直观的例子:如果 1000 个文件按照时间组织,DataFusion 可能只需要打开最靠近当前时间的第一个文件,读取一部分数据,就能判断后续文件不可能产生更靠前的结果。
当然,这依赖于文件统计信息、数据排序和时间范围能够提供足够强的剪枝依据,并不是所有数据布局下都能只读取一个文件。
这项技术并非停留在理论上。DataFusion 社区此前发表的动态过滤实践文章中,Pydantic 的 Logfire 在特定查询模式下实现了超过 10 倍的性能提升。
Parquet 正在进化:为 AI 和新型查询负载做准备
Parquet 已经成为数据湖和分析型系统中非常重要的开放存储格式。
Andrew 认为,Parquet 很可能长期承担数据归档和跨系统交换的角色。
但它也面临新的挑战。
传统 Parquet 主要针对大规模扫描和聚合分析进行了优化,而 AI 和现代数据应用带来了更多不同的访问模式。
例如:
- 半结构化 JSON 数据。
- 地理空间数据。
- 向量数据。
- 大量随机单行读取。
这些场景对存储格式提出了新的要求。
Variant:让 Parquet 更高效地存储 JSON
过去,很多系统会直接把 JSON 当作字符串存储在 Parquet 中。
问题是:
- 每条记录都可能重复保存相同的字段名称。
- 查询时需要解析 JSON。
- 很难充分利用列式存储和统计信息进行剪枝。
Parquet 引入了 Variant 类型。
它不仅能够表达 JSON 这样的半结构化数据,还支持将经常查询的字段提取出来,形成独立的类型化列。
这一过程称为 Shredding。
例如:
{
  "timestamp": "2026-11-20T10:00:00Z",
  "service": "payment",
  "latency": 120,
  "custom_field": {
    "region": "ap-east-1"
  }
}
可以将 timestamp、service、latency 等常用字段作为独立的 Parquet 列,而将不固定的字段保留在 Variant 结构中。
这样既保留了 JSON 的灵活性,又能够利用 Parquet 的列式读取、投影裁剪和统计信息。
Geospatial:让地理空间数据也能被剪枝
Parquet 现在支持原生的 GEOMETRY 和 GEOGRAPHY 类型。
更有意思的是,它还能利用 Bounding Box(边界框)统计信息进行空间剪枝。
例如,查询德克萨斯州范围内的数据时,如果某个 Row Group 的地理边界框与查询区域完全不相交,就可以直接跳过它。
这意味着传统的 Min/Max 剪枝思想,也能扩展到空间数据领域。
Vector:让 Parquet 进入向量数据领域
向量检索已经成为 AI 基础设施的重要组成部分。
Parquet 正在增加 FINITE_VECTOR 类型,用于表示固定长度的数值向量。
但这里需要区分两个概念:
- 能够高效存储向量。
- 能够高效执行向量相似度搜索。
二者并不等价。向量存储格式并不会自动提供完整的 ANN 索引和检索能力。
单行随机访问:Parquet 的另一块短板
传统 Parquet 擅长批量读取,却不擅长随机获取少量记录。
因为读取一条记录可能需要:
- 读取多个列的 Page。
- 解压整个 Page。
- 解码目标记录之前的数据。
此外,Andrew 特别提到了 ALP(Adaptive Lossless floating-Point)编码。
它针对具有固定精度特征的浮点数据进行编码,在保持无损的同时,提高了解码速度,并支持更高效的随机访问。
Parquet 还在探索字符串和整数领域的新编码方案。
由此判断,Parquet 的未来不一定是放弃列式分析优势,而是在保留开放格式和兼容性的前提下,逐步覆盖更多访问模式。
从单机查询到分布式执行:真正困难的是什么?
DataFusion 本身主要提供单进程内的查询执行能力,但它已经具备了构建分布式查询引擎所需的很多基础设施。
Andrew 重点介绍了两个方向:
- Ballista:一个基于 DataFusion 的分布式查询引擎。
- DataFusion Distributed:一个可以嵌入现有 DataFusion 系统的分布式扩展库。
二者的定位并不完全相同。
Ballista 提供相对完整的分布式执行框架,包括 Scheduler、Executor 和 Shuffle 等机制。
DataFusion Distributed 则更强调 API 和基础能力的可组合性,让开发者可以将分布式查询执行整合进自己的系统。
分布式查询真正难在 Shuffle
假设我们要在多个节点上执行:
SELECT service, COUNT(*)
FROM logs
GROUP BY service;
每个节点可以先在本地完成部分聚合,但最终必须确保相同 service 的数据被发送到同一个节点。
这就需要 Shuffle。
对于 Join,问题更加复杂:两个数据集中的匹配记录必须被分配到同一个节点,否则就无法正确完成 Join。
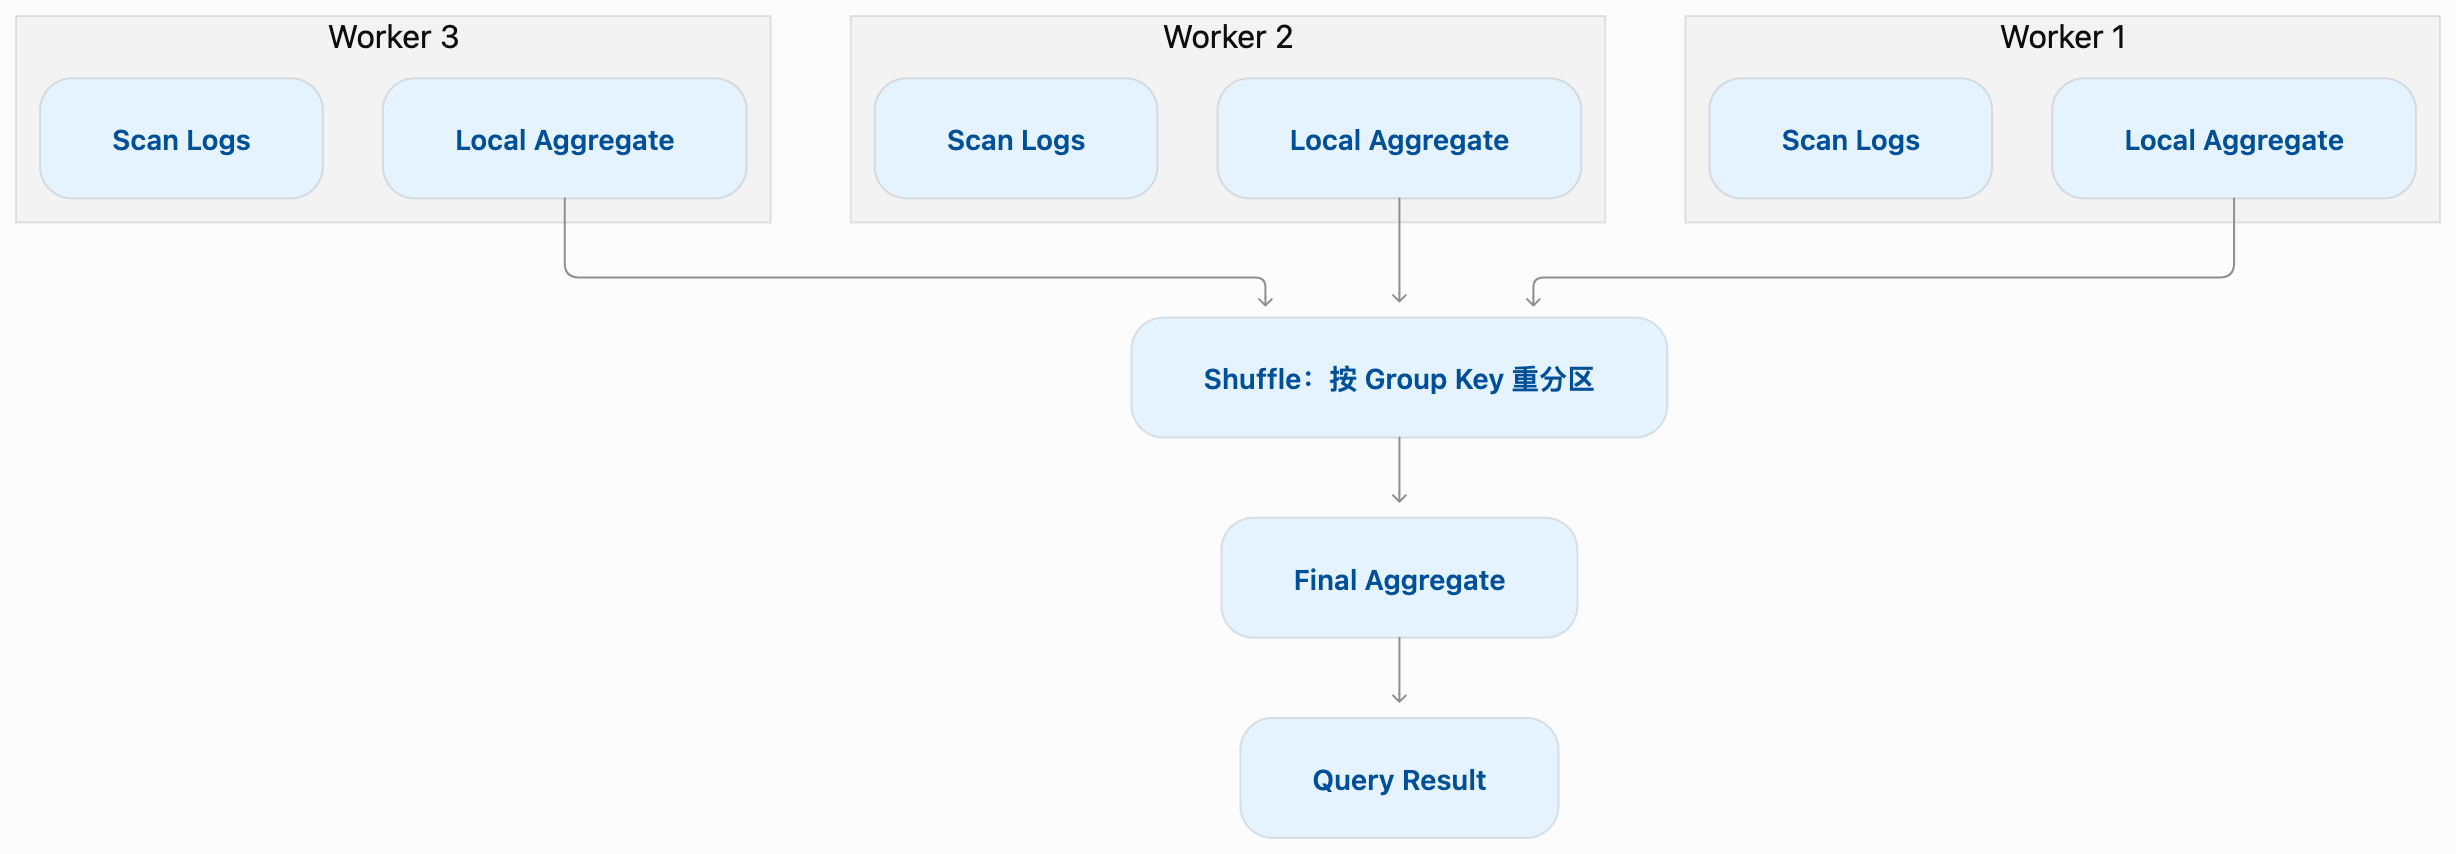
这里还涉及 Broadcast Join、Hash Partitioning、Range Partitioning、Bloom Filter 等优化技术。
Andrew 特别强调,分布式查询并不是简单地把扫描任务分配到不同机器上。真正复杂的是数据如何在节点之间正确、高效地流动。
此外,不同分布式执行架构还有不同取舍:
- 物化中间结果,可以提升故障恢复能力,但增加磁盘 I/O。
- 流式 Shuffle,可以降低延迟和中间数据物化成本,但需要更复杂的执行和故障处理机制。
分布式查询引擎的核心难题,是如何在网络、内存、计算和故障恢复之间做出正确的权衡。
AI Agent 正在让专用数据库重新成为可能
这是整篇文章中最值得上升到行业趋势层面讨论的一部分。
Andrew 提出了一个非常有意思的判断:
过去 30~40 年,软件行业逐渐从企业自研转向标准化、产品化软件。
原因很简单:购买和使用成熟软件,通常比招聘团队从头开发、长期维护更便宜。
但 Coding Agent 正在改变这个成本结构。
当一个 Agent 可以帮助开发者完成大量代码编写、测试和系统集成工作时,构建专用软件的成本就可能大幅下降。
于是,一个过去不经济的选择,可能重新变得有吸引力:
企业不一定要购买一个通用数据库,再努力适配自己的业务,而是可以围绕自己的数据模型和查询模式,组装一套专用的数据基础设施。
但这里需要强调,这并不意味着每次都从零写代码。
更可能的模式是:
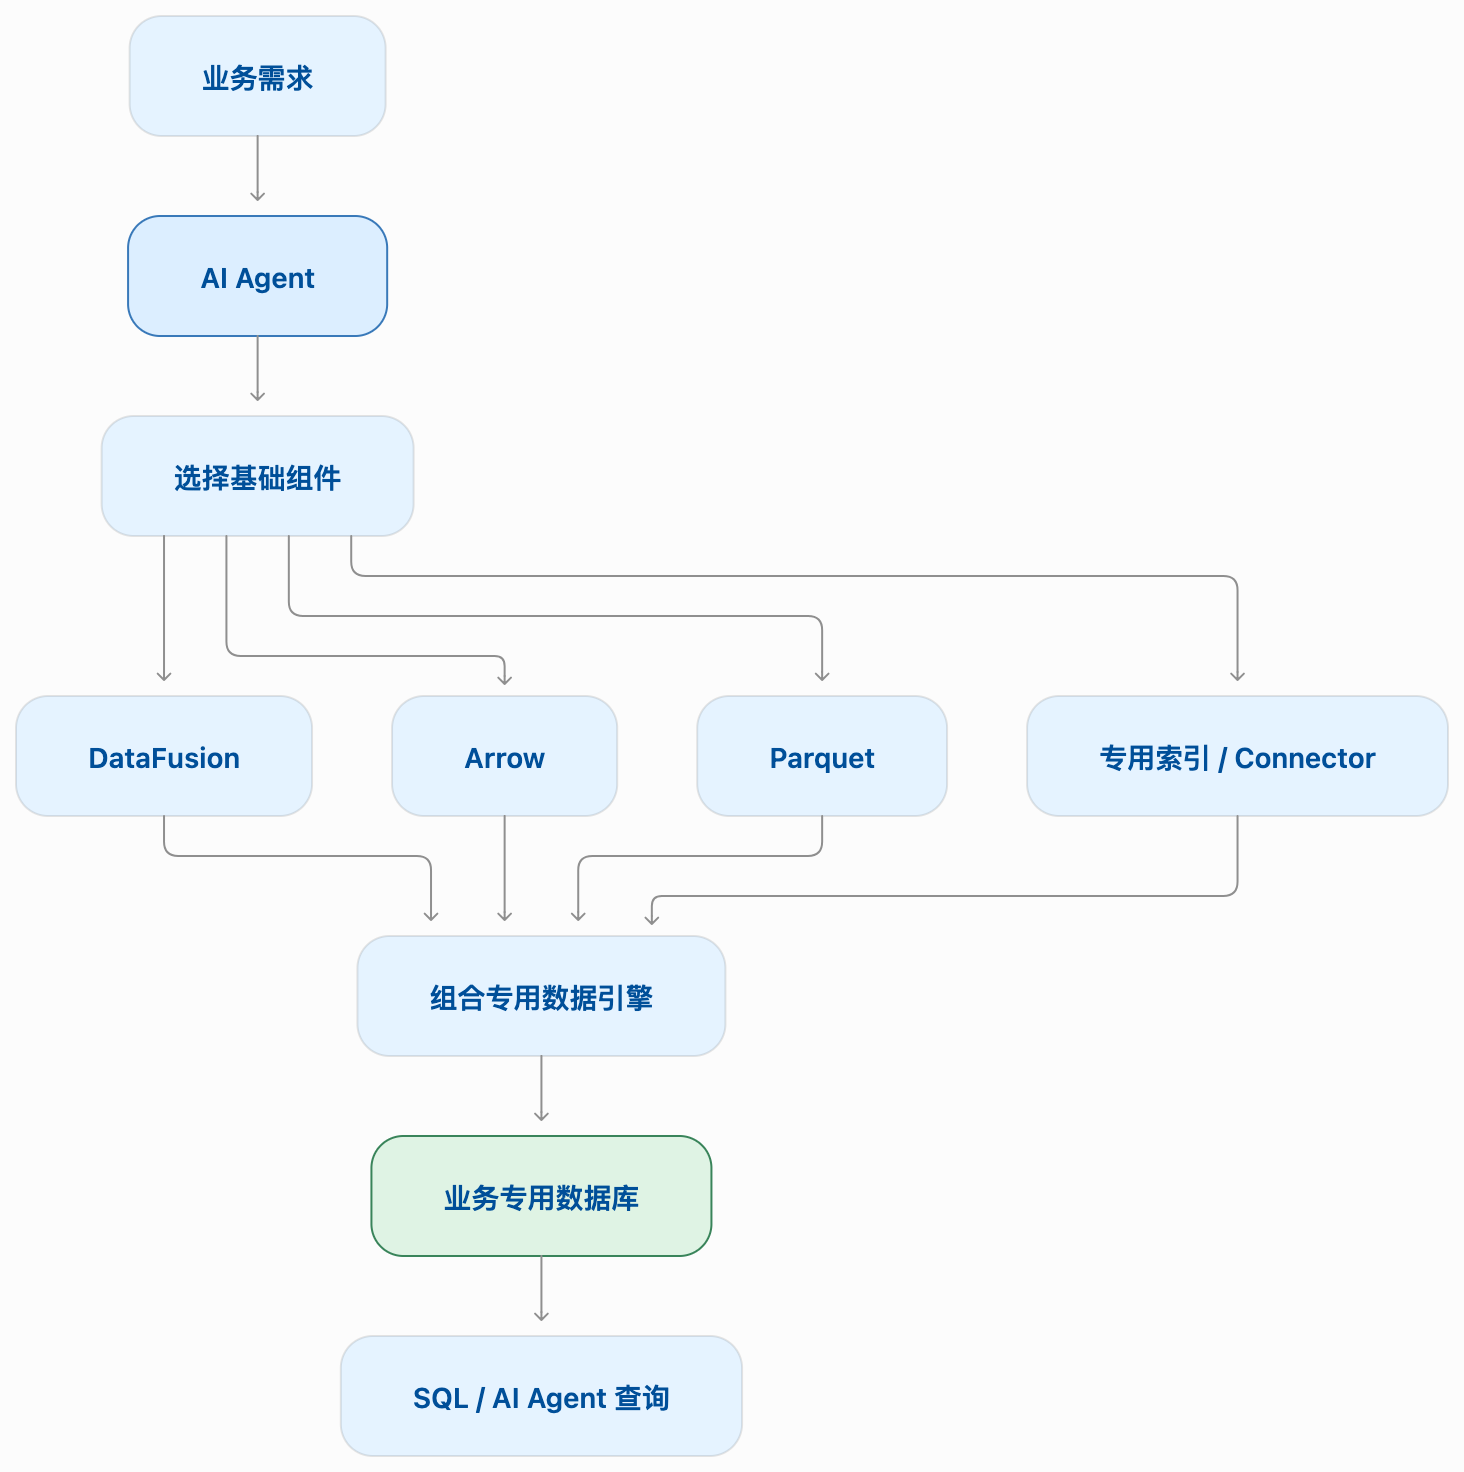
这也解释了为什么 DataFusion 的可扩展性如此重要。
开发者可以实现自己的 Catalog、数据源、索引、算子和优化规则,而不必修改一个庞大的封闭数据库系统。
Andrew 甚至提出了一个更大胆的预测:
未来,SQL 可能成为访问各种专用数据系统的统一语言。
因为人类过去需要学习不同领域的 DSL 和专用接口,但现在我们越来越多地通过 LLM 与系统交互,而 LLM 已经非常擅长理解和生成 SQL。
这意味着,SQL 可能不只是数据库查询语言,还会成为 AI Agent 访问企业数据基础设施的重要接口。
这一判断与 DataFusion 的发展方向高度契合。
AI 也在改变开源:当代码不再稀缺,什么才稀缺?
专访最后,Andrew 分享了一个非常现实的问题:AI 生成代码的能力,已经开始冲击开源项目的日常维护工作。
他说,过去半年,他认识的大多数软件工程师都已经不再主要编写代码,而是更多地审查 Coding Agent 生成的代码。
DataFusion 社区也遇到了类似情况。
一段时间内,项目积累了大约 400 个未关闭的 Pull Request。
一些贡献者利用 Agent,在几个小时内就生成并提交了 10~12 个 PR,甚至有人在短时间内向上百个开源仓库提交代码。
问题在于:
代码生成速度提升了,但代码审查速度并没有同步提升。
维护者需要判断:
- 代码是否真的解决了一个实际问题?
- 实现是否符合项目架构?
- 测试是否充分?
- 提交者是否理解自己提交的代码?
- 这些改动是否值得长期维护?
这导致一个非常尴尬的局面:AI 生成的代码越多,维护者反而越难找到真正有价值的贡献。
DataFusion 社区采取了几个措施:
- 将没有写权限的贡献者同时开放的非 Draft PR 限制为 3 个。
- 将 CI Runner 的成本转移到贡献者自己的 Fork。
- 更严格地筛选 PR,优先处理真正有上下文、有实际价值的贡献。
值得注意的是,这并不是反对 AI 生成代码。
Andrew 真正担心的是,AI 降低了提交代码的门槛,却没有降低维护和审查代码的成本。
目前 DataFusion 的贡献指南已经明确写入了相关限制和 AI 辅助贡献要求。
这里可以进一步提出一个值得思考的问题:
当代码越来越廉价,真正稀缺的可能不再是编写代码的能力,而是理解系统、判断架构、识别价值以及承担长期维护责任的能力。
这不仅是开源社区的问题,也是整个软件工程行业需要面对的问题。
小结:未来的数据库,可能不再是一个产品,而是一套组合
回到 Andrew Lamb 的这次专访。
从 DataFusion 的查询优化器,到 Parquet 的新型编码,再到分布式执行和 AI Agent,我们看到的并不是几个孤立的技术进展。
它们共同指向一个更大的趋势:
数据库正在从封闭、垂直整合的产品,逐渐走向开放、模块化、可组合的基础设施。
过去,构建一个专用数据库意味着投入大量人力,重新实现 SQL、存储、执行和优化等基础能力。
现在,DataFusion、Arrow、Parquet 等开源项目已经提供了越来越成熟的基础组件,而 AI Agent 又进一步降低了组装和扩展这些组件的成本。
未来,企业可能不再需要为所有场景选择一个通用数据库,而是可以针对自己的业务特点,构建最适合自己的数据系统。
Andrew 在专访最后给出了一个很有意思的建议:
如果你正在做一个数据项目,不妨试着给它加上一个 SQL 接口,再让 AI Agent 通过 SQL 查询它。
也许你会发现,原本需要大量定制开发才能完成的事情,现在已经变得容易得多。
AI 不只是让我们写代码更快,它还可能让我们重新思考:究竟应该如何构建软件。
资料链接:Andrew Lamb 专访视频(YouTube)- https://www.youtube.com/watch?v=LBSfavhN4pw
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。