本文永久链接 – https://tonybai.com/2026/11/08/uber-failover-architecture-ufa-nsdi26
大家好,我是Tony Bai。
【导读】
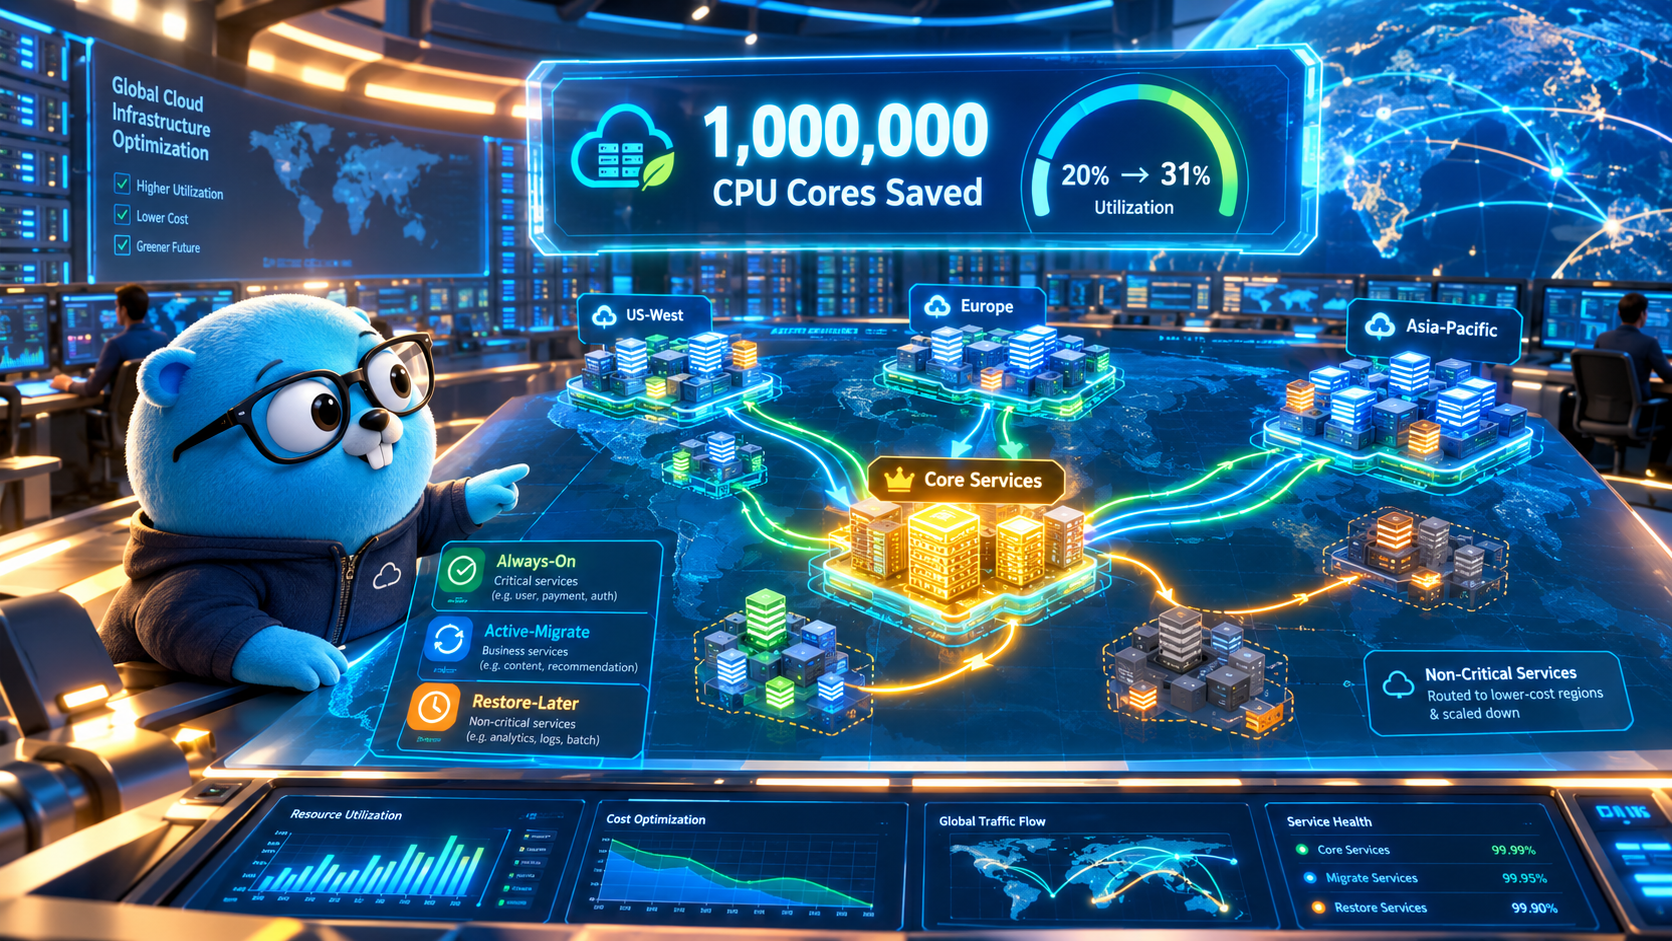
Uber每年因为区域级故障“真正扛不住”的时间,只有不到20小时。可是为了应对这不到20小时的极端情况,Uber过去十年一直老老实实地把全球服务器多备份了一倍——每个服务都按“随时可能全量接管另一个区域流量”的标准来配置,结果是整个机队的CPU利用率常年徘徊在20%左右。这篇发表于NSDI'26的论文,讲的就是Uber工程团队如何用两年时间,把这套“一刀切”的容灾架构,改造成一套“按业务重要性分级”的智能超卖系统,最终把预留容量从2×打到了1.3×,利用率从20%拉到30%,同时干掉了100多万个CPU核心——相当于直接砍掉了四分之一个机队。
【文章要点】
- 一个反直觉的数据发现:过去四年的故障数据显示,真正的“全量峰值故障”每年平均不到20小时,占比仅0.23%——这成了整个改造项目的立项依据;
- 核心思路:不再要求所有服务“平等容灾”,而是按T0~T5共7个业务重要性等级,把服务分成 Always-On / Active-Migrate / Restore-Later / Terminate 四种故障响应类型,越不重要的服务,容灾要求越低;
- 最大的坑:省钱的前提是“故障隔离”——必须先把关键服务对非关键服务的“失败即挂”(fail-close)依赖全部消灭掉,不然低优先级服务一被牺牲,高优先级服务跟着遭殃;
- 三层安全网:运行时依赖分析(每天分析数万亿次RPC)+ 静态代码分析(扫描Go/Java调用链)+ Canary环境的自动化回归门禁,一共揪出4155个危险的跨层级依赖;
- 真实成绩单:11个月内减少102.5万个CPU核心,全局CPU利用率从20%提升到31%,同时线上核心业务可用率始终维持在99.97%以上,即便在一次真实发生的17小时区域故障中也没有掉线。
一个价值百万CPU核心的问题
先抛一个数字:Uber全球机队的基线规模大约是400万核CPU。
再抛一个数字:过去这400万核里,常年只有大约20%在真正干活。
剩下的80%去哪了?答案是:陪跑。
Uber的业务逻辑很简单粗暴——为了保证任何一个区域挂掉时,另一个区域能瞬间接管全部流量,公司要求每一个微服务都必须按“能扛住2倍流量”的标准配置资源。这套模型直观、易于理解,但代价极其惊人:相当于永远闲置了一半的服务器,只为等一场可能一年都不会发生的意外。
这篇来自Uber的NSDI'26论文《Uber’s Failover Architecture: Reconciling Reliability and Efficiency in Hyperscale Microservice Infrastructure》,讲的就是他们怎么把这笔“沉睡的巨款”给盘活的。
老架构:双活容灾,但代价是“陪跑”
Uber的基础设施横跨两个地理区域(Region),每个区域内又有多个可用区(Zone)。日常情况下,每座城市的流量只会被路由到其中一个区域,另一个区域的资源理论上是空闲的,只是“随时待命”。
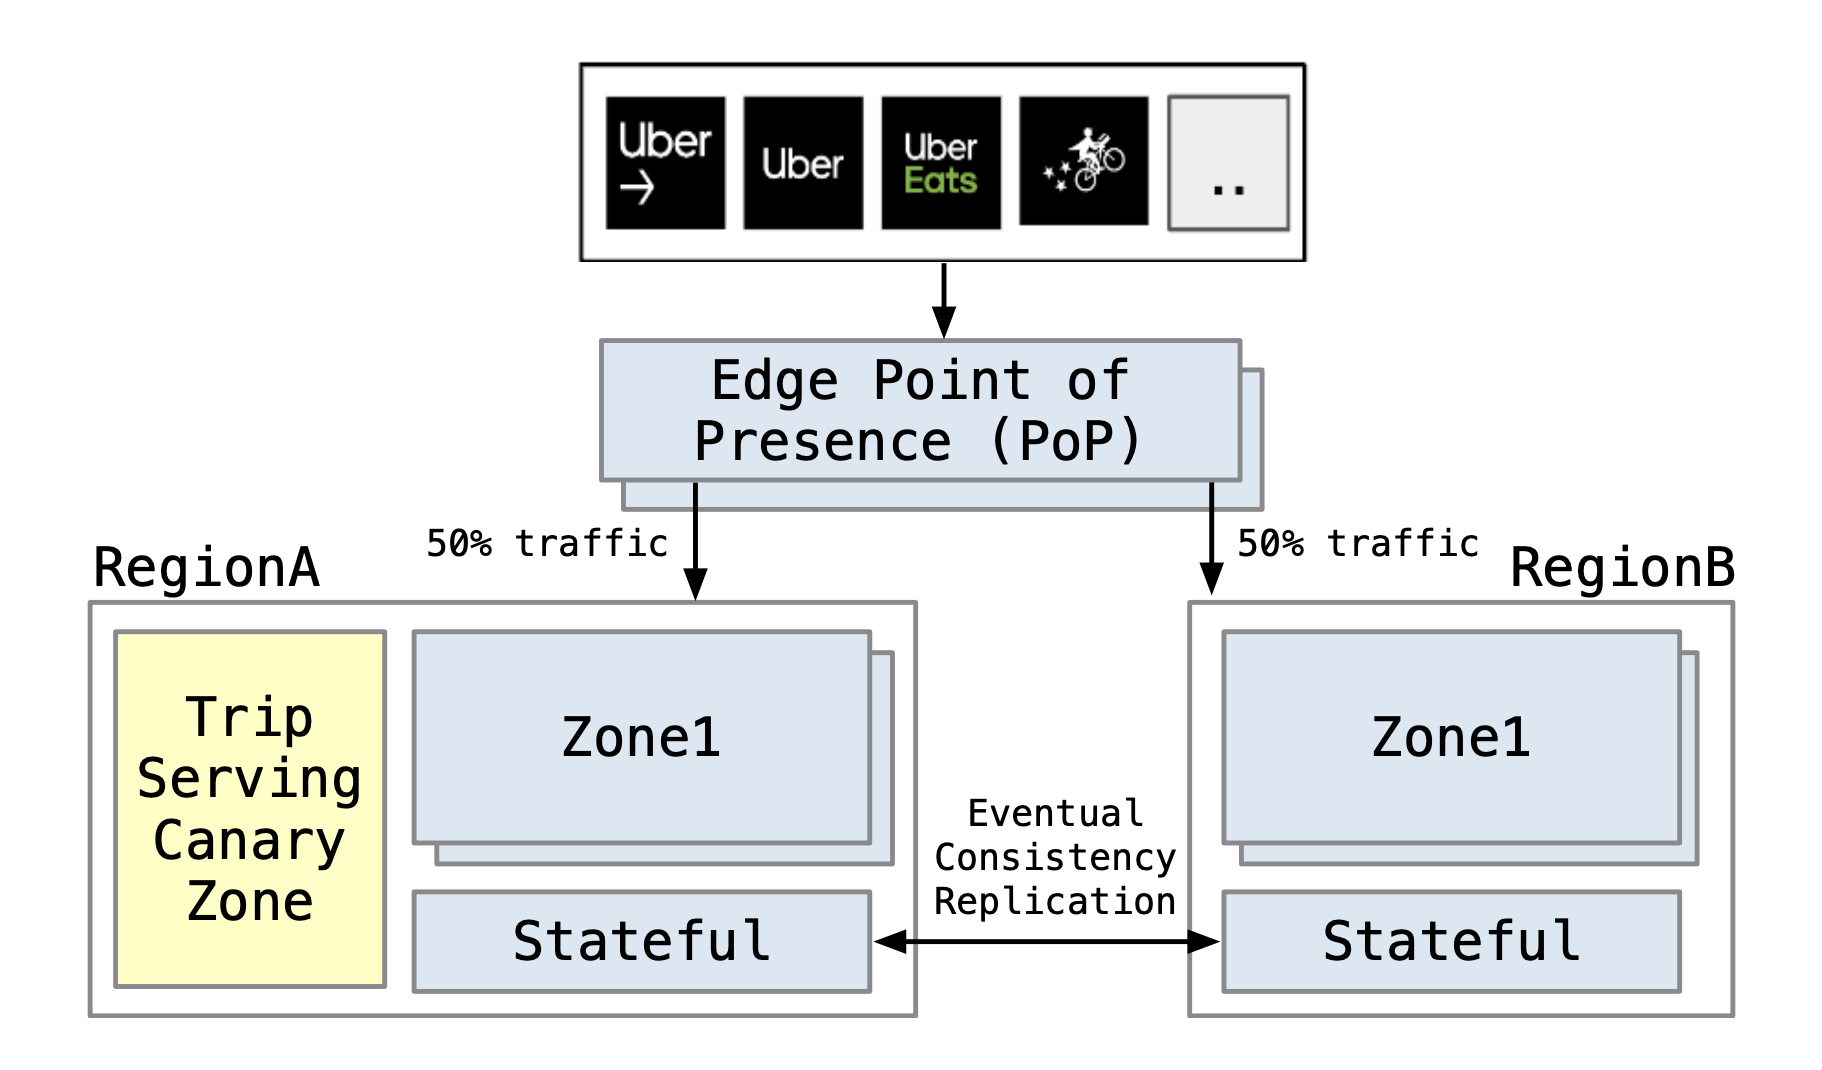
故障判定标准也很值得玩味:Uber把故障分为“peak/non-peak”(是否超过周峰值85%的用户量)和“full/partial”(是否超过50%的城市迁移),只有二者同时满足才叫full-peak故障——也就是那种真正需要“全量2倍容量”接管的极端场景。
而团队分析了过去四年的故障数据后发现:
Full-peak故障平均每年发生不到20小时,占全年时间的0.23%。
也就是说,Uber为了应对这0.23%的极端情况,让整个机队常年浪费了80%的算力。这个发现,成了整场架构改造的“立项证据”。
问题不止一个:省钱之前得先“排雷”
如果只是利用率低,那事情还简单——直接把闲置资源拿出来做超卖(oversubscription)就行了,低优先级任务白天先用着,故障时再收回来。这套思路在业界并不新鲜。
但Uber面临第二个更棘手的问题:“拉一个挂一片”的脆弱依赖。
Uber内部有超过6000个微服务,部署在16000个环境里,服务之间的调用关系早已是一张密不透风的网。论文里给出了一组吓人的数据:某一周内,全平台RPC调用总量高达62万亿次,其中约32万亿次(约50%)是从高优先级层级流向低优先级层级的“跨层调用”。
| 层级 | 说明 | 基线CPU核数 |
|---|---|---|
| T0 | 基础设施与关键应用 | 20.1万 |
| T1 | 核心行程链路 | 303万 |
| T2 | 业务关键应用 | 40万 |
| T3 | 应用依赖的内部工具 | 25.4万 |
| T4 | 员工使用的内部工具 | 2.31万 |
| T5 | 测试环境及其余部分 | 2.21万 |
| NP | 非生产环境 | 24.9万 |
这意味着什么?很多核心业务服务(T0/T1)在代码里悄悄对一些“不那么重要”的服务(T3/T4/T5)产生了“fail-close”依赖——通俗讲,就是下游一个无关紧要的服务挂了,上游的核心服务因为没处理好异常,跟着一起挂。
这种依赖有些是设计失误,有些则是团队图省事,把下游报错原样往上抛的“惯例”造成的。
这就带来了一个两难:你想把不重要的服务先牺牲掉腾资源,可如果核心服务偷偷依赖了它,牺牲了它,等于亲手捅了核心业务一刀。
Uber团队的洞察是:这两个问题其实是一体两面。只要把跨层级的“fail-close”依赖系统性地清理掉,让关键服务具备“fail-open”(下游挂了我也能正常降级运行)的能力,那么低优先级服务的资源,既能在日常拿来做超卖提升利用率,又能在故障时被安全地牺牲掉——一次改造,两个问题一起解决。
这个洞察,就是Uber’s Failover Architecture(简称UFA)的核心逻辑起点。
UFA怎么设计:给每个服务发一张“生死牌”
UFA不再对所有服务一视同仁,而是根据业务重要性,把服务划分成四种“故障响应类型”:
| 故障类型 | 故障发生时的处理方式 | 网络影响 | RTO(恢复时间目标) |
|---|---|---|---|
| Always-On | 原地扩容,不被抢占 | 不中断 | 秒级 |
| Active-Migrate | 提前在别处拉起,再切走 | 平滑重配置 | 秒级 |
| Restore-Later | 立即停机,稍后在批处理集群/云上恢复 | 短暂中断 | 1小时内 |
| Terminate | 立即停机,不恢复 | 持续中断,直至故障恢复 | 无 |
对应关系大致是:
- T0/T1(核心行程链路)享受Always-On待遇;
- T2(业务关键应用)走Active-Migrate;
- T3~T5走Restore-Later;
- 非生产环境(NP)直接Terminate。
日常没有故障的时候,这些低优先级服务(Restore-Later / Terminate类)并不是真的什么都不干,而是被安排“寄居”在Always-On服务预留出来、但平时用不满的容灾缓冲资源里——相当于花两份钱买的房子,闲置的那一半日常拿来出租,真出事了立刻把租户请出去。
这背后是Kubernetes层面的资源池划分:每台物理机的CPU被切成stateless.cpu(留给Always-On)和overcommit.cpu(留给可被抢占的工作负载)两个资源池。论文里给了一个具体例子:一台100核物理机,会对外宣称有150个可调度核心——100个进“正常池”,50个进“超卖池”。
团队还专门搭了个仿真器来算安全的超卖系数,最终定在了1.5倍——也就是说,同样一批“正常池”资源,理论上还能再塞进50%的低优先级负载。同时论文给出了一个决定超卖上限的简单公式:
$$O_{max} = \frac{M_h}{M_s} \times \frac{\alpha_m}{\alpha_c}$$其中$M_h$是每核平均内存、$M_s$是每核服务所需内存、$\alpha_m$、$\alpha_c$分别是内存和CPU的安全分配系数。代入Uber的实际数据($M_h=8GB$,$M_s=4GB$,$\alpha_m=0.75$,$\alpha_c=0.9$),算出的理论上限是1.66倍——之所以实际只取1.5倍、留出余量,是为了给系统组件和突发流量留缓冲。
真出故障了,会发生什么?
当一次“peak模式”的区域级故障真的发生时,整个过程由一个叫OMG(Outage Mitigator)的编排系统自动指挥。
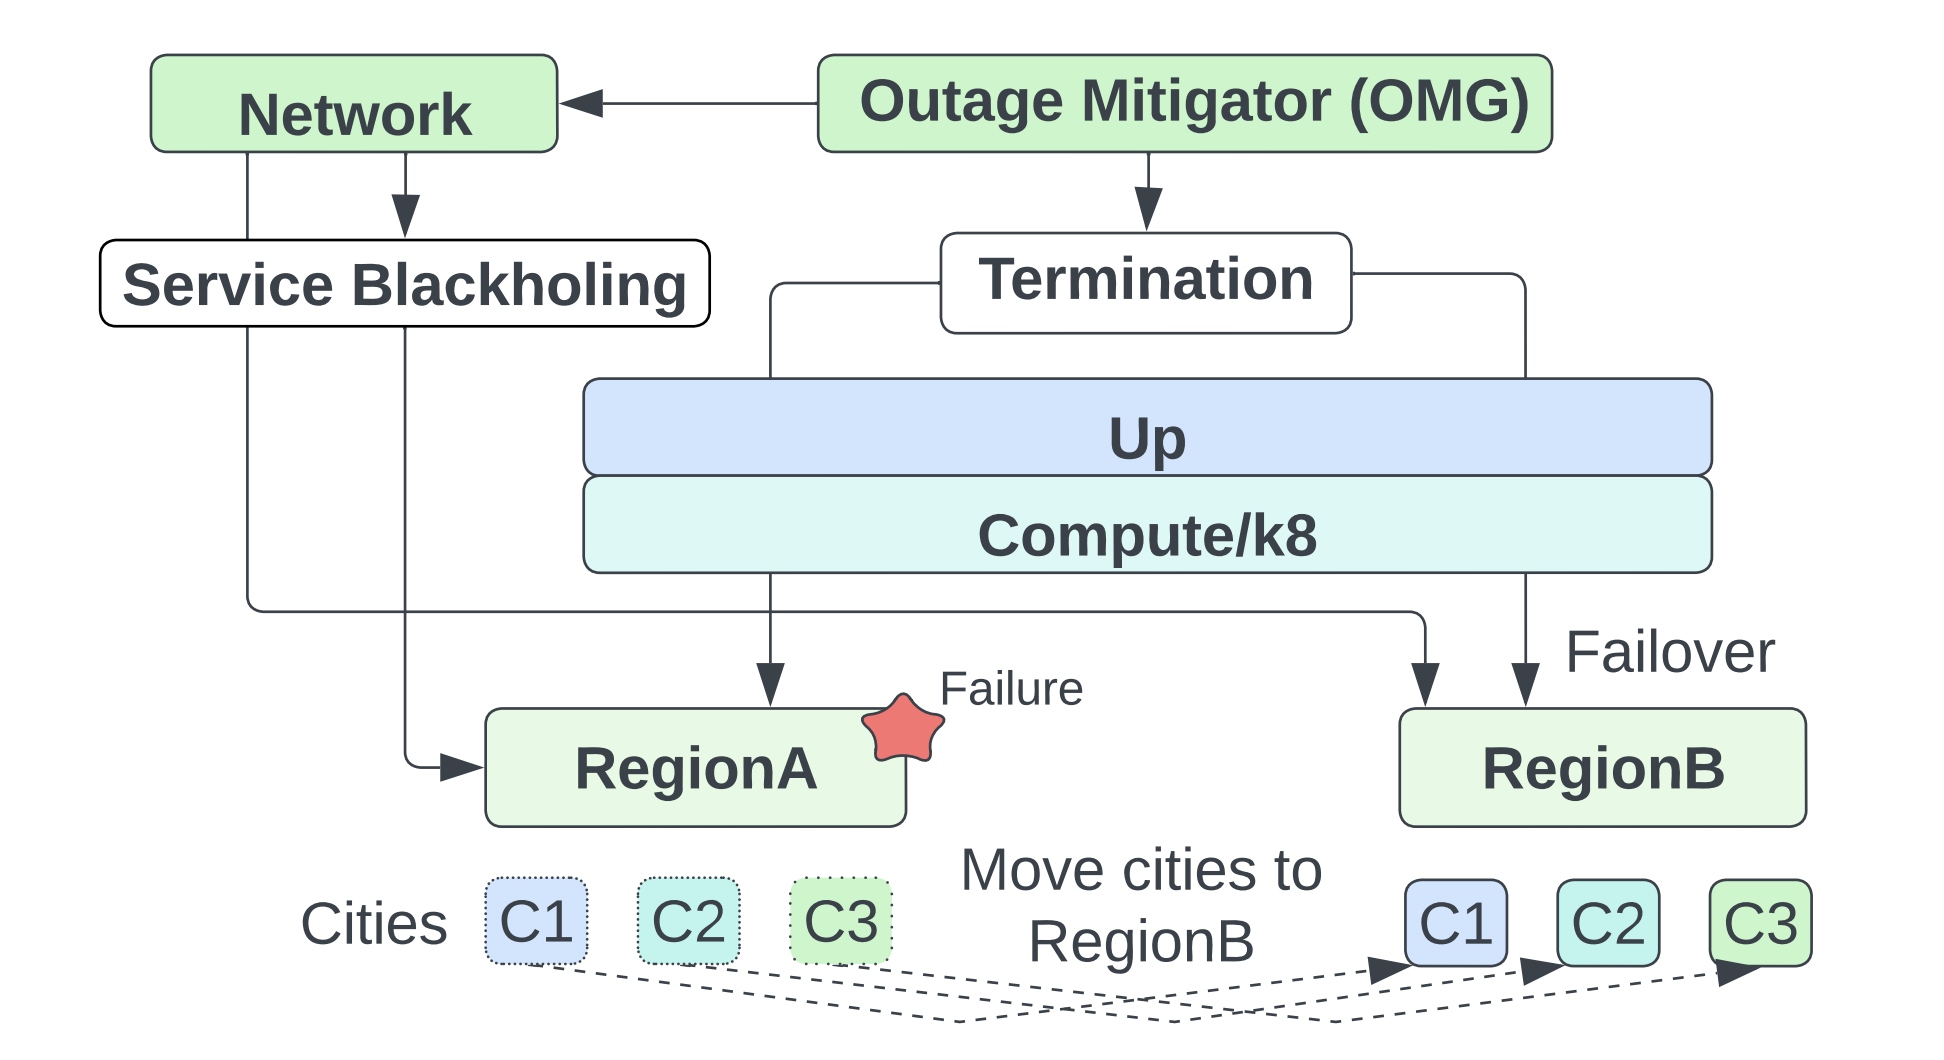
大致分四步走:
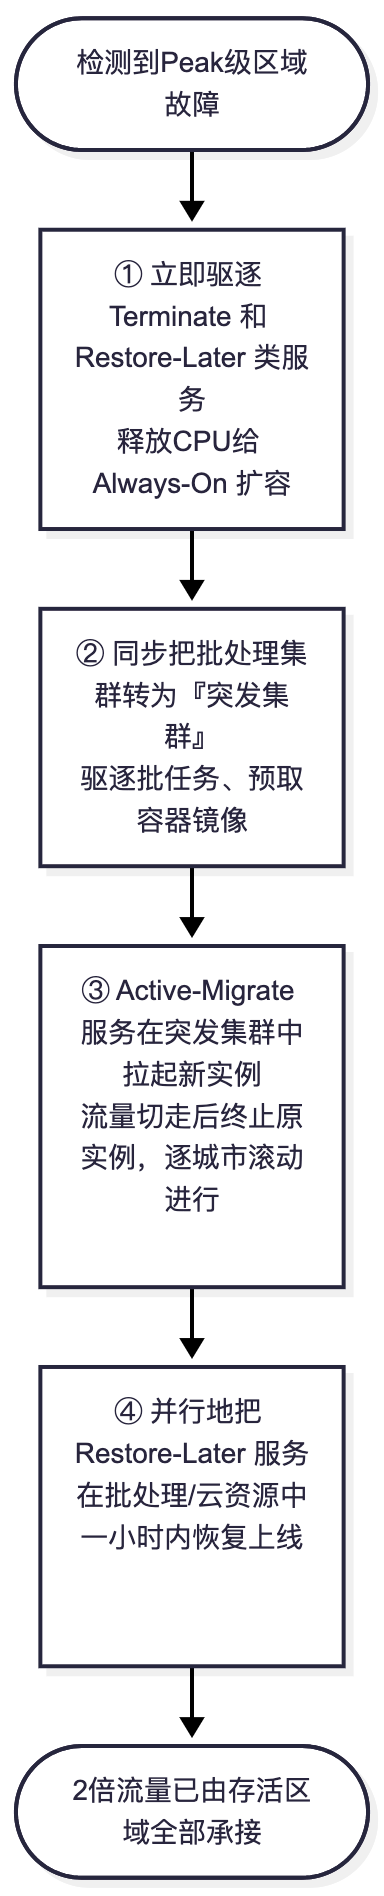
这里有两个特别值得一提的工程细节:
一是网络层面的“精准断网”。
UFA要求Restore-Later和Terminate类服务在故障期间被彻底断开连接——一方面让存活的核心服务能“优雅地”处理依赖缺失,另一方面避免这些服务重新上线时出现“惊群效应”。Uber的做法是双管齐下:一边靠L7服务网格的限流策略按调用方/被调方精细控制,30秒内全局收敛;一边靠安全侧的“全局策略”直接拉黑网络连通性,连绕过负载均衡的P2P流量也管得住。
二是镜像预热带来的实打实提速。
大规模迁移时如果临时去中心镜像仓库拉镜像,很容易把源站打垮。Uber用了一套P2P镜像分发系统(Kraken),提前把几个TB的镜像数据预热进“突发区域”,服务启动时间因此缩短了30%。
一次故障恢复能有多快?论文给出的真实案例是:异步的资源置备组件可以在20分钟内,跨2000台主机拉起24万核CPU。
最难啃的骨头:怎么保证“拆了不塌”
前面说了,这套架构能成立的前提,是核心服务对非核心服务不能有“fail-close”依赖。这事说起来容易,真做起来是个跨越6000+微服务、成百上千个团队的巨大工程活儿。Uber搭了三层安全网:
第一层:运行时依赖分析。 每天分析线上几万亿次RPC调用,把“下游一失败、上游也跟着失败”的调用对识别出来,标记为fail-close。
第二层:静态代码分析。 在代码合入前,静态扫描Go和Java代码里的调用链,分析错误返回值和异常传播路径,提前把问题挡在部署之前。
第三层:Canary环境的自动回归门禁。 所有Always-On和Active-Migrate类服务在部署到Canary环境时,都要经历一次“5分钟断网测试”——人为切断所有Restore-Later和Terminate类服务的流量,看核心业务指标会不会异常。一旦发现新的fail-close依赖,直接自动回滚。
三层加起来,一共揪出了4155个fail-close违规依赖:
| 违规类型 | 运行时分析发现 | 静态分析发现 |
|---|---|---|
| Always-On → Restore-Later | 1120 | 337 |
| Active-Migrate → Restore-Later | 1757 | 777 |
| * → Terminate | 164 | - |
值得一提的是,静态分析上线后,Canary门禁在45天观察期内只抓到了3个新增回归——侧面说明静态分析确实把大量问题拦在了更早的阶段。
除此之外,Uber还上了一套基于生成式AI的移动端端到端测试系统,结合故障注入,用自然语言描述测试意图,让AI自主操作App来验证核心业务流程在依赖缺失时是否还能正常工作。这套系统覆盖了47条核心业务流程,累计发现23个潜在风险点。
真实故障复盘:一次17小时的“实战演习”
论文里选取了2026年1月26日凌晨发生的一次真实故障做复盘,持续了大约17个小时。几个关键数据:
- 故障发生后,8分钟内(8:15→8:22)就把突发容量的CPU全部就绪;
- 全程核心行程业务的平均可用率始终维持在99.97%,故障窗口内没有出现任何下降;
- 承接故障流量的Region峰值CPU利用率冲到了50.2%,但始终在安全阈值以内;
- 850K个Pod规模下,故障期间的容器驱逐速率短暂冲到基线的2倍(每小时312次 vs 160次),但只集中在故障发生后的第一个小时,随后迅速回落到正常水平。
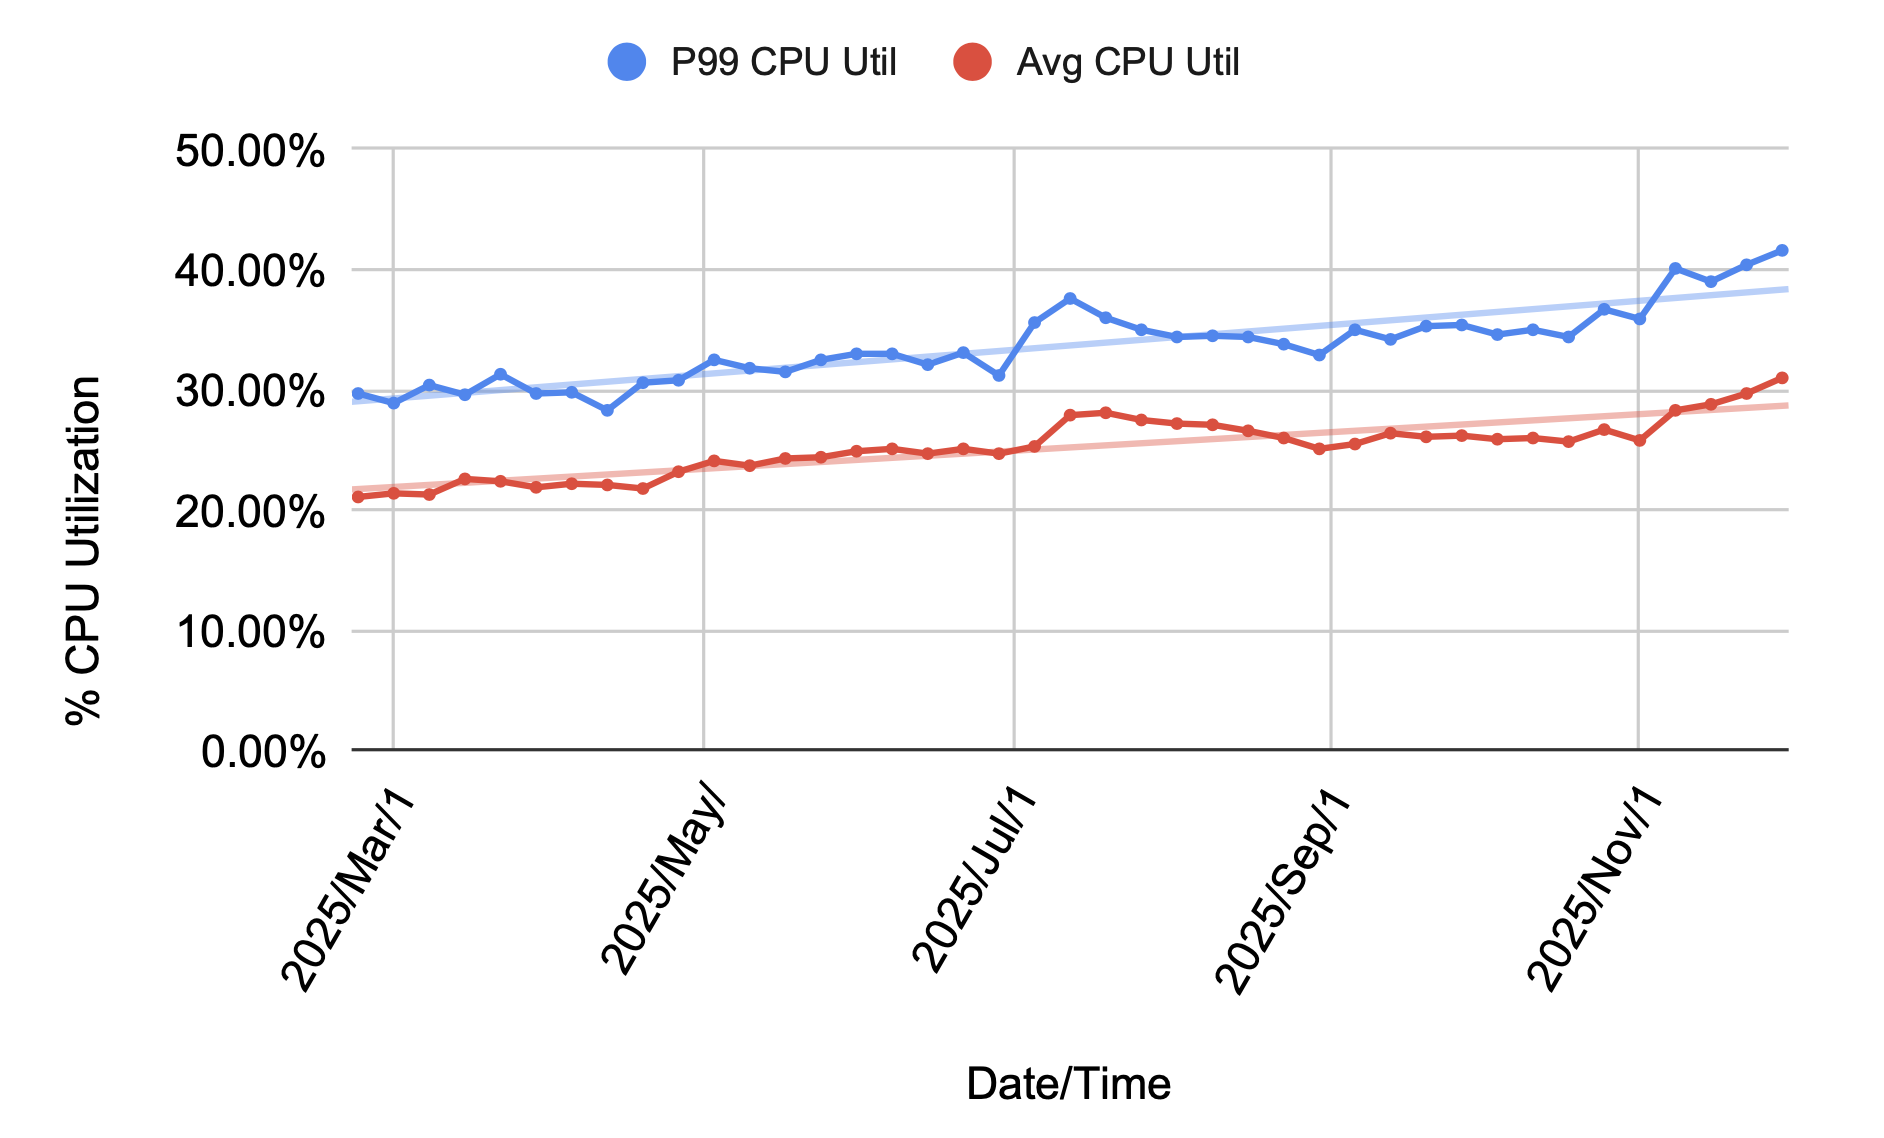
而从整个11个月的滚动部署周期来看,全局CPU利用率从平均20%(P99 30%)提升到了31%(P99 42%),累计减少102.5万个CPU核心——其中约54%来自“先建后拆”(make-before-break)迁移策略节省的资源,46%来自“先拆后建”(break-before-make)策略。
Uber自己踩过的坑
论文最后一部分坦诚地聊了不少经验教训,挑几条有意思的:
“全球规模”永远比想象中复杂。
即便测试再充分,Uber还是在真实的分区域灰度过程中发现了一些完全没预料到的地域性问题——比如某些机场周边的司机响应时间会显著变长,这种问题在预发环境里根本模拟不出来。
主动故障切换反而是“防灰色故障”的利器。
Uber的习惯是一旦检测到“灰色故障”(服务没完全挂,但表现异常)的苗头,就主动发起区域切换,而不是死等到彻底宕机。团队发现,即便目标区域本身也有点小毛病,UFA的影响也只会体现在“非核心服务排队等资源”上,不会传导到核心业务——甚至有些情况下,把故障服务重启到突发集群里,问题反而自愈了,因为新环境本身就规避了旧环境里的部分基础设施问题。
如果重来一次,两件事会换个做法: 一是不再“一刀切”驱逐批处理集群的任务,而是提前和批处理业务方协调,故障发生的那几个小时里主动别往批处理集群上调度新的非关键任务;二是应该更早地投入精力去梳理服务间依赖图——这件事理想情况下应该在UFA之前就做,但考虑到这是个跨越多年的浩大工程,最终被安排在了后面。
小结
这篇论文最打动人的地方,其实不是任何一个具体的技术点——依赖分析、容器超卖、故障切换编排,这些在系统领域都不算全新的概念,论文自己在Related Work里也坦诚承认了这一点。
真正的难点,在于怎么在一个由数百个独立团队、跨越6000+微服务的组织里,把“给服务分级、允许牺牲非关键服务”这件事,从一个技术方案变成一场覆盖全公司的社会技术协作。这也是为什么Uber专门成立了一个约50人的中心化平台团队,花了整整两年时间,一个层级一个层级地推进,每一个阶段都要经过利益相关方签字确认。
对于任何管理着大规模微服务集群、又被“容灾成本”和“资源利用率”两头拉扯的团队来说,Uber这套“用数据说话、分级容灾、超卖与安全并重”的思路,都值得认真读一遍原文。
论文信息
- 标题:Uber’s Failover Architecture: Reconciling Reliability and Efficiency in Hyperscale Microservice Infrastructure
- 会议:NSDI 2026(USENIX Symposium on Networked Systems Design and Implementation)
- 链接:https://www.usenix.org/conference/nsdi26/presentation/bansal
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
「Go & AI 精进营」已全面升级为「Go, Rust & AI 精进营」知识星球,快来加入星球,开启你的技术跃迁之旅吧!
我们致力于打造一个高品质的 现代系统级开发(Go / Rust) 与 前沿 Agentic AI 工程实践 平台。在这里,你将获得:
- 体系化 Go 核心进阶内容: 深入「Go原理课」、「Go进阶课」、「Go避坑课」等独家深度专栏,夯实你的 Go 语言内功。
- 硬核 Rust 专项实战赋能: 同步解锁全年 54 讲独家专栏「事不过三:Rust 系统级入门实战课」,通过 4 个里程碑项目(命令行工具、KV引擎、多线程Web服务、异步Redis),带你彻底攻克所有权与并发高山,拿下 Rust 核心壁垒。
- 前沿 Agentic AI 落地实践: 紧跟时代步伐,系统学习「Agent开发实战课」、「Agentic软件工程课」、「Claude Code开发工作流实战」、「Harness工程设计」等,掌握 AI 时代的系统架构新技能。
- 星主 Tony Bai 亲自答疑: 遇到疑难杂症?星主第一时间为你深度解析,扫清 Go、Rust 与 AI 实践中的学习与工程障碍。
- 高活跃 Gopher & Rustacean 交流圈: 与众多优秀的技术极客探讨系统设计、分享前沿心得、碰撞思想火花。
- 独家资源与专栏首发: 博客深度长文、专栏教程更新、精选技术资源,星球会员第一时间触达,加入星球即可免费阅读全套进阶专栏!
衷心希望「Go, Rust & AI 精进营」能成为你拓宽技术边界、持续精进与交流的温暖港湾。让我们在此相聚,享受代码与工程之美以及技术精进的快乐!欢迎你的加入!

商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。