本文永久链接 – https://tonybai.com/2026/09/30/tailscale-faster-go-performance-optimization
大家好,我是Tony Bai。
【导读】
Tailscale 是一家由 Go 核心团队多位前成员创立、几乎全栈用 Go 语言构建的网络公司,最近又在官方博客上“秀肌肉”了。这一次,他们没有谈 NAT 穿透,也没有谈零信任架构,而是把镜头对准了一个更朴素也更硬核的问题:数据包,怎么才能跑得更快?
9 月 22 日,Tailscale 官方发布博客《We’re making Tailscale faster》,详细拆解了即将在 v1.104 及后续版本中上线的一整套性能优化:更省内存的小包处理、面向子网路由器 / 应用连接器 / 出口节点的多队列架构、利用 writev 减少内存拷贝,以及能让弱网环境下启动速度提升一到两个数量级的“网络地图缓存”。这些优化背后,几乎每一处都是 Go 语言在系统编程、并发调度和内存管理上的“活教材”。
本文将结合 Tailscale 官方博客原文及其关联的历史优化文章,系统梳理这次提速方案的技术细节、设计取舍,以及它对 Go 语言网络编程实践的启发。
【文章要点】
- Tailscale 是 Go 团队出走后创立的公司,客户端与控制面几乎全部用 Go 编写,是观察 Go 在网络基础设施领域落地效果的绝佳样本;
- 本次提速主要包含四项技术:零拷贝式小包内存管理、多队列并行流水线、writev 向量化系统调用、netmap 冷启动缓存;
- 小包内存优化带来约 5% 的速度提升,代价极低,却直接惠及所有 Linux / Android 设备;
- 多队列架构专门解决了子网路由器、应用连接器、出口节点这类“多连接共享单一有序流水线”场景下的吞吐瓶颈;
- 网络地图缓存在弱网条件下,能让“热启动”到数据面可用的速度比“冷启动”快 10 到 100 倍;
- Tailscale 还在筹划一套原生的网络性能诊断与监控工具,因为现有工具普遍不懂 DERP、直连、Peer Relay 这些 Tailscale 特有概念。

Tailscale 和 Go:一段“分手后创业成功”的故事
如果你关注 Go 语言生态,大概率听说过 Tailscale 的名字。它的几位核心创始人和早期工程师,曾是 Go 团队在 Google 内部的成员,离开后创立了 Tailscale,用 Go 语言重新实现了一套基于 WireGuard 的零配置组网方案。可以说,Tailscale 从诞生第一天起,就是 Go 语言在真实世界高性能网络基础设施中的一块“活广告牌”。
Tailscale 的核心竞争力之一是 NAT 穿透——即便在各种“不友好”的网络环境下,也能帮设备找到彼此的直连路径。但光“连得上”还不够,“连得快”同样重要。这也是本文要聊的主题:数据平面(data plane)的性能优化。
按照官方博客的说法,过去几年 Tailscale 在这条路上已经达成不少里程碑:
- 提升 Linux 设备的 TCP 吞吐量;
- 对 wireguard-go 做底层改造,在裸机上突破 10Gb/s;
- 利用分段卸载(segmentation offload)技术,把基于 UDP 的应用(比如 QUIC)吞吐量提升 4 倍以上;
- 推出 Tailscale Peer Relays,在复杂网络条件(尤其是跨国网络)下改善连接质量。
这些积累,让 Tailscale 逐渐具备了支撑 CI/CD、Agentic 工作流、远程开发环境、机器人边缘设备、大规模遥测数据传输等“性能敏感型”场景的能力。而这一次的博客,就是团队交出的最新答卷。
优化一:小数据包,别再“住大平层”了
网络世界里有个残酷的现实:大多数数据包都很小,往往只有 1 KiB 左右。但要用上 Linux 最高效的吞吐工具——比如通用接收卸载(Generic Receive Offload,GRO)——Tailscale 就必须一次性准备好接收 64 KiB 的数据。
官方博客用了一个很形象的比喻:这就像集装箱运输,港口、货轮、卡车都是按照统一的集装箱规格设计的,不管里面实际装了多少货物。
问题在于,Tailscale 依赖的 wireguard-go 实现,只提供一种 64 KiB 大小的缓冲区用于“拆箱”——每个数据包都要被解密并单独投递。这意味着,一个 1 KiB 的小包,每次都要完整复制进一个 64 KiB 的缓冲区里,造成大量空间浪费和不必要的内存拷贝。这是一个典型的、值得深挖的优化点。
Tailscale 的做法是:在 Linux 和 Android 平台上,不再搬家,而是原地标注。直接记录每个数据包在大缓冲区里的起止位置,多个小包可以共享同一块分配的内存,不需要各自另起炉灶。
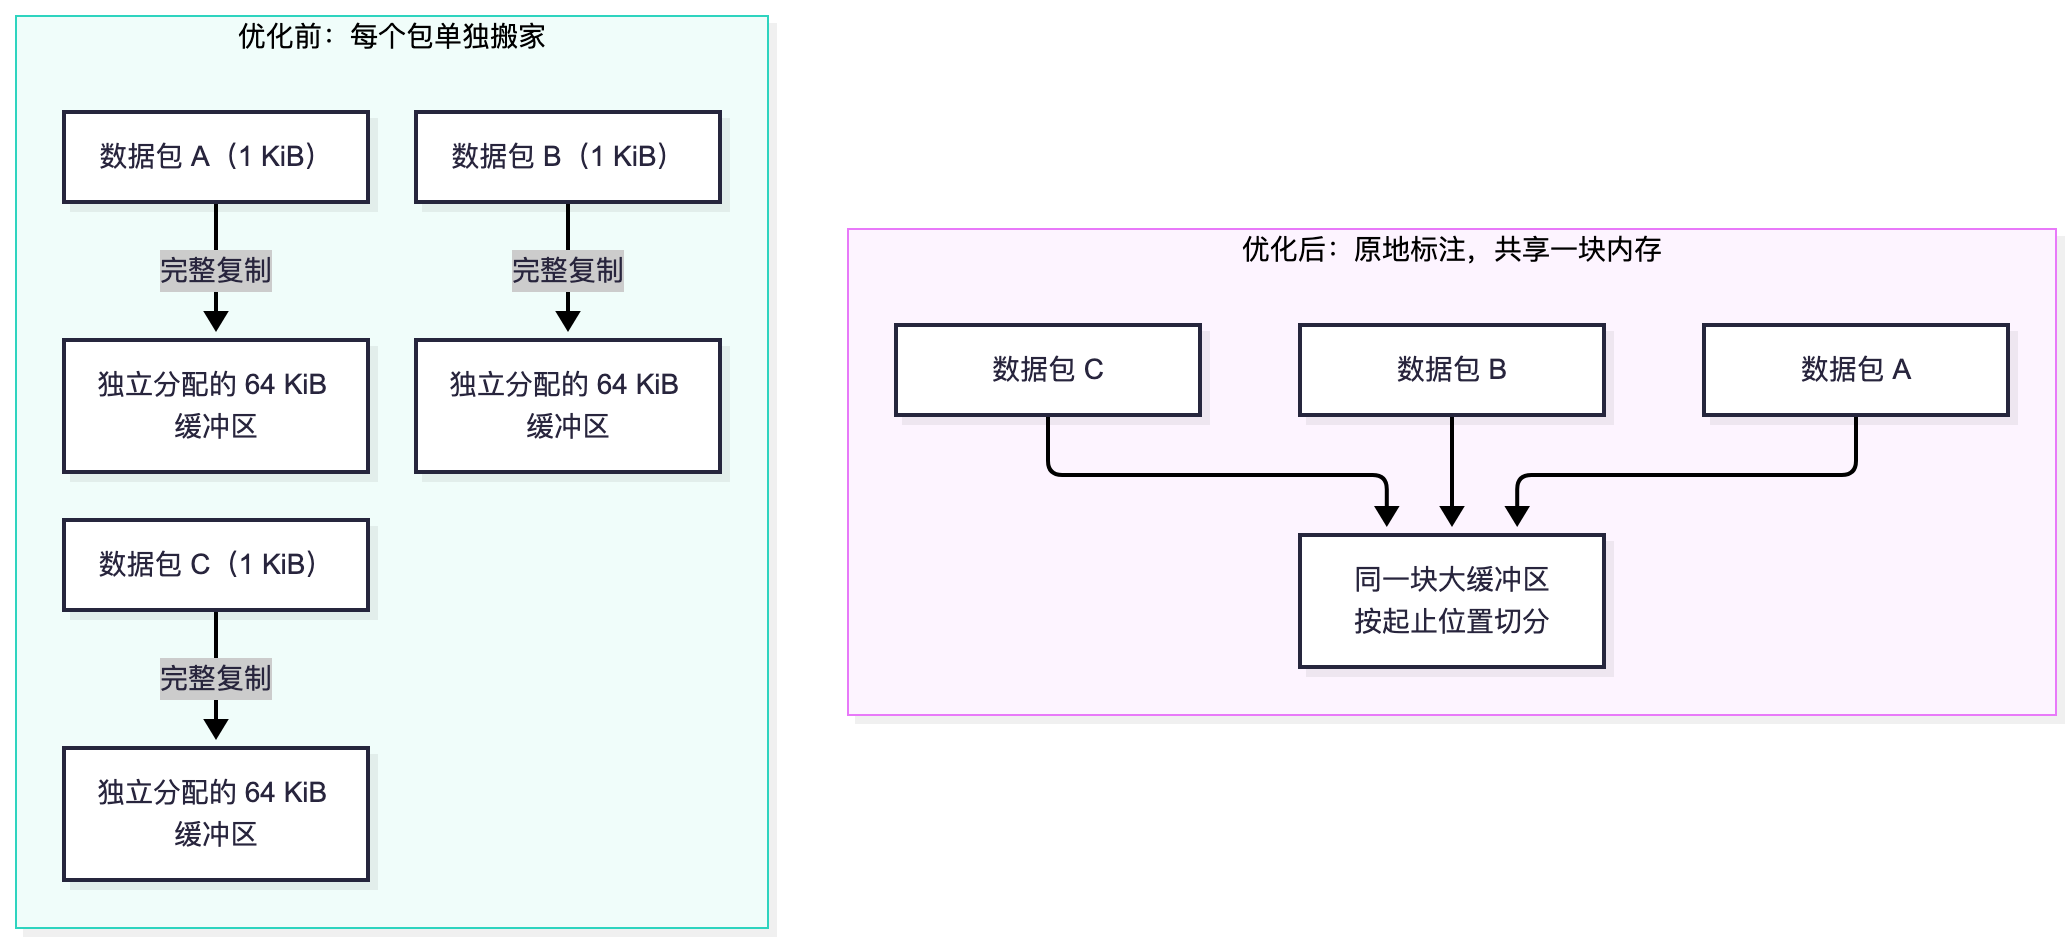
上图展示了优化前后的对比:优化前每个包各占一个 64 KiB 缓冲区(大量空间浪费),优化后多个包被打包进同一块缓冲区并用分隔标记区分。
这项改动本身,就在多种网络配置下带来了约 5% 的速度提升。此外,团队还顺手缩短了数据包在流水线各阶段之间的队列长度——测试发现,绝大多数队列深度根本用不上,缩短队列既减少了等待时间,也降低了内存开销。
省下来的内存去哪了?官方的回答很直接:优先分给最“累”的那批节点——子网路由器和应用连接器。这两类节点,正是下一节的主角。
优化二:多队列架构,让“苦力节点”并行起来
子网路由器(subnet router)在不同 tailnet(Tailscale 网络)里的负载可能天差地别。一个小型家庭实验室的子网路由器,可能只需要转发几个 192.168.x.y 设备的流量;而一个前置云端部署、连接着数百个节点的子网路由器,承载的流量则完全是另一个量级。
在此之前,子网路由器、应用连接器、出口节点处理数据包的方式,是把多个互不相关的连接塞进同一条有序的单线程流水线。为什么要这样设计?因为接收端的应用绝不能看到自己的数据包乱序到达——这是网络协议栈的一条基本约束。但代价是,无论后端有多少 CPU 核心,所有连接都要挤在同一条车道上排队。
既然前面已经省出了内存空间,团队顺势实现了一套多队列系统:车道数量不再固定为 1,而是根据机器资源动态伸缩,与 peer 数量解耦。每一条数据流固定分配到一条车道上,多条车道并行运行,工作负载因此能真正铺开到多个 CPU 核心上。
优化前,所有包依次经过一个 Reader、四个 Crypto 阶段、一个 Writer 后到达 Devices,整条流程是单线的:
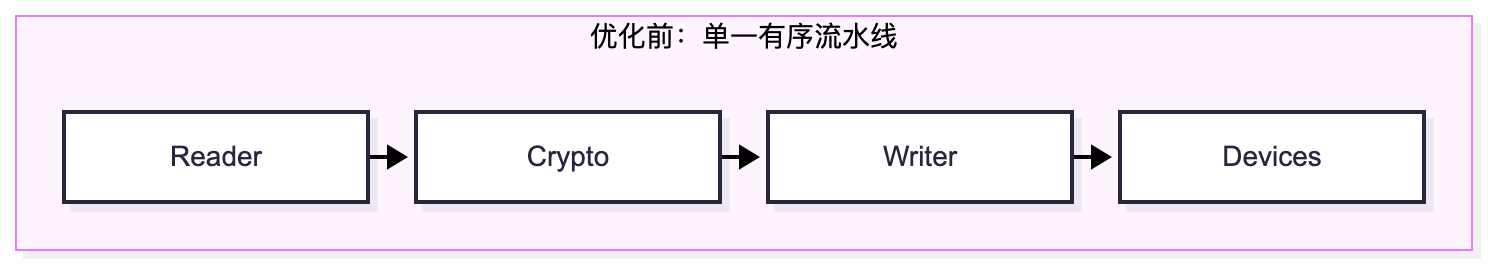
优化后,四组并行的 Reader-Crypto-Writer 流水线分别处理不同数据流,最终汇合到 Devices:
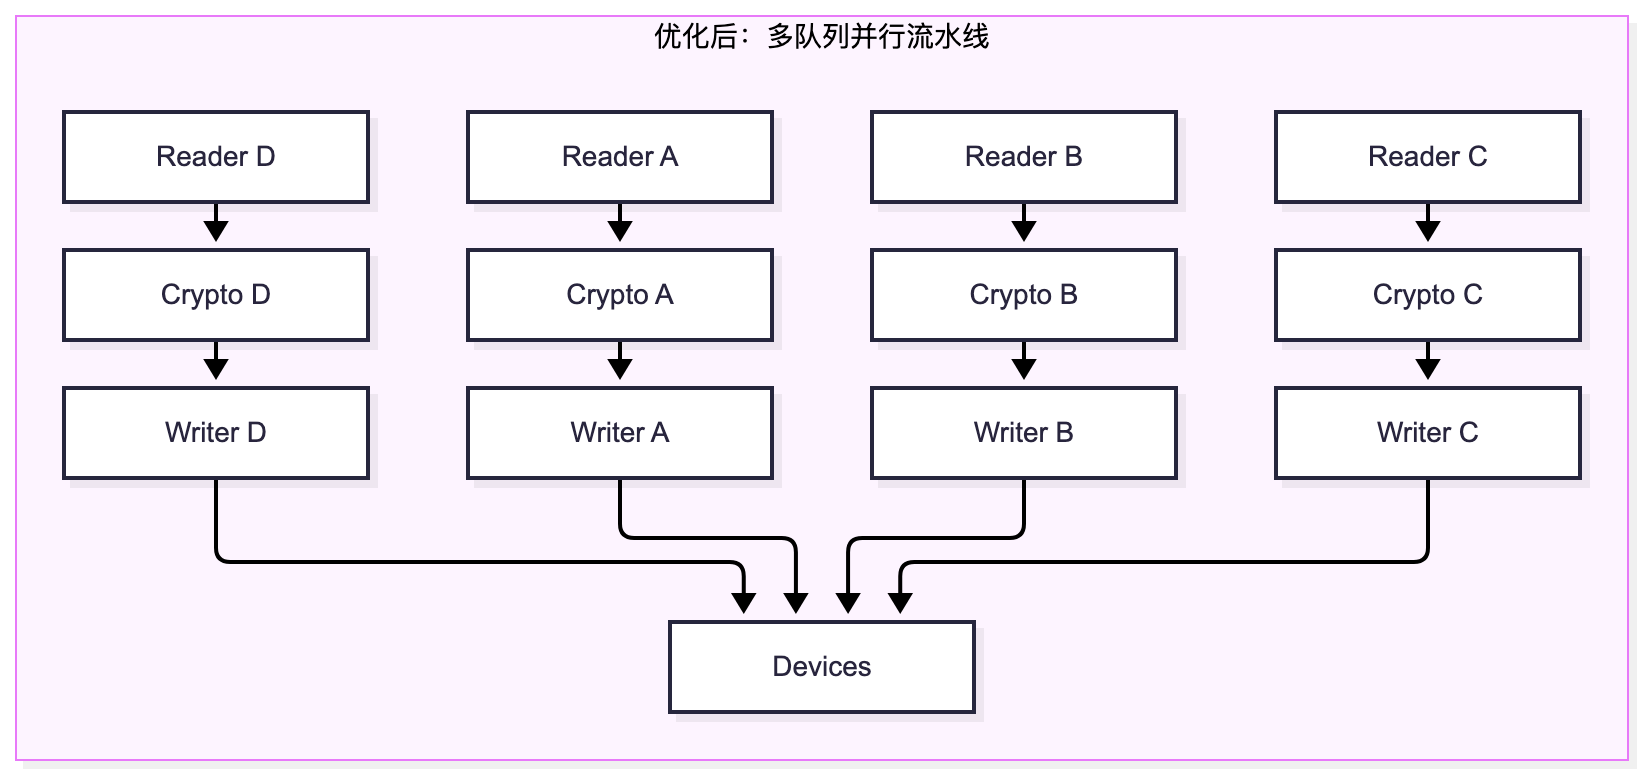
效果是什么?子网路由器和应用连接器的聚合吞吐能力提升,收发数据包之间的延迟降低,同一台机器上已有的硬件资源被更充分地利用。对于那些通常服务大量短连接用户的应用连接器和出口节点来说,这种提升尤其明显。
Tailscale 技术团队成员 Alex Valiushko 在博客中这样总结这项改动的意义:
这意味着更低的延迟,本质上是从数据在网卡上被读取到的那一刻,到被发送给操作系统的那一刻之间,处理速度变得更快了。
优化三:writev,让内核少搬一次家
第三项优化听起来更“底层”,也更 Linux 系统编程一些:Tailscale 客户端开始用上 Linux 的 writev 系统调用。
writev 里的 v 代表“vector(向量)”——它允许 Tailscale 把多段分散在内存中的数据,一次性描述给内核,而不需要先把这些数据拷贝、拼接成一块连续内存,再传给内核。换句话说,Tailscale 只需要告诉内核“这几块数据分别在哪里、有多大”,剩下的搬运工作交给内核一次性完成。
这带来的直接收益是:内存中数据包拷贝次数更少、写操作次数更少、吞吐量更高。这是一个很经典的“减少系统调用次数 + 减少内存拷贝”的性能优化范式,在高性能网络编程中屡见不鲜,Tailscale 这次算是在自己的场景里把它落到了实处。
优化四:网络地图缓存,弱网下的“闪电启动”
前三项优化都聚焦在 Linux / Android 平台的数据平面吞吐上。而第四项优化——netmap caching(网络地图缓存)——瞄准的是一个几乎所有平台都会遇到的问题:启动延迟。
一台设备加入 Tailscale 网络时,通常要先连接 Tailscale 的控制面(control plane),完成身份认证,拿到一份描述“我能连到哪些设备、怎么连”的“网络地图”(netmap)。网络状况良好时,这个过程在 100 毫秒左右就能完成,用户几乎感觉不到延迟。
但现实往往没那么美好。飞机上糟糕的 Wi-Fi、公司里严格的网络过滤,或者其他各种不给力的网络环境,都可能让设备迟迟连不上控制面——问题出在哪还不容易被发现,用户只会感受到一个结果:连不上其他设备。
即便在理想网络条件下,对于一些延迟极度敏感的工作负载来说,100 毫秒的启动延迟也可能显得过长。
网络地图缓存要解决的正是这个问题。启用后,tailnet 中的每台设备都会在本地磁盘上保存一份网络地图的副本。设备启动时,可以先用这份缓存的“旧地图”与其他设备建立连接,与此同时在后台继续尝试联系控制面获取最新信息。这些连接依然是设备之间直接协商完成的,Tailscale 本身不会看到任何流量内容,这一点和平时并无区别。
当然,这项功能也有边界条件:
- 只有设备此前至少成功连接过一次控制面、拿到过网络地图,缓存才能生效;
- 设备需要有持久化磁盘空间来存储缓存;
- 对于超大规模 tailnet,更新缓存可能带来较多磁盘写入,需要权衡;
- 对使用 SD 卡等对写入寿命敏感的存储设备,可能不建议默认开启。
Tailscale 技术团队成员 Claus Lensbøl 这样描述这项功能的价值场景:
网络状况不佳,才是网络地图缓存真正能发挥大用处的地方。设备客户端会说,我们还没联系上控制面,但大概率很快就能联系上,与此同时,你已经可以开始做一些事情了。
根据官方博客披露的数据,在控制面可达性较差的 tailnet 中,“热启动”(使用缓存)相比“冷启动”,数据面开始可用的速度能快一到两个数量级。对于那些启动延迟波动大,或者物理上离 DERP 中继服务器 / 控制面较远的设备,这项改进的实际体验提升会非常明显。
这些改进什么时候能用上?
官方博客给出了一份相对清晰的时间表:
| 优化项 | 平台 | 预计节点 |
|---|---|---|
| 内存开销降低(缓冲区优化) | Linux / Android | v1.104 客户端 |
| 多队列(子网路由器 / 应用连接器受益) | Linux / Android | v1.104 之后的版本 |
吞吐量提升(含 writev 等) |
Linux / Android | 2026 年春季已部分实现,完整收益在 v1.104 之后的版本释放 |
| 网络地图缓存 | 桌面端(当前已可通过功能开关启用);移动端 | v1.104 默认启用(桌面);v1.104 之后(移动端) |
下一站:让网络性能“可诊断、可测试”
博客的最后一部分,Tailscale 团队坦诚地抛出了一个行业性的痛点:性能问题依然很难诊断和测试。他们列出了当前主流性能测试工具存在的几个共性缺陷:
- 分布式测试的“税”:大多数性能工具是点对点的,要求在每个端点上都装一遍;
- 工作流僵化:很容易跑错测试、拿到错误结果,转而去追查一个根本不存在的问题;
- 协议支持滞后:很多工具还不支持 QUIC、HTTP/3 这类较新的协议;
- 缺乏 Tailscale 原生感知:通用工具无法判断一条连接走的是 DERP 中继还是点对点直连,也不知道 Peer Relay 是否能帮上忙,更看不到连接路径随时间的变化。
因此,Tailscale 正在探索一套面向自身架构的原生监控与测试工具,并公开征集用户反馈,帮助定义这套工具的方向。
小结:一次教科书式的系统工程优化
回看这篇博客,会发现 Tailscale 这一次并没有讲什么“颠覆式”的新概念,恰恰相反,四项优化几乎都是网络系统编程里的“经典动作”:减少不必要的内存拷贝、用多队列 / 多核并行替代单线程瓶颈、用向量化系统调用减少内核态往返、用本地缓存缩短启动延迟。
真正值得学习的,是这套“组合拳”背后的工程方法论:先解决内存问题,腾出空间,再用腾出来的资源去解决并发问题;先看清瓶颈发生在哪个具体场景(子网路由器 vs 应用连接器 vs 出口节点),再对症设计架构;在做数据面优化的同时,也没有忽视“看不见摸不着”但同样重要的启动延迟和可观测性问题。
对于用 Go 构建高性能网络基础设施的团队来说,这篇博客值得当作一份实战案例反复咀嚼——它告诉我们,性能优化很多时候不需要“炫技”,把最朴素的系统编程原理,扎扎实实落到每一个具体场景里,就已经足够“快”了。
参考链接
- Tailscale 官方博客原文:We’re making Tailscale faster https://tailscale.com/blog/making-tailscale-faster
- Increasing TCP throughput on Linux devices https://tailscale.com/blog/throughput-improvements
- Surpassing 10Gb/s on bare metal with wireguard-go https://tailscale.com/blog/more-throughput
- 借助分段卸载将 UDP 应用吞吐量提升 4 倍以上 https://tailscale.com/blog/quic-udp-throughput
- Tailscale Peer Relays(Beta) https://tailscale.com/blog/peer-relays-beta
- Peer Relays 如何改善跨国网络性能 https://tailscale.com/blog/peer-relays-international-networks
- NAT Traversal 系列:Looking ahead https://tailscale.com/blog/nat-traversal-improvements-pt3-looking-ahead
- 参与 Tailscale 性能测试工具需求调研 https://tailscale.typeform.com/performance
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。