本文永久链接 – https://tonybai.com/2026/11/10/rust-reference-array-slice-fn-params
大家好,我是Tony Bai。
【导读】
你写过 fn foo(s: [i32]) 吗?编译器会告诉你:大小在编译期未知。你又写过 fn foo(a: &[i32; 3]) 吗?它能跑,却只收长度为 3 的数组。[i32; 3]、[i32]、&[i32; 3]、&[i32],四个长得几乎一样的东西,是 Rust 初学者最容易搞混的语法细节之一。这篇文章用内存布局和函数传参的视角把它们彻底讲清楚,并和 C++、Go 做对比,最后给你一条可以直接抄走的结论。
【文章要点】
- 数组的长度是类型的一部分,
[i32; 3]与[i32; 4]是两种不同的类型。 [i32]是动态大小类型(DST),不能单独作为变量或参数,只能藏在指针后面。&[i32; 3]是瘦指针(8 字节),&[i32]是胖指针(16 字节,地址加长度)。- 与 Go 的切片、C++20 的
std::span相比,Rust 的&[T]在语义上最接近span,但有借用检查器保驾护航。 - 函数参数优先写
&[T]或&mut [T],只有需要严格限定长度时才用&[T; N]。 &[T; N]到&[T]靠的是编译器内置的非固定大小转换(Unsized Coercion),&Vec<T>到&[T]靠的是 Deref 强制转换,二者机制不同。

引子:一道让新手卡住的“送分题”
假设你要写一个函数,打印一串整数。如果你从 Go 或 Python 转来,手感大概是这样的:
fn print_all(s: [i32]) {          // 编译失败
    println!("{:?}", s);
}
编译器会毫不客气地报错:error[E0277]: the size for values of type [i32] cannot be known at compilation time。
你改成 [i32; 3],能跑了,但传一个 4 个元素的数组又报错。你再改成 &[i32; 3],还是一样。最后,你在别人的代码里看到 &[i32],什么都能传,于是照抄,却不知道为什么。
这是 Rust 新手遇到的第一道“暗礁”,很多写了一两年的开发者也只是“知道这么写”,说不清背后的原理。这篇文章要解决的问题是:这四种写法到底差在哪里,函数参数应该怎么选?
这个问题值得花时间弄懂,因为Rust的所有权、借用、Vec、String、迭代器等,几乎都建立在“切片”这个概念之上。这里一知半解,后面每个知识点都会隐隐作痛。
我会先从内存布局讲起,再对比 C++ 和 Go,然后逐一分析四种函数形参,最后给你一张可以直接用的决策表。
四个长得很像的类型
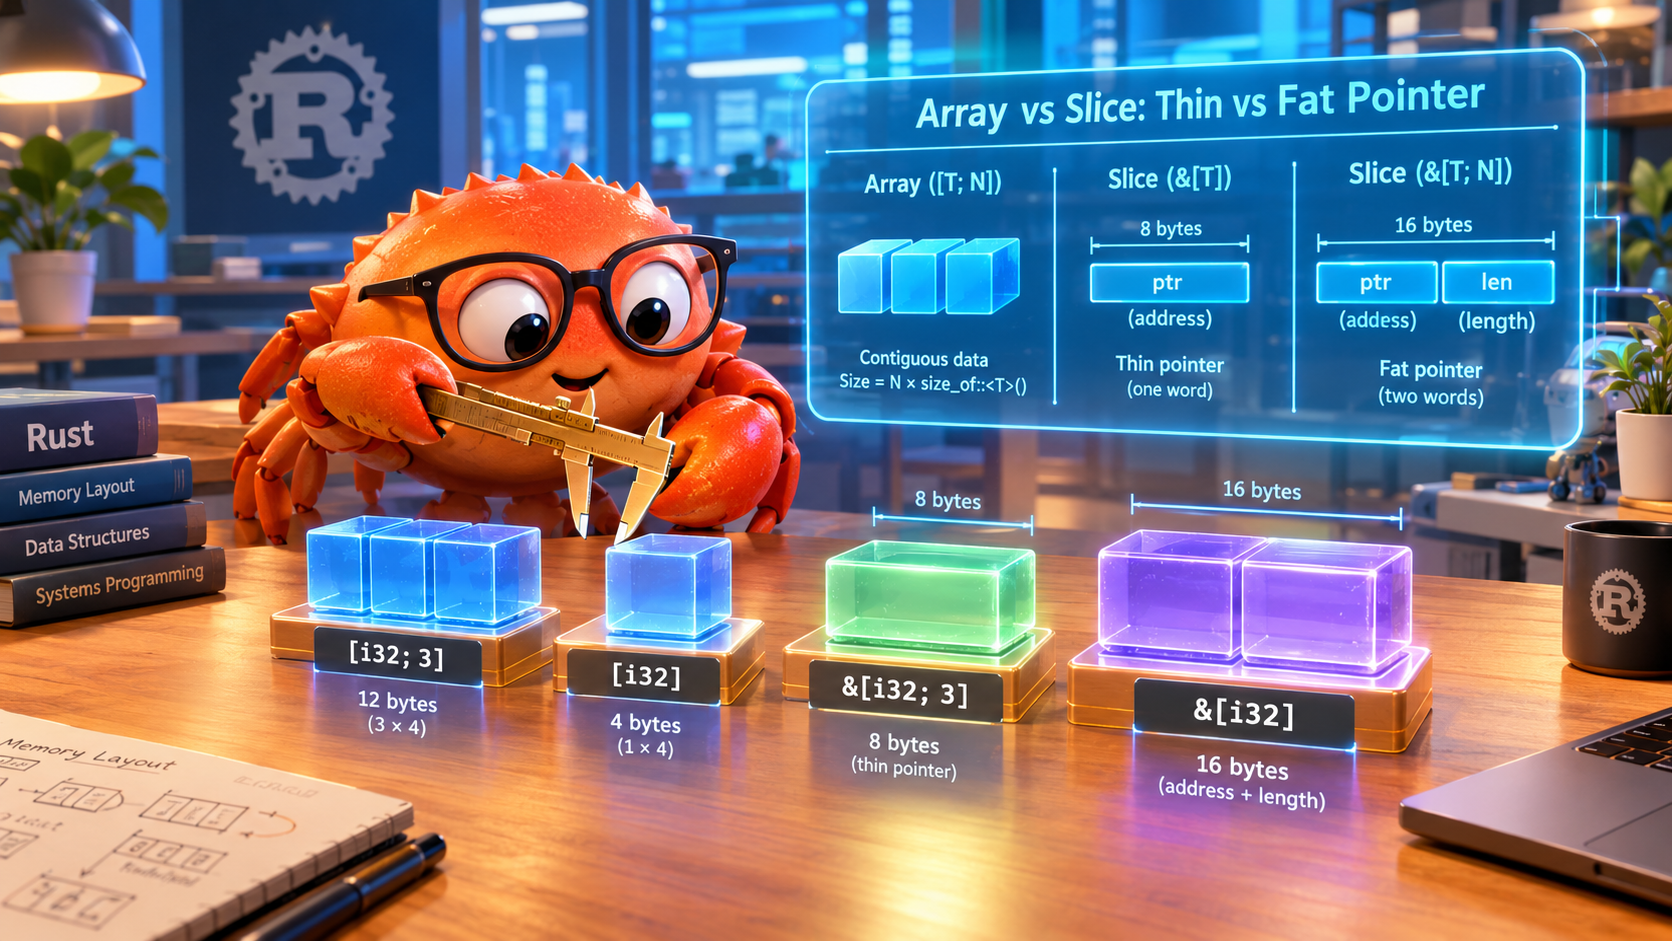
假设要表达 1, 2, 3 这串整数,Rust 里有四种相关的类型。先看结论:
| 写法 | 名称 | 大小是否编译期已知 | 64 位系统下的大小 |
|---|---|---|---|
[i32; 3] |
定长数组 | 是 | 12 字节 |
[i32] |
切片(DST) | 否 | 不存在固定大小 |
&[i32; 3] |
数组引用 | 是 | 8 字节 |
&[i32] |
切片引用 | 是 | 16 字节 |
下面逐个拆解。
- 定长数组
[i32; 3]
它就是栈上连续的 3 个 i32,没有任何额外信息。关键在于:长度是类型的一部分。[i32; 3] 与 [i32; 4] 是两种不同的类型,关系就像 i32 和 String 一样,不能互相替代。
- 切片
[i32]
这是新手最大的坑。它的类型名里没有长度,意味着编译器无法知道它占多少字节。Rust 把这类类型称为动态大小类型(DST,Dynamically Sized Type)。而 Rust 要求局部变量和函数参数的大小必须在编译期确定,所以 let s: [i32] = ... 和 fn foo(s: [i32]) 都是非法的。DST 只能“躲在指针后面”使用。
- 数组引用
&[i32; 3]
这是一个普通的指针,只存首地址,占 8 字节。长度不用存,因为类型签名已经把“3”锁死了。
- 切片引用
&[i32]
这就是平时大家口中的“切片”。它是一个胖指针(Fat Pointer),由两部分组成:数据首地址(8 字节)和元素个数(8 字节)。长度信息从类型里搬到了运行时的值里。
用代码验证一下:
use std::mem::{size_of, size_of_val};

fn main() {
    let arr = [1, 2, 3];
    println!("{}", size_of::<[i32; 3]>());   // 12
    println!("{}", size_of::<&[i32; 3]>());  // 8
    println!("{}", size_of::<&[i32]>());     // 16
    println!("{}", size_of_val(&arr[..]));   // 12:切片指向的数据大小
}
内存布局如下图:
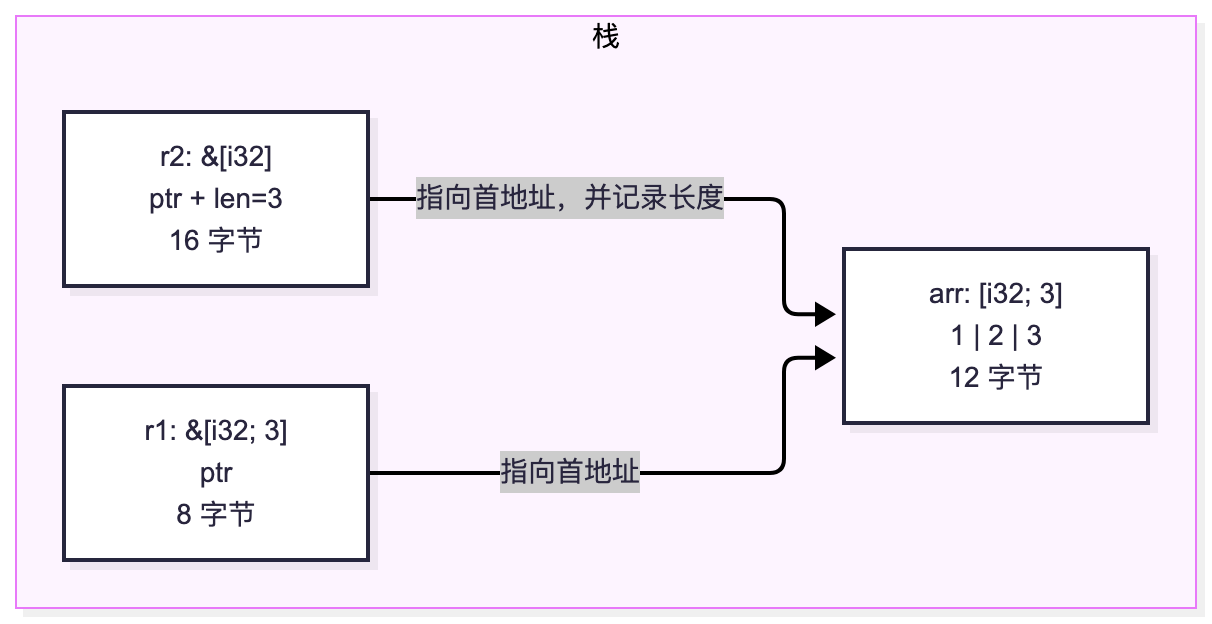
记住一个关键对比:瘦指针靠类型记住长度,胖指针靠值记住长度。这个差别决定了后面所有的行为。
横向对比:C++ 和 Go 是怎么做的
理解 Rust 的设计取舍,最好的办法是看看别人怎么处理同一个问题。
C++:长度会丢失。
C++ 里的原生数组 int arr[3] 传给函数时会“退化”为指针,长度信息当场丢失:
void foo(int* p, size_t n);        // 必须额外传长度
void bar(int p[3]);                // 看似有长度,实际仍是 int*
bar 里的 sizeof(p) 得到的是指针大小,不是 12。这是无数越界 bug 的源头。C++20 引入的 std::span<int> 才算补上了这个缺口,它同样是“指针加长度”,在语义上与 Rust 的 &[i32] 最接近。
Go:切片是一等公民。
Go 把 [3]int(数组,值类型,传参会整体拷贝)和 []int(切片)都做进了语言里,且切片是 24 字节的描述符:指针、长度、容量。Go 的切片天然能“长大”,代价是多个切片可能共享同一块底层内存,写入互相影响,需要程序员自己小心。
Rust:把“视图”和“所有者”拆开。
&[i32] 只有指针和长度,没有容量,因为它只是一个借用的视图,既不拥有数据,也不负责扩容。扩容是 Vec<i32> 的事。
| C++ | Go | Rust | |
|---|---|---|---|
| 定长数组传参 | 退化为指针,丢失长度 | 整体拷贝 | 按值拷贝,或传引用 |
| 通用序列视图 | std::span(C++20) |
[]int(24 字节) |
&[i32](16 字节) |
| 能否扩容 | 视图不能 | 切片可以(append) |
视图不能,Vec 可以 |
| 安全保证 | 无 | 无借用检查 | 借用检查器保证无悬垂、无别名写 |
所以你会发现:Rust 并不是“没有切片”,而是把切片拆成了更精确的两层:[T] 是数据,&[T] 是借用它的视图。
函数形参的四种写法
回到开头的问题。假设函数要读取一串整数,我们逐个分析。
写法 1:按值传数组 fn foo(arr: [i32; 3])
fn print_by_value(arr: [i32; 3]) { println!("{:?}", arr); }

let a = [1, 2, 3];
print_by_value(a);   // i32 是 Copy,整个数组被逐字节复制
问题有两个:只接受长度恰好为 3 的数组,且数组越大,栈上拷贝越贵。
写法 2:传数组引用 fn foo(arr: &[i32; 3])
fn print_array_ref(arr: &[i32; 3]) { println!("{:?}", arr); }

print_array_ref(&a);   // 只传 8 字节地址,无拷贝
没有拷贝了,但依然死板:你无法为它扩容,无法用它打印 [1, 2, 3, 4]。
写法 3:按值传切片 fn foo(s: [i32])
直接编译失败,原因前面说过:参数入栈需要确定大小,而 [i32] 是 DST。
写法 4:传切片引用 fn foo(s: &[i32])
这是标准库和绝大多数第三方库的做法:
fn print_slice(s: &[i32]) {
    println!("len: {}, data: {:?}", s.len(), s);
}

let arr3 = [1, 2, 3];
let arr5 = [1, 2, 3, 4, 5];
let v = vec![10, 20, 30];

print_slice(&arr3);        // 数组引用
print_slice(&arr5);        // 不同长度也行
print_slice(&arr5[1..4]);  // 子区间 [2, 3, 4]
print_slice(&v);           // 堆上的 Vec 也行
一个签名通吃四种输入。如果需要修改元素,用 &mut [i32]:它允许改写元素,但不能增删,因为“视图”没有扩容的能力。
为什么这些类型能自动转换?
你可能会问:我传的明明是 &[i32; 3] 或 &Vec<i32>,为什么能被 &[i32] 接收?这里其实有两套不同的机制,很多教程把它们混为一谈。
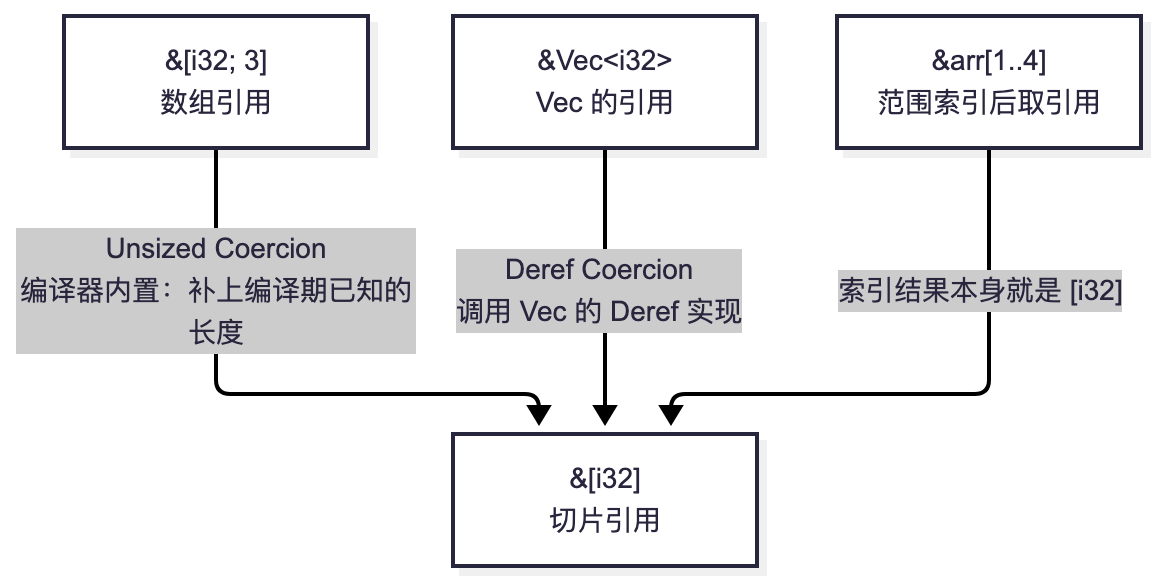
数组到切片:Unsized Coercion
编译器知道数组长度是 3,于是把 8 字节的瘦指针升级成 16 字节的胖指针,补上长度 3。这是编译器内置的转换,不经过 Deref。
Vec 到切片:Deref Coercion
Vec<T> 实现了 Deref<Target = [T]>,编译器在需要 &[T] 的地方,会自动对 &Vec<T> 解引用一次。String 到 &str、Box<T> 到 &T 也是同一套机制。
两者的共同点是:转换发生在函数调用处,由编译器自动完成,零额外成本。
两个进阶技巧
1. 反向转换:从切片得到数组
有时你手里是 &[i32],却需要一个定长数组,比如解析二进制协议头:
let s: &[i32] = &[1, 2, 3, 4, 5];
let head: [i32; 3] = s[..3].try_into().unwrap();      // 拷贝出数组
let head_ref: &[i32; 3] = s[..3].try_into().unwrap(); // 或者得到数组引用
转换会在运行时检查长度,不匹配就返回 Err,因此用的是 try_into 而不是 into。
2. 既要定长,又要通用:const 泛型
如果你确实需要“任意固定长度”的数组参数,不要为每个长度写一遍函数,用 const 泛型:
fn sum<const N: usize>(arr: &[i32; N]) -> i32 {
    arr.iter().sum()
}
这样 N 在编译期被推导出来,长度仍然是类型的一部分,编译器可以据此做更激进的优化。
小结
我们回顾一下这篇文章的主线:Rust 把“序列”拆成了数据本身([T; N]、[T])和对数据的借用(&[T; N]、&[T]),其中 [T] 因为大小未知,只能通过胖指针 &[T] 使用。
最后给你一张可以直接用的决策表:
| 你的需求 | 形参写法 | 说明 |
|---|---|---|
| 只读任意长度序列 | &[T] |
默认选择,兼容数组、Vec、子区间 |
| 就地修改元素 | &mut [T] |
可改元素,不能增删 |
| 必须恰好 N 个元素 | &[T; N] 或 const 泛型 |
如矩阵运算、固定协议头 |
| 小型定长数据,需要所有权 | [T; N] |
如坐标 [f32; 2],仅限很小的数组 |
| 需要增删元素 | &mut Vec<T> |
视图做不到,需要所有者 |
一句话口诀:参数想通用,就写 &[T];想严格,才写 &[T; N]。
最后留两个思考题,欢迎在评论区讨论:
- 为什么
&mut [i32]不能push,而&mut Vec<i32>可以? - 如果函数参数写成
impl AsRef<[i32]>,和&[i32]相比有什么取舍?
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。