本文永久链接 – https://tonybai.com/2026/10/23/go-and-simd-2026
大家好,我是Tony Bai。
长期以来,Go 语言在高性能计算和底层硬件优化领域常被提及的一个痛点就是缺乏对 SIMD(单指令多数据流)的原生高级支持。想要榨干现代 CPU 的向量计算性能,开发者往往不得不编写繁琐、脆弱且难以维护的纯汇编代码。
随着 Go 官方对向量化支持的探索推进,全新的实验性包(simd 与 simd/archsimd)为我们带来了直接在 Go 中编写 SIMD 代码的可能性。本文译自 Jesús Espino 的深度解析文章《SIMD and Go》,作者深入浅出地讲解了 SIMD 的硬件工作原理、Go 语言中这两套全新 SIMD 包的设计权衡、常见核心操作与编译器底层黑魔法,并通过一个完整的点积实例展示了高达 9 倍的极致性能提升。无论你是关注 Go 语言最新演进,还是希望在日常业务中榨取 CPU 性能,这篇文章都值得一读。
以下是译文全文:
设想一个平平无奇的循环:遍历两个 []float32 切片,逐元素将它们相加。用普通的 Go 代码编写时,CPU 每一步只能处理一对数字。但有趣的是,同一颗 CPU 上的硬件明明拥有一次性处理八对数字的能力,而普通的 Go 循环却完全没有利用这一点。
这项硬件技术就是 SIMD。直到最近,在 Go 中使用它的唯一途径还是手写汇编。现在,Go 引入了实验性的 simd/archsimd 包(Go 1.26)以及构建在其之上的可移植(跨平台)simd 包(Go 1.27),因此你只需编写常规的 Go 代码,编译器就能将其转换为 SIMD 指令。
本文将从 SIMD 在 CPU 内部的工作机制讲起,并介绍 Go 的两个 SIMD 包。随后,我们将逐一梳理最常见的 SIMD 操作及其对应的 Go 代码,窥探编译器如何让这一切生效,最后将所有内容融会贯通到一个小巧实用的真实示例中。
📌 范围说明
本文所有内容均基于 Go 1.27.0 并开启 GOEXPERIMENT=simd。该包目前仍处于实验阶段,因此具体名称在后续版本中可能会有所变动。本文将专注于 amd64 架构(Intel 和 AMD CPU),并略过大量繁杂的指令集细节,以保证核心概念清晰易懂。
在正式编写 Go 代码之前,我们先来看看硬件所谓的“一次处理八对数字”究竟意味着什么。
SIMD 到底意味着什么?
SIMD 是“单指令多数据流”(Single Instruction, Multiple Data)的缩写。但这到底是什么意思呢?我们把同一个操作的两种写法并排对比:左边不使用 SIMD,右边使用 SIMD。
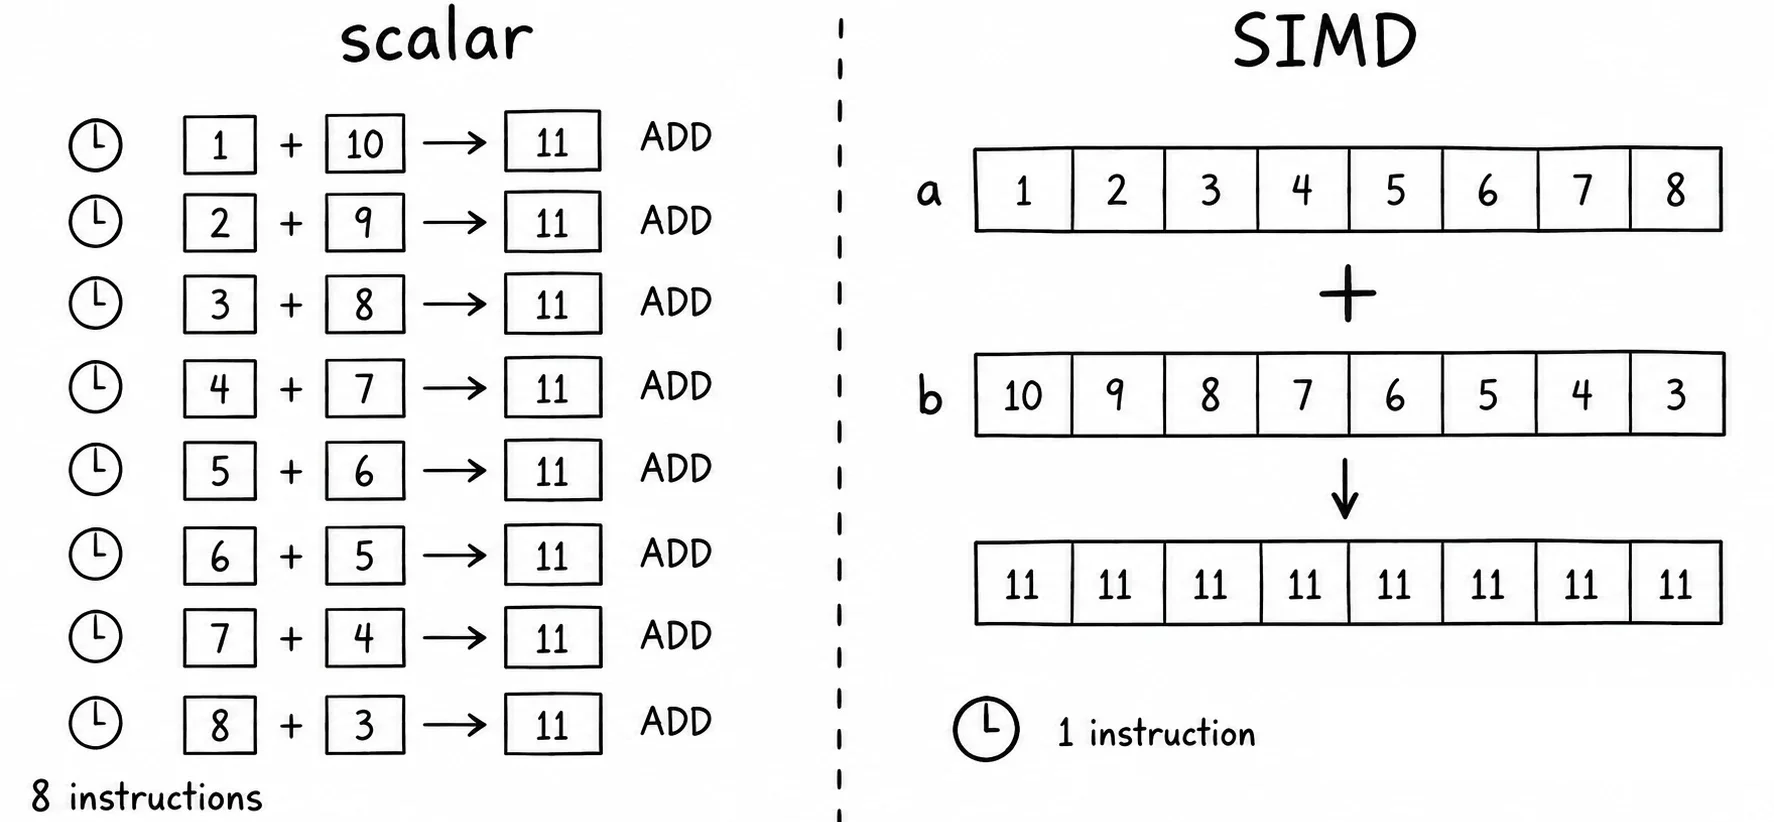
标量(Scalar)版本是一个普通的循环:一条指令把一对数字相加,下一条指令再把下一对相加,连续执行八次。而 SIMD 版本的运作机制截然不同:单条 CPU 指令一次性获取来自 a 的全部八个数字和来自 b 的全部八个数字,并一口气将它们全部相加。一条指令代替了八条指令。
但这里有一个限制:所有八次加法必须是完全相同的操作。你不能在一个槽位中做加法,而在下一个槽位中做乘法。SIMD 最适合处理大量需要相同处理流程的独立数据,这在图像处理、音频处理或机器学习等领域中非常普遍。
不过请注意,在 SIMD 版本中,所有这八个数字在相加之前必须已经集中存储在某处。这个“某处”指的就是一种特殊的寄存器。
普通的寄存器只能容纳一个 64 位的值,因此根本装不下八个浮点数。SIMD 拥有属于自己的、容量大得多的向量寄存器(Vector Registers):这取决于具体的 CPU,其位宽通常为 128 位、256 位或 512 位。在本文中,我们主要使用 256 位的寄存器,它恰好可以容纳八个 float32 值。
但 256 位存放的到底是什么?浮点数?还是字节?我们不妨更仔细地观察一下这类寄存器。
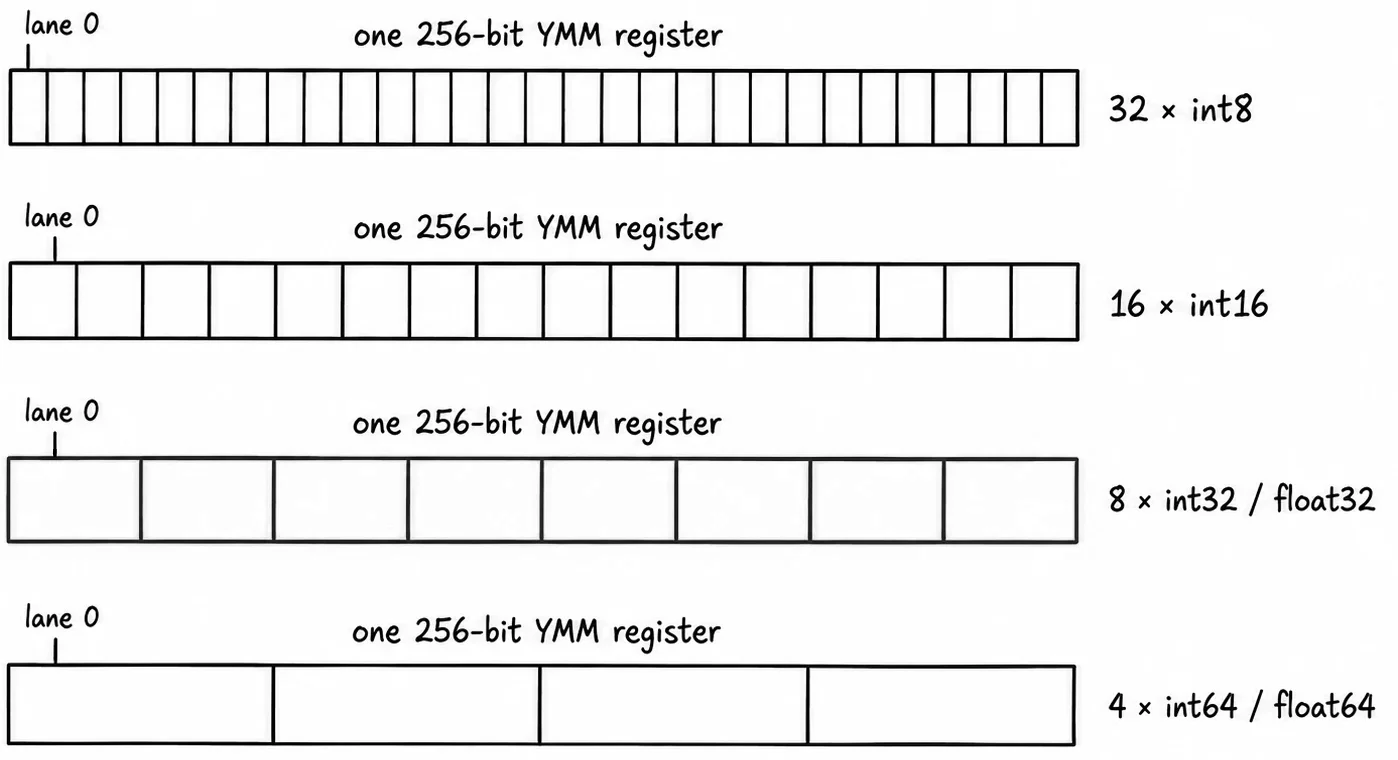
向量寄存器本质上就是一堆二进制位,正如你在图中所见,我们可以将其拆分成不同大小的槽位,这些槽位被称为通道(Lanes)——例如 32 个 8 位整数通道,或 4 个 float64 通道。寄存器本身并不关心数据类型,具体如何切分由每条指令决定。在我们的大多数示例中,使用的是 8 个 float32 通道。
现在我们有了划分好通道的大寄存器,那么在实际中该如何使用它们呢?
SIMD 的标准生命周期:加载(Load)、运算(Operate)、存储(Store)
几乎所有 SIMD 代码都遵循相同的三个步骤:将数据载入寄存器、进行数学运算、将结果写回。下面我们逐一来剖析它们。
第一步是将寄存器填满,这就是向量加载(Vector Load)的任务。
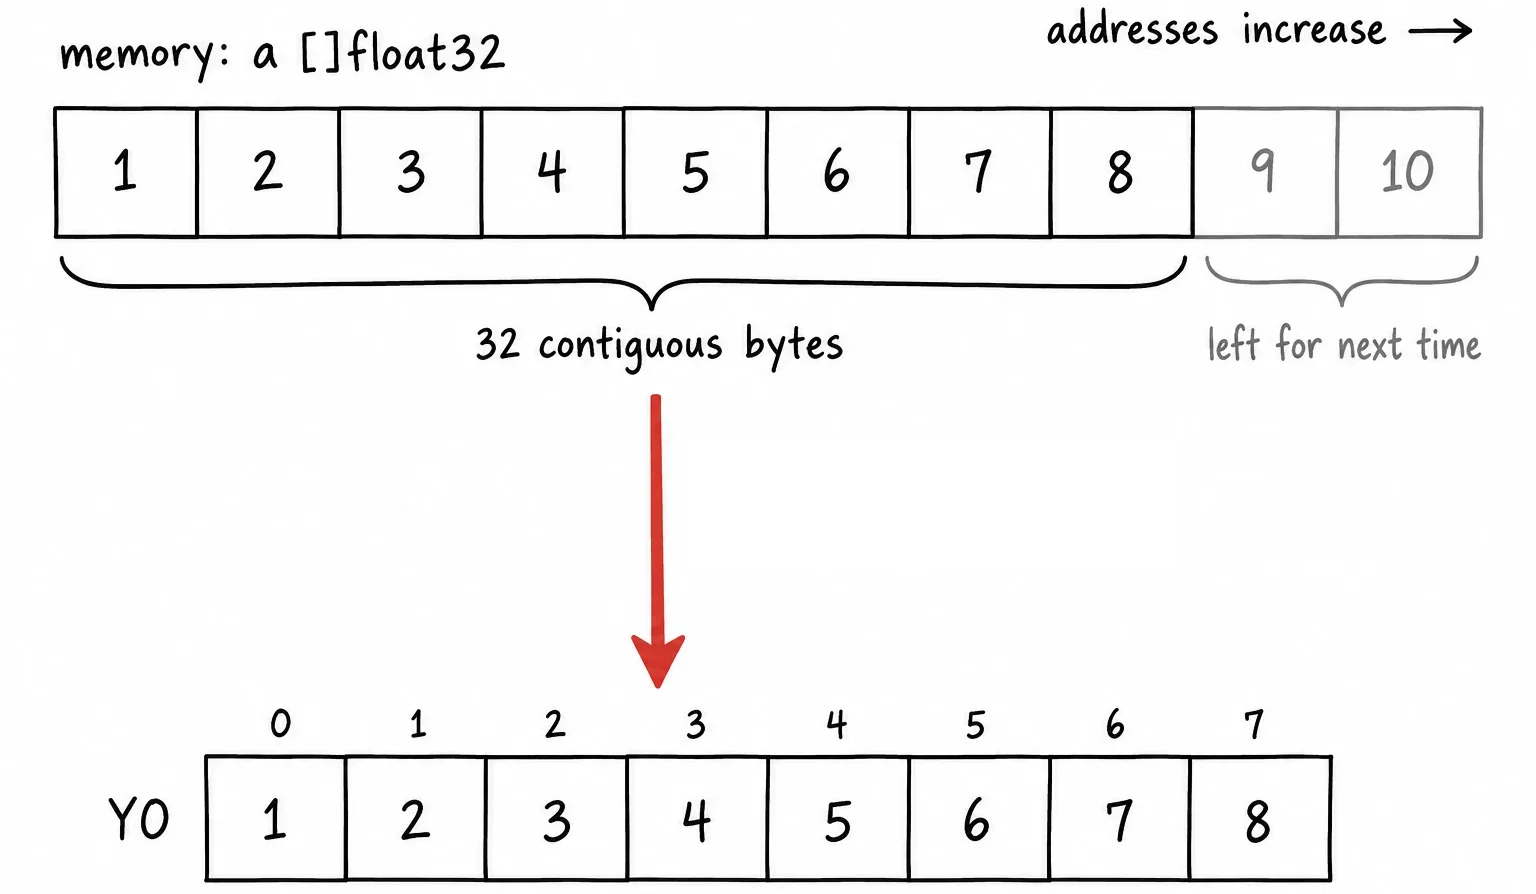
加载操作一次性从切片中读取八个 float32 值,并将它们放入寄存器的八个通道中:a[0] 进入通道 0,a[1] 进入通道 1,以此类推。一条指令,填满一整个寄存器。末尾的 9 和 10 放不下了,只能等待下一次加载。后文我们会讨论如何处理这类剩余元素。
当 a 和 b 分别就位在各自的寄存器中后,我们就可以开始执行运算了。
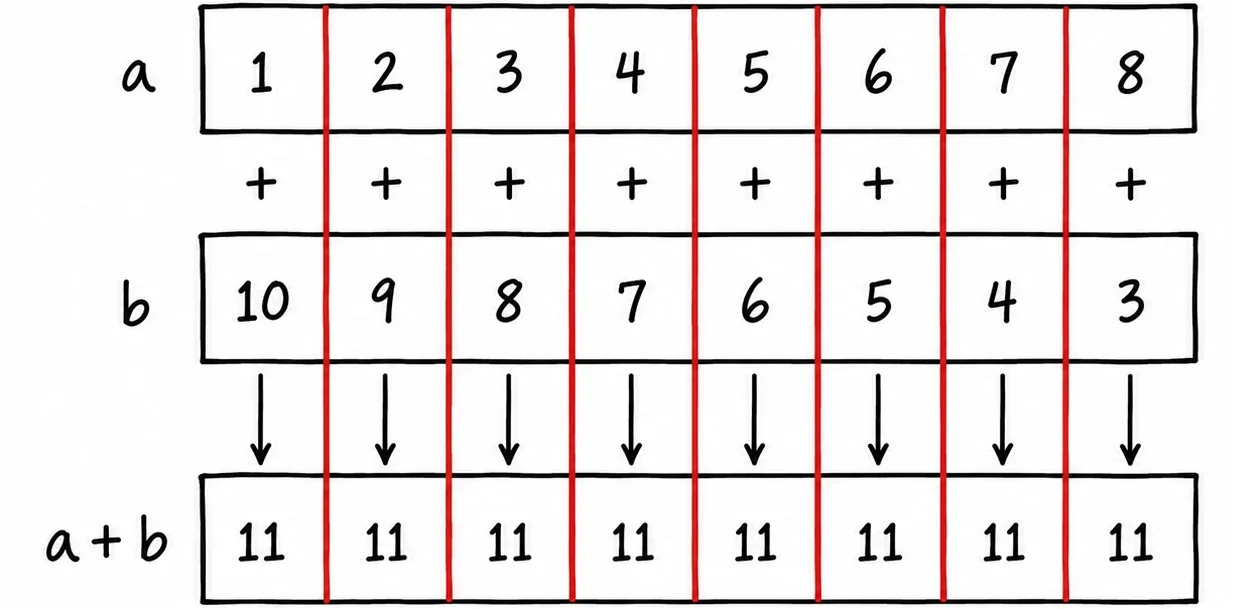
观察任意单个通道:a 的通道 3 加上 b 的通道 3,结果存入目标寄存器的通道 3。每个通道只与另一个寄存器中对应的同位通道进行交互。这被称为垂直操作(Vertical Operation),绝大多数 SIMD 指令都按此方式工作。
你可以把每个通道想象成一个彼此隔离的微型计算器,它们之间有墙壁相隔,任何数据都不会从一个通道溢出到相邻通道。而且运算结果不会直接写回内存,而是保存在另一个寄存器中,随时可供下一条指令使用。
数学运算完成后,我们需要将结果从寄存器中取出。通常有两种方式。第一种是向量存储(Vector Store),即加载(Load)的反向操作。
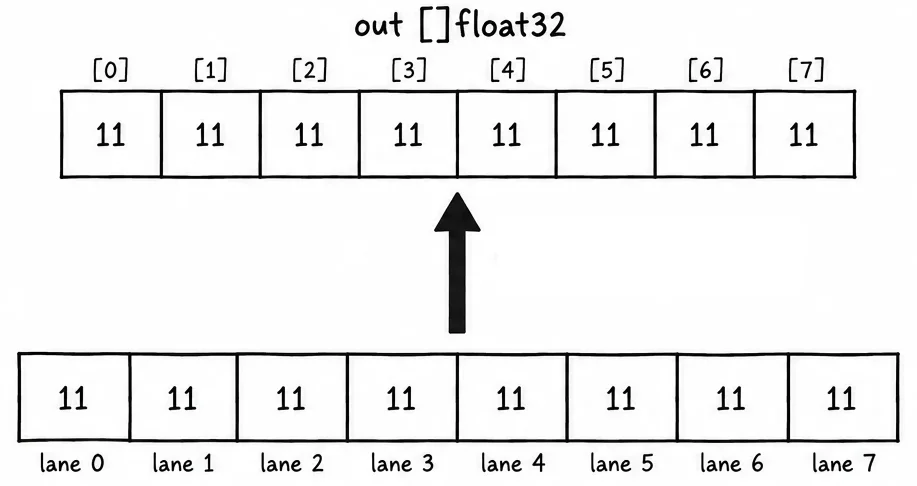
所有八个通道的数据一次性写回内存:通道 0 写入 out[0],通道 1 写入 out[1],依此类推。如果你的计算结果是另一个切片,这正是你所需要的方式。
第二种方式是提取单通道元素(Extracting a Lane)。
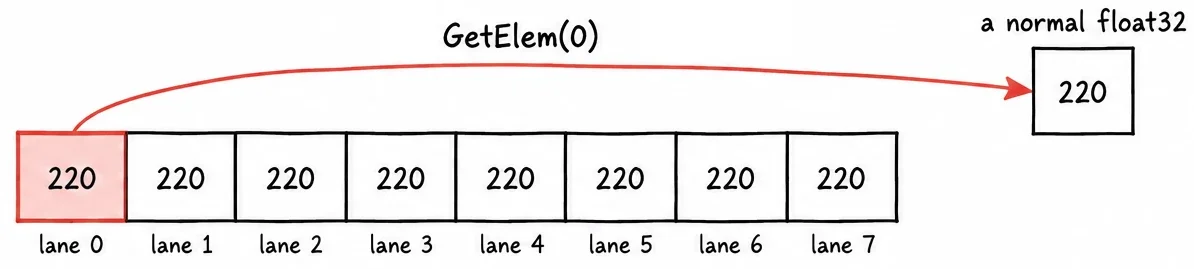
在这里,我们将单个通道的数据提取到一个常规变量中(本例中为通道 0)。提取单个值尚可,但若连续执行八次提取,就会彻底抹平我们刚通过向量化换来的性能优势。
这就是硬件层面上 SIMD 的完整生命周期。接下来看看在 Go 语言中该如何编写。
Go 中的 SIMD:两个官方包
在深入探讨更多运算操作之前,我们先认识一下接下来会用到的 Go 官方包,这样后文的代码示例理解起来就会轻松很多。Go 提供了两个包,它们都只在启用 GOEXPERIMENT=simd 构建时有效。
simd/archsimd:每个寄存器对应一种固定类型
底层的包是 simd/archsimd。它与 CPU 的具体架构紧密绑定(详见包文档),并几乎与我们刚才看到的物理寄存器及通道形成一对一的映射。类型根据通道类型及通道数量进行命名:Float32x8 表示拥有八个 float32 通道的寄存器(256 位),Float32x4 拥有四个通道(128 位),而 Float32x16 拥有十六个通道(512 位)。使用方式完全符合我们刚讨论的生命周期:使用 LoadFloat32x8 加载数据,在其上调用 Add 等操作,最后使用 Store 或 GetElem 将数据导出。
下面是用它对切片做逐元素相加的代码,每次处理八个浮点数(剩余尾部元素稍后处理):
func add(a, b, out []float32) {
    for i := 0; i+8 <= len(a); i += 8 {
        x := archsimd.LoadFloat32x8(a[i:])
        y := archsimd.LoadFloat32x8(b[i:])
        x.Add(y).Store(out[i:])
    }
}
simd:可移植的通用包
archsimd 赋予了你对硬件的完全控制权,但代价也是显而易见的:你必须亲自选择寄存器的大小。使用 Float32x8 编写的代码,即便在支持 512 位的 CPU 上也只能使用 256 位;而在根本没有 256 位寄存器的 ARM 架构上,它甚至无法通过编译。Go 1.27 引入了第二个包来解决这个问题:simd。
它的类型名称中不再带有具体尺寸:如 Float32s、Int8s、Mask32s(详见包文档)。其大小是在程序启动时根据当前宿主 CPU 动态决定的,调用 v.Len() 即可得知当前可用的通道数量。除此之外,其他方法与底层包别无二致:Add、MulAdd、Store 等等。
下面是用通用的 simd 包重写的相同函数:
func add(a, b, out []float32) {
    var v simd.Float32s
    n := v.Len() // 取决于 CPU,可能为 4、8 或 16
    for i := 0; i+n <= len(a); i += n {
        x := simd.LoadFloat32s(a[i:])
        y := simd.LoadFloat32s(b[i:])
        x.Add(y).Store(out[i:])
    }
}
循环的基本逻辑完全一致,唯一的不同在于步长不再是硬编码的常量 8,而是直接向向量对象动态查询其通道数。
在本文后续的示例中,我将统一使用 archsimd,因为它的类型与示意图完全吻合:一个 Float32x8,恰好对应八个通道。
了解了基本包结构后,我们来看看除了简单的向量相加之外,这些通道还能完成哪些复杂操作。
常用操作全景展示
加载、垂直运算和存储能够满足基础需求。但现实业务代码中往往充满了常量、累计求和、if 条件分支以及乱序数据,而每个通道却依然必须执行同一条指令。以下是 SIMD 应对这些场景的核心工具集。
针对每项操作,我都会给出对应的 simd/archsimd Go 代码实现。
我们从最简单的操作开始。
广播(Broadcast):一个值赋满所有通道
很多场景需要将向量与单个数字混合运算:比如让所有元素乘以 0.5,或是将每个值与一个常数进行比较。但是像 Add 这样的运算需要两个向量,那第二个向量从何而来?
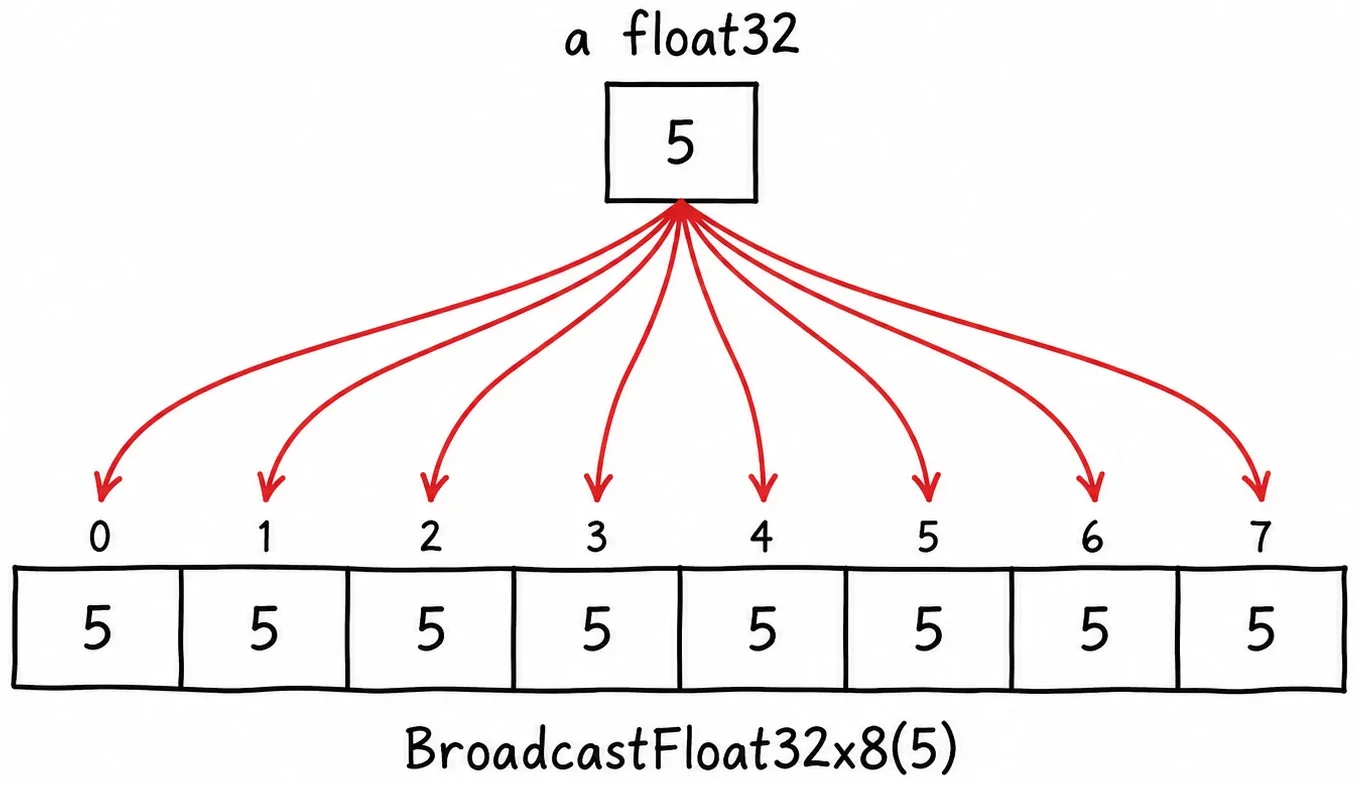
答案就是将单个数值直接复制填充到每个通道中。这就是广播(Broadcast):输入一个标量,输出一个填满该标量的完整寄存器。这一操作开销极低,通常在循环开始前执行一次即可。
five := archsimd.BroadcastFloat32x8(5) // 结果为 [5 5 5 5 5 5 5 5]
搞定了常量,我们再来看看如何让每条数学指令榨出更多性能。
融合乘加(FMA, Fused Multiply-Add):两步合并为一步
大量的数值计算最终都可以归结为“将两者相乘,再将积累加到总和中”。我们真的需要两条指令来完成这一步吗?
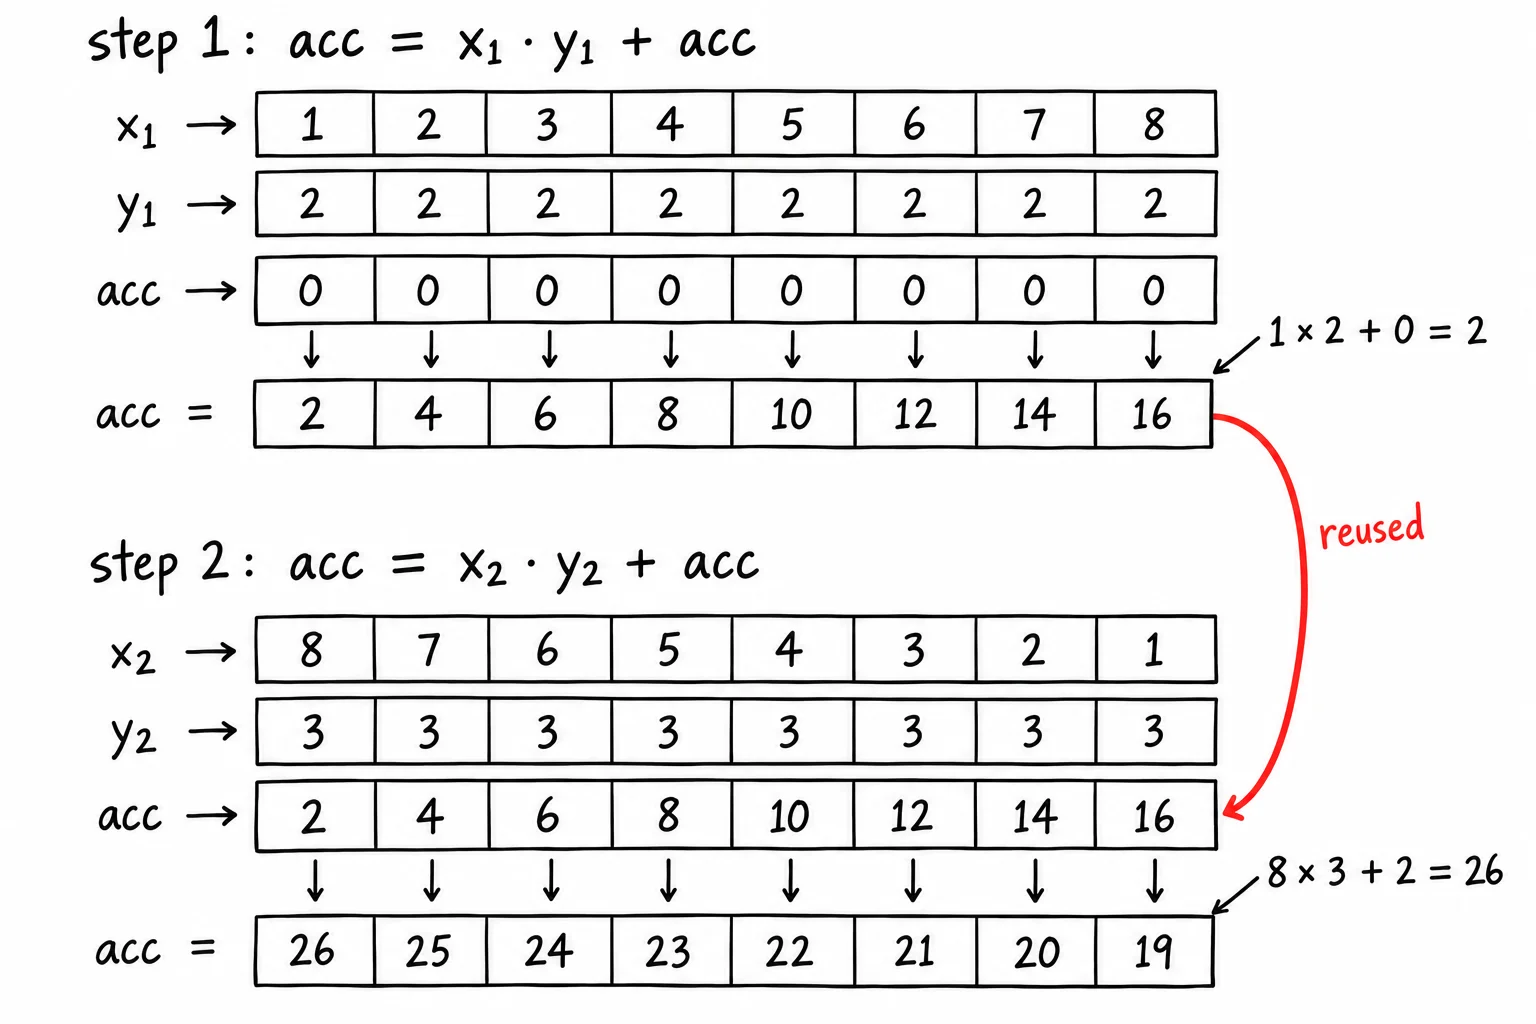
从步骤 1 开始,观察通道 0:1 * 2,加上当前 acc 中原本就存着的 0,结果得到 2。每个通道在同一瞬间并行执行完全相同的计算,全部耗时仅需单条指令。这就是融合乘加(Fused Multiply-Add,简称 FMA),它的执行速度通常和普通的乘法指令一样快。现在顺着红色箭头看:步骤 1 的结果直接作为步骤 2 的 acc 输入,因此通道 0 计算 8 * 3 + 2 = 26,并在已有结果上继续累加。持续串联执行这一步骤,每个通道就能各自维护一个累加值,这正是计算点积(Dot Product)时的刚需。
在 Go 中,对应的方法是 MulAdd,它用于计算 x*y + z:
x1 := archsimd.LoadFloat32x8([]float32{1, 2, 3, 4, 5, 6, 7, 8})
x2 := archsimd.LoadFloat32x8([]float32{8, 7, 6, 5, 4, 3, 2, 1})

var acc archsimd.Float32x8                              // 所有通道初始为 0
acc = x1.MulAdd(archsimd.BroadcastFloat32x8(2), acc)   // 结果为 [2 4 6 8 10 12 14 16]
到目前为止,每个通道都是在机械地计算数字。接下来,让通道学会“做出判断”。
比较运算生成掩码(Masks)
在普通代码中,你可以随意写 if a[i] > 5 { ... }。但在 SIMD 中你无法这么做,因为全部八个通道必须执行完全一致的指令,硬件不可能允许部分通道跳转分支而其他通道不跳转。那么比较操作究竟会返回什么呢?
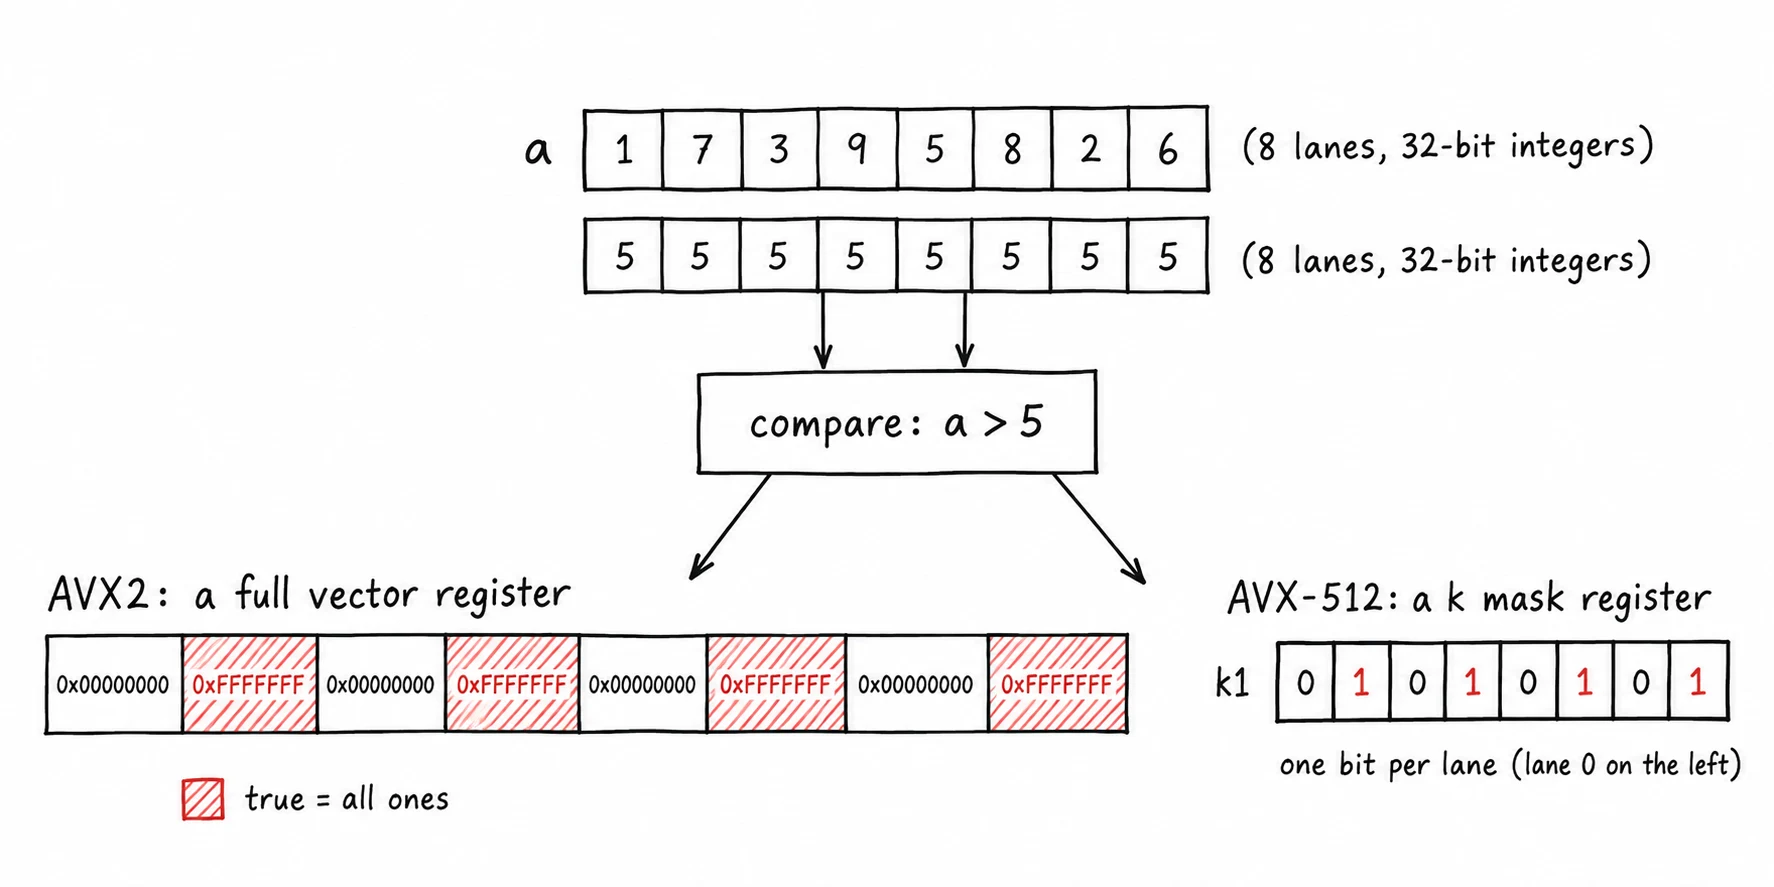
它会返回一个掩码(Mask):每个通道对应一个 True/False 的布尔结果。在这里,我们将 a 与广播出来的常量 5 进行比较,通道 1、3、5 和 7 的判定结果为 True。图中展示了硬件存储该结果的两种方式:对于本文使用的 256 位寄存器,它依然保存在一个标准的向量寄存器中,“True”通道的所有位全置为 1,“False”通道的所有位全置为 0;而在 512 位向量(需要 AVX-512 支持)下,它会存入专用的独立掩码寄存器(k0 至 k7),每个通道仅占用 1 个二进制位。但在 Go 语言层面,你无需关心底层是哪种存储方式:掩码统一抽象为 Mask32x8 类型。
a := archsimd.LoadFloat32x8([]float32{1, 7, 3, 9, 5, 8, 2, 6})
five := archsimd.BroadcastFloat32x8(5)

mask := a.Greater(five)  // 通道 1、3、5、7 为 true
bits := mask.ToBits()    // 0b10101010,每个通道占 1 位(通道 0 对应最低位)
由此便引出了 SIMD 版的分支控制语句。
掩码与混合(Blending):SIMD 世界的“if”
单个掩码本身并不能改变数据流。我们该如何使用它呢?
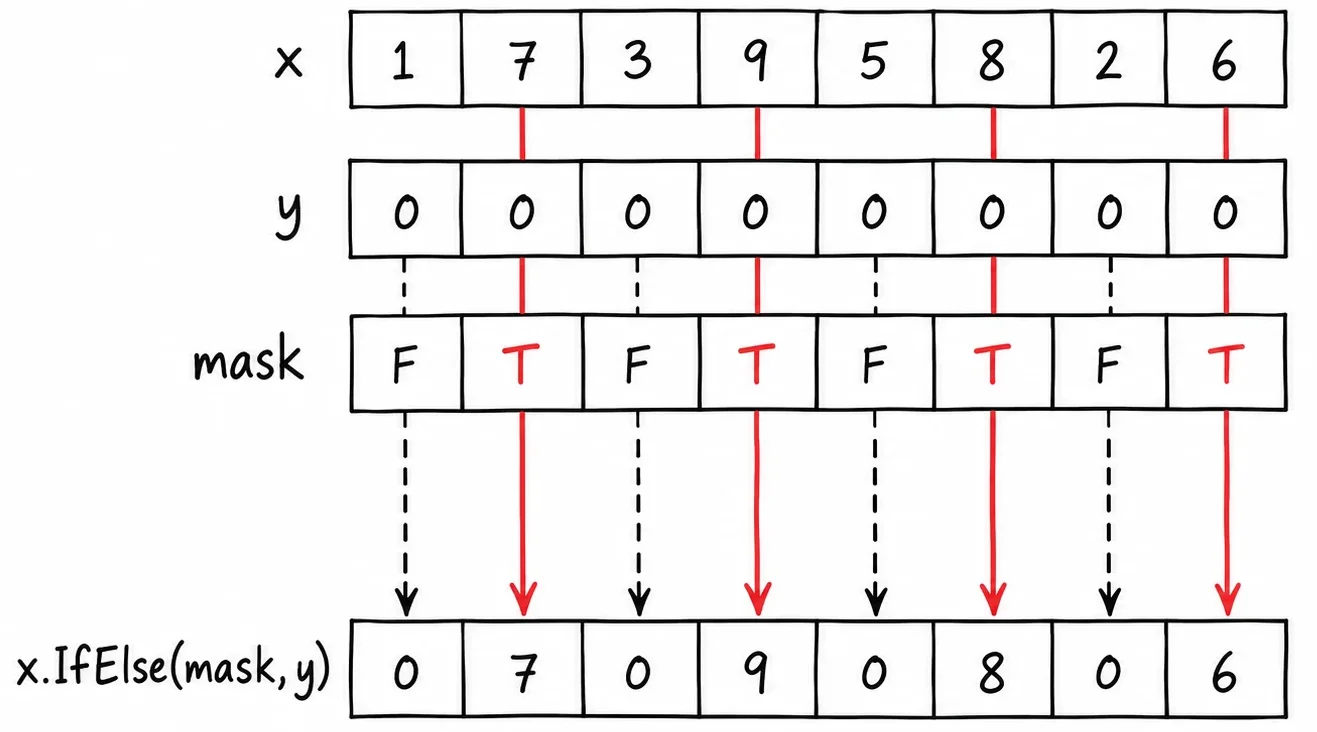
逐通道观察生成的结果:在掩码为 True 的通道上,值从 x 中获取;在掩码为 False 的通道上,值从 y 中获取。这就是混合(Blend),也是 SIMD 实现 if/else 分支的本质手段:所有通道同时算出两种可能的结果,然后依靠掩码在每个通道中二选一。与全 0 向量进行混合(如图中的 y)是极其高频的模式,它通常被称为掩码过滤(Masking):“保留满足条件的通道,将未通过条件的通道清零”。
x := archsimd.LoadFloat32x8([]float32{1, 7, 3, 9, 5, 8, 2, 6})
var y archsimd.Float32x8                                    // 所有通道均为 0
mask := x.Greater(archsimd.BroadcastFloat32x8(5))           // [F T F T F T F T]

r := x.IfElse(mask, y) // [0 7 0 9 0 8 0 6]
r = x.Masked(mask)     // 等价的简写形式
现在让我们先把算术运算放在一边,来看看如何在寄存器内部重排数据。
置换(Permutes):跨通道调换位置
前面的操作都严格保证通道 i 的数据只保留在通道 i 中。但有时数据虽然已经在同一个寄存器里,位置却不对,你需要对其进行反转或重排。
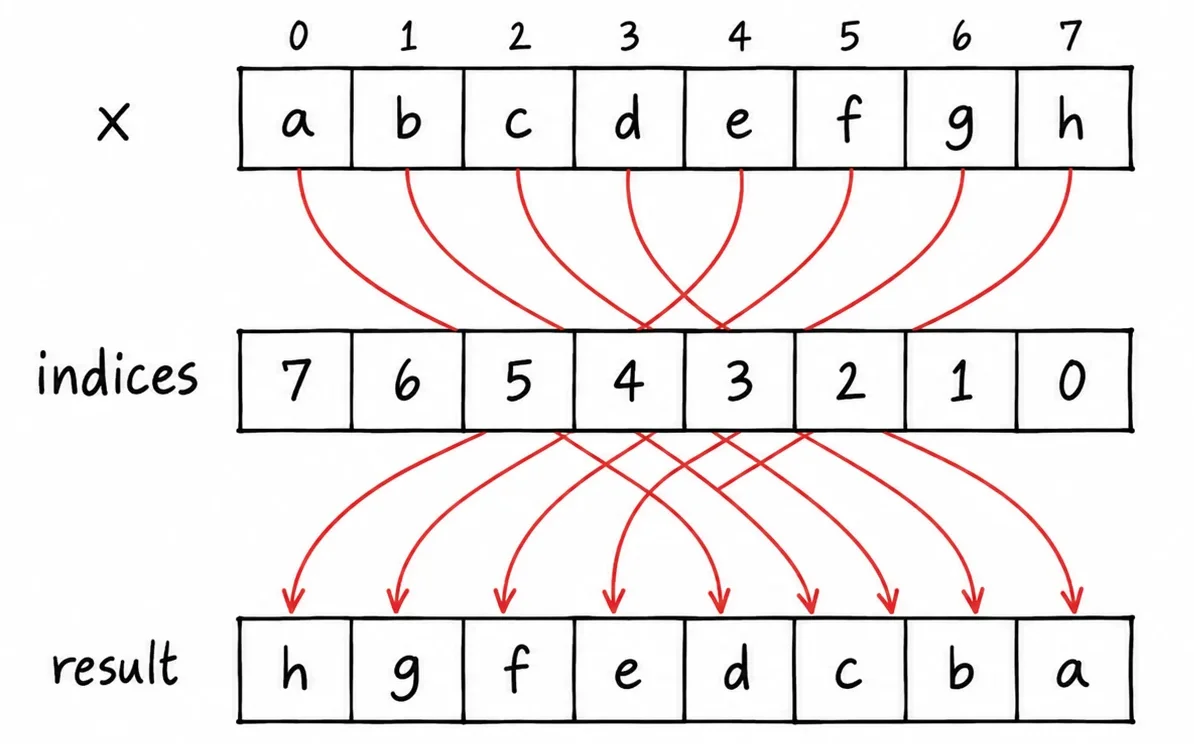
结果寄存器的每个通道都会根据索引数组的指示,复制输入向量 x 中指定通道的数据。结果通道 0 指定的索引是 7,因此取得 x 的通道 7(即 h);结果通道 1 指定的索引是 6,因此取得 g;以此类推,直到最后一个通道的索引为 0 并取得 a。这就是置换(Permute):底层数值并没有发生任何改变,索引数组决定了每个数值的去向。
本例展示的是向量翻转,但在实际中支持任意排列顺序,你甚至可以多次引用同一个通道的数据。这种灵活性正是诸如极速 JSON 解析器等前沿优化黑魔法的核心武器。
x := archsimd.LoadFloat32x8([]float32{1, 2, 3, 4, 5, 6, 7, 8})
idx := archsimd.LoadUint32x8([]uint32{7, 6, 5, 4, 3, 2, 1, 0})
r := x.Permute(idx) // 结果为 [8 7 6 5 4 3 2 1]
然而,仅仅重新排列通道并不能解决所有跨通道聚合的需求。
水平操作(Horizontal Operations):跨越通道的聚合
置换操作可以在通道之间移动数值,但每个值在输出时仍然独立占据一个通道。有时我们恰恰需要相反的效果:将同一个寄存器内的多个通道聚合起来,比如把各个通道的部分和相加得到一个全局总和。这就是水平操作(Horizontal Operation)。
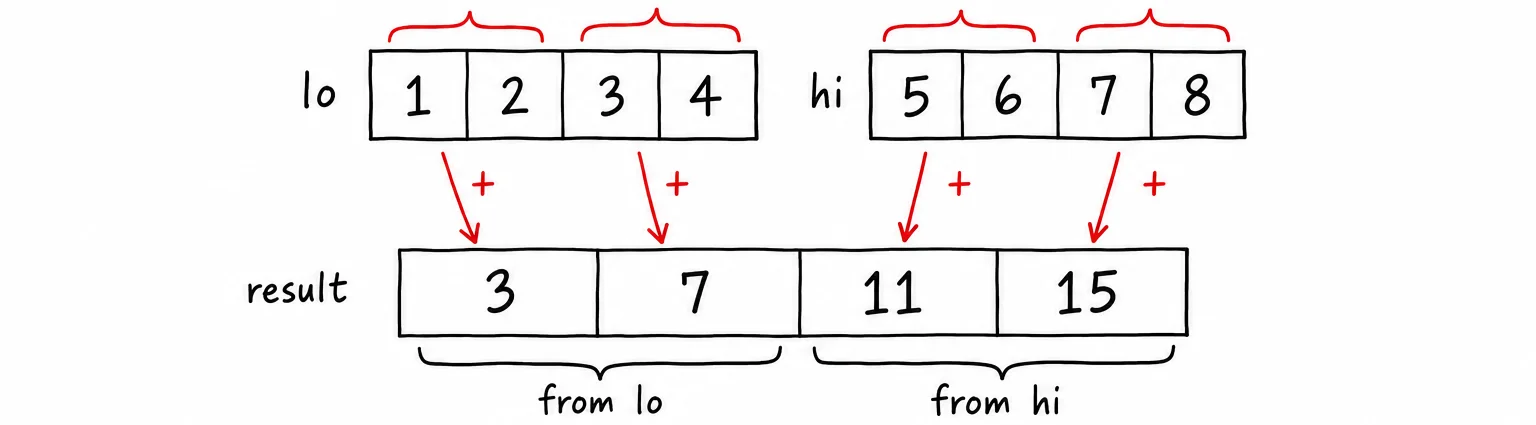
相邻成对的通道彼此相加:来自 x 的 1+2、3+4,紧接着是来自 y 的 5+6、7+8,得到的四个和值顺次放入结果寄存器中:[3 7 11 15]。这正是 ConcatAddPairs 的行为,x.ConcatAddPairs(y) 会产生 [x0+x1, x2+x3, y0+y1, y2+y3]。
x := archsimd.LoadFloat32x4([]float32{1, 2, 3, 4})
y := archsimd.LoadFloat32x4([]float32{5, 6, 7, 8})
r := x.ConcatAddPairs(y) // 结果为 [3 7 11 15]
最后,还有一个从我们初次执行加载时就一直被刻意搁置的问题。
尾部处理:部分加载(Partial Loads)
回到最初关于数据加载的残留问题:假设切片共有 10 个元素,而一个寄存器能容纳 8 个。在处理完第一个完整的块后,末尾还剩下 2 个元素。这个遗留在尾部的小切片被称为尾部(Tail)。
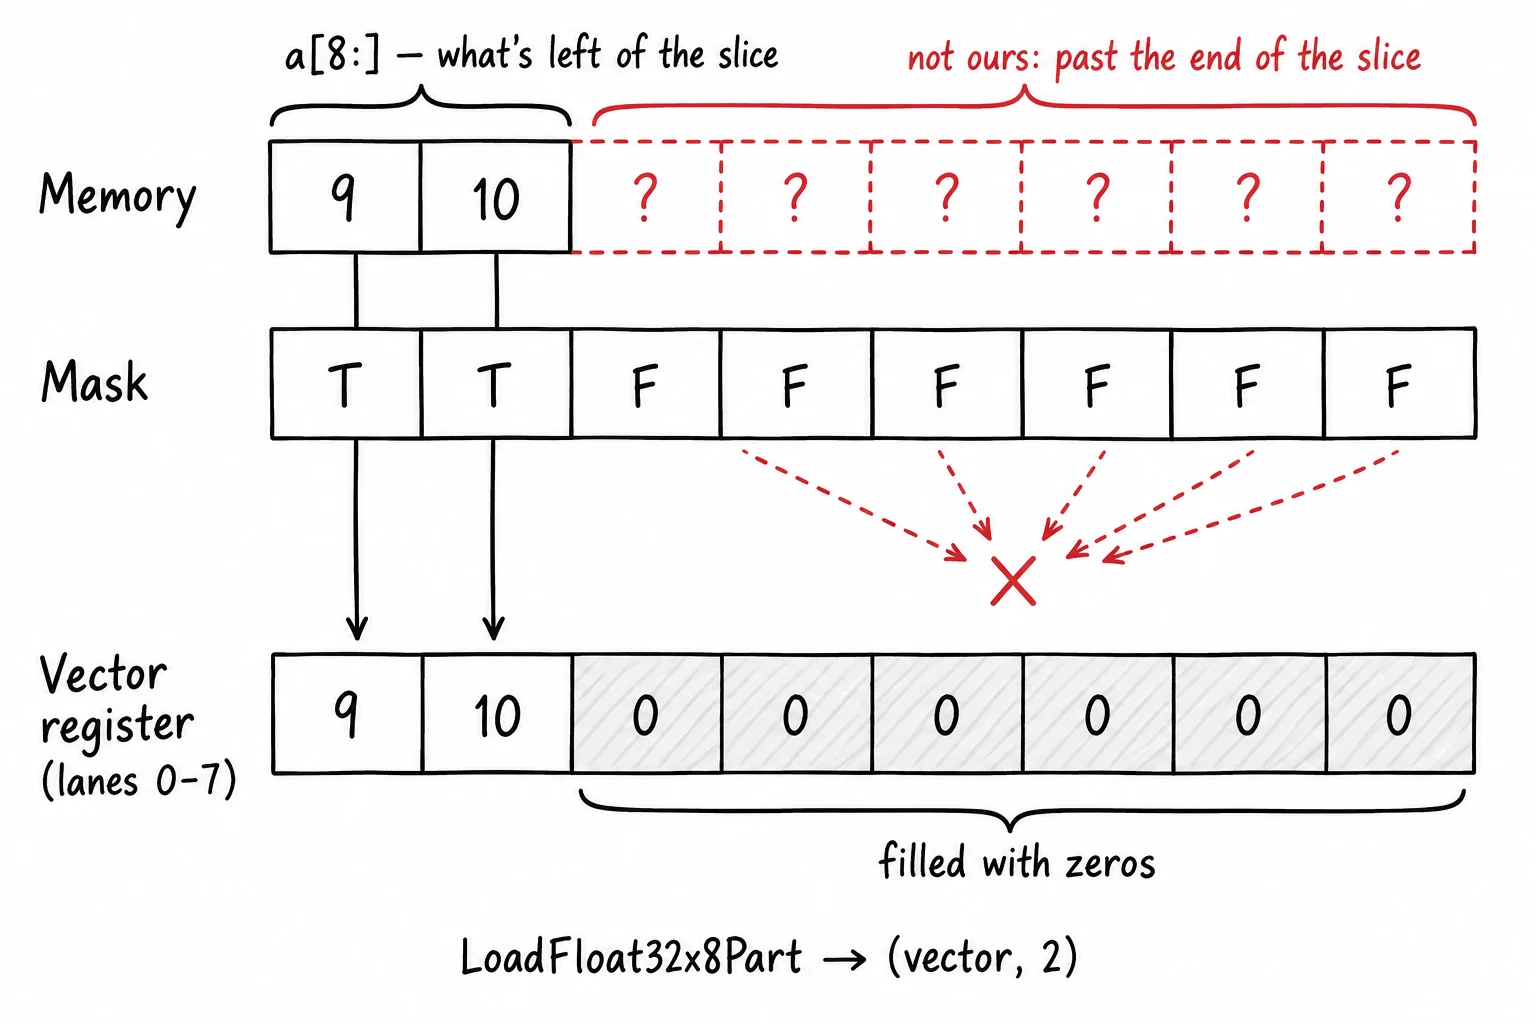
图中那些问号代表着潜藏的危险:切片末尾之后的那段内存并不属于我们,而一次普通的 8 通道加载指令无论如何都会强行读取它。部分加载(Partial Load)化解了这一隐患:它返回一个定制的寄存器,其中只有真正存在有效数据的通道包含你的值,其余无效通道全部自动补零。如果你接下来是要执行累加运算,零就是最理想的填充物,因为它完全不会干扰最终的累加和。
不过这里需要给出一个中肯的提醒:在 Go 1.27.0 的 amd64 实现中,底层实际上仍然会读取满 32 字节,并在随后将多余通道置零。虽然最终数据计算完全正确,但它确实隐式触碰了越界内存。好在这个问题在上游已经修复,在未来的更新版本中该缺陷将被彻底解决。
s := []float32{1, 2, 3, 4, 5, 6, 7, 8, 9, 10}
x, n := archsimd.LoadFloat32x8Part(s[8:]) // x = [9 10 0 0 0 0 0 0], n = 2
以上就是 SIMD 为我们准备的常用工具箱。现在是时候重新切回 Go 语言内部,探寻其运行机理了。
Go 编译器如何施展黑魔法?
自始至终,我们都在调用形如 x.Add(y) 的普通方法。但一个高级语言的方法调用,到底是如何脱胎换骨变成一条纯粹的单周期 CPU 指令的?通用的 simd 包在编译期完全不知道寄存器大小的情况下,又是如何正常工作的?让我们揭开编译器底层的黑盒。
archsimd:没有方法体的函数
如果你去翻看 Add 方法的定义源码,会发现一件极不寻常的事:func (x Float32x8) Add(y Float32x8) Float32x8,后面完全没有方法体。这是因为 Add 实际上是一个编译器内建函数(Compiler Intrinsic):编译器能够通过名字识别它,并直接在调用处将其替换为内联的机器指令,而绝非走传统的函数调用栈。
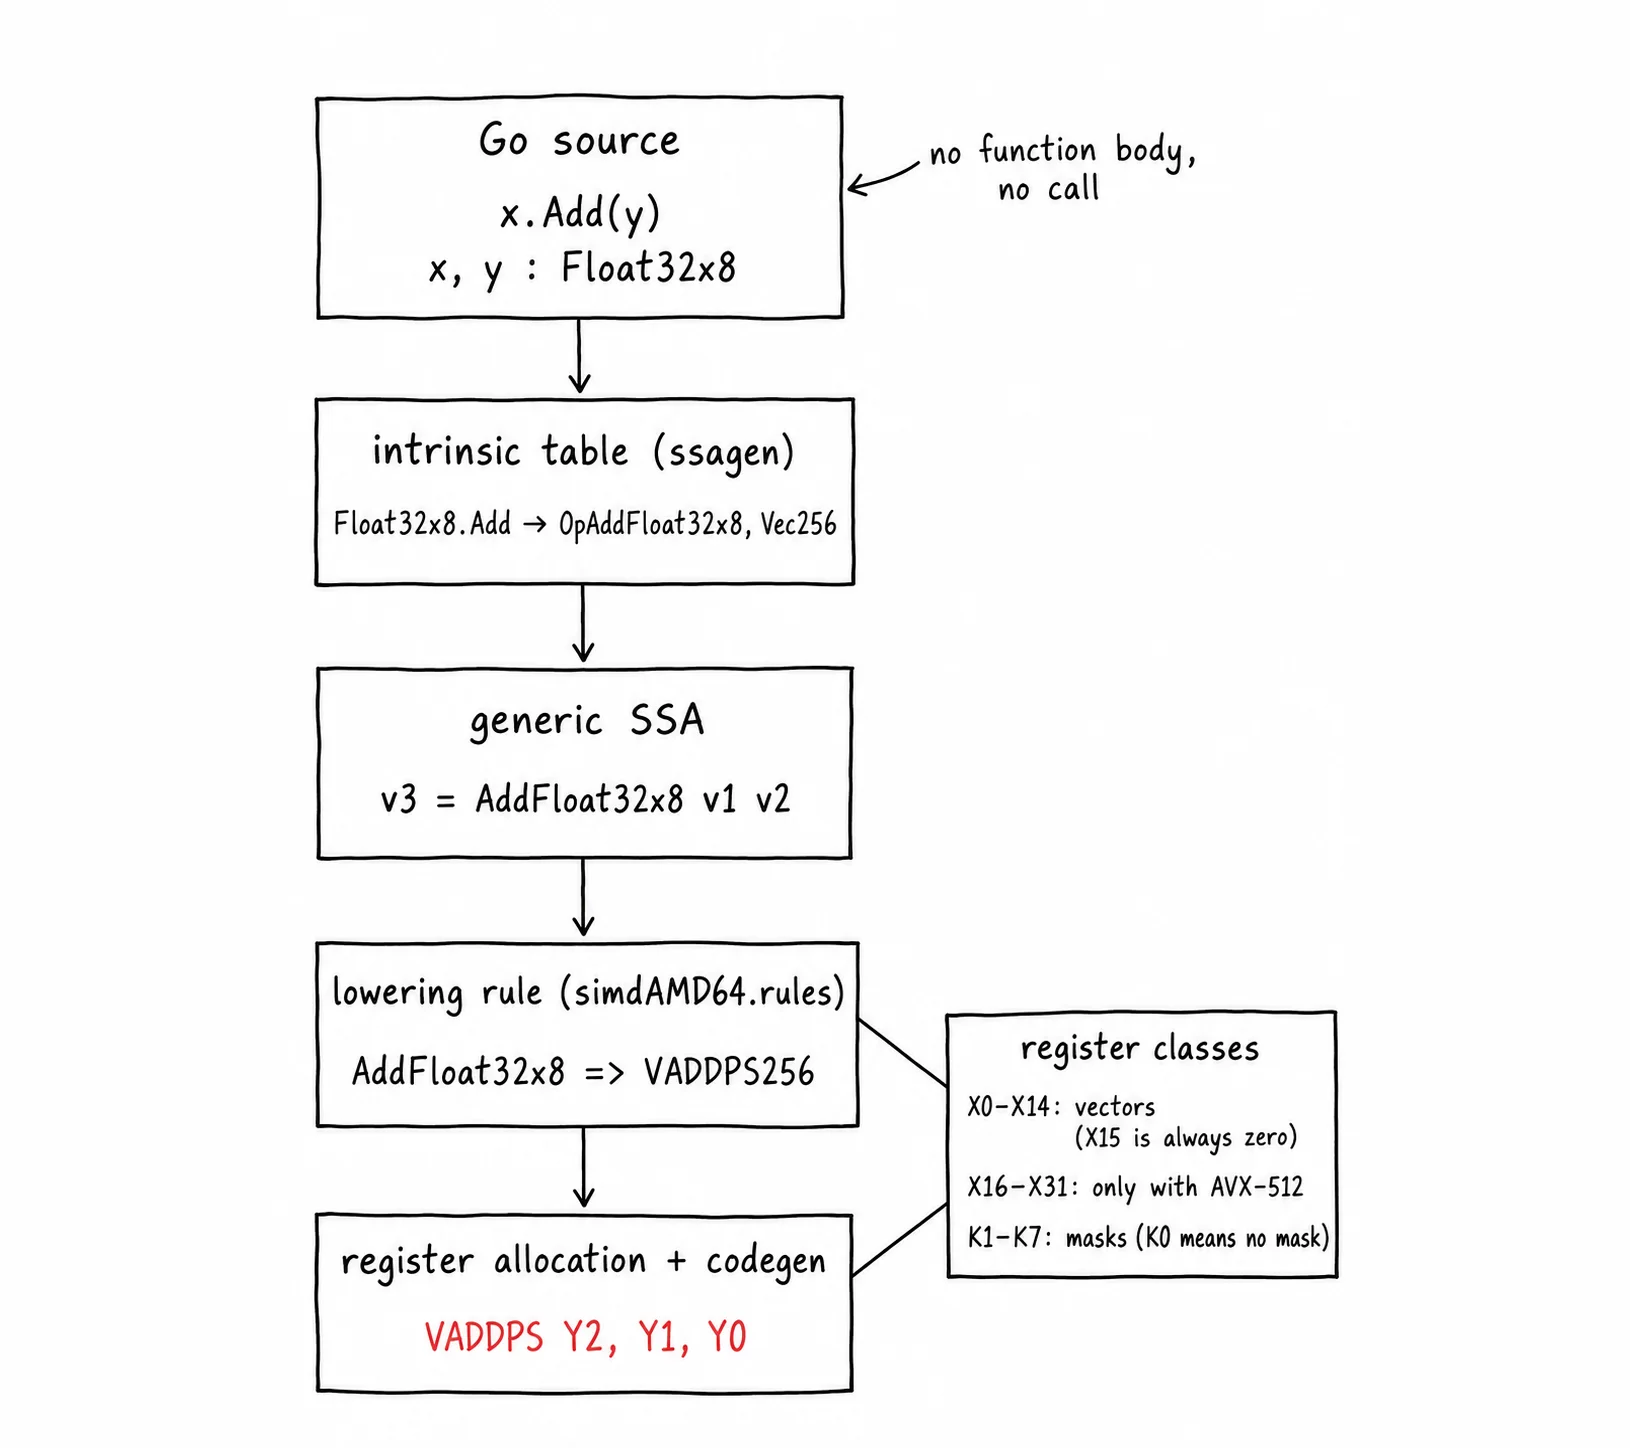
让我们顺着编译流水线一步步跟踪:首先,编译器在内建函数映射表(simdAMD64intrinsics.go:40)中命中 x.Add(y),并将其转化为一个 SSA(静态单赋值)操作。接着,一条重写规则将该 SSA 操作翻译成对应的 amd64 硬件指令 VADDPS(simdAMD64.rules:30),最后寄存器分配器为该指令分配具体的物理寄存器。一个看似普通的高级方法调用,就这样精准映射成了一条硬件指令。
数据类型同样享受着特殊待遇。Float32x8 是一个内部带有特殊标记字段的结构体(types_amd64.go),它会向编译器传达明确信号:“在整个生命周期中,必须将这个结构体整体保存在一个物理向量寄存器内”。
这种映射之所以能成功,是因为 archsimd 的尺寸直接固化在类型名称中。然而跨平台的通用 simd 包并没有这种便利条件。
simd:一套代码,多重编译
如果寄存器位宽只有在程序启动的那一刹那才能确定,编译器又该如何知道该生成哪些寄存器和指令呢?
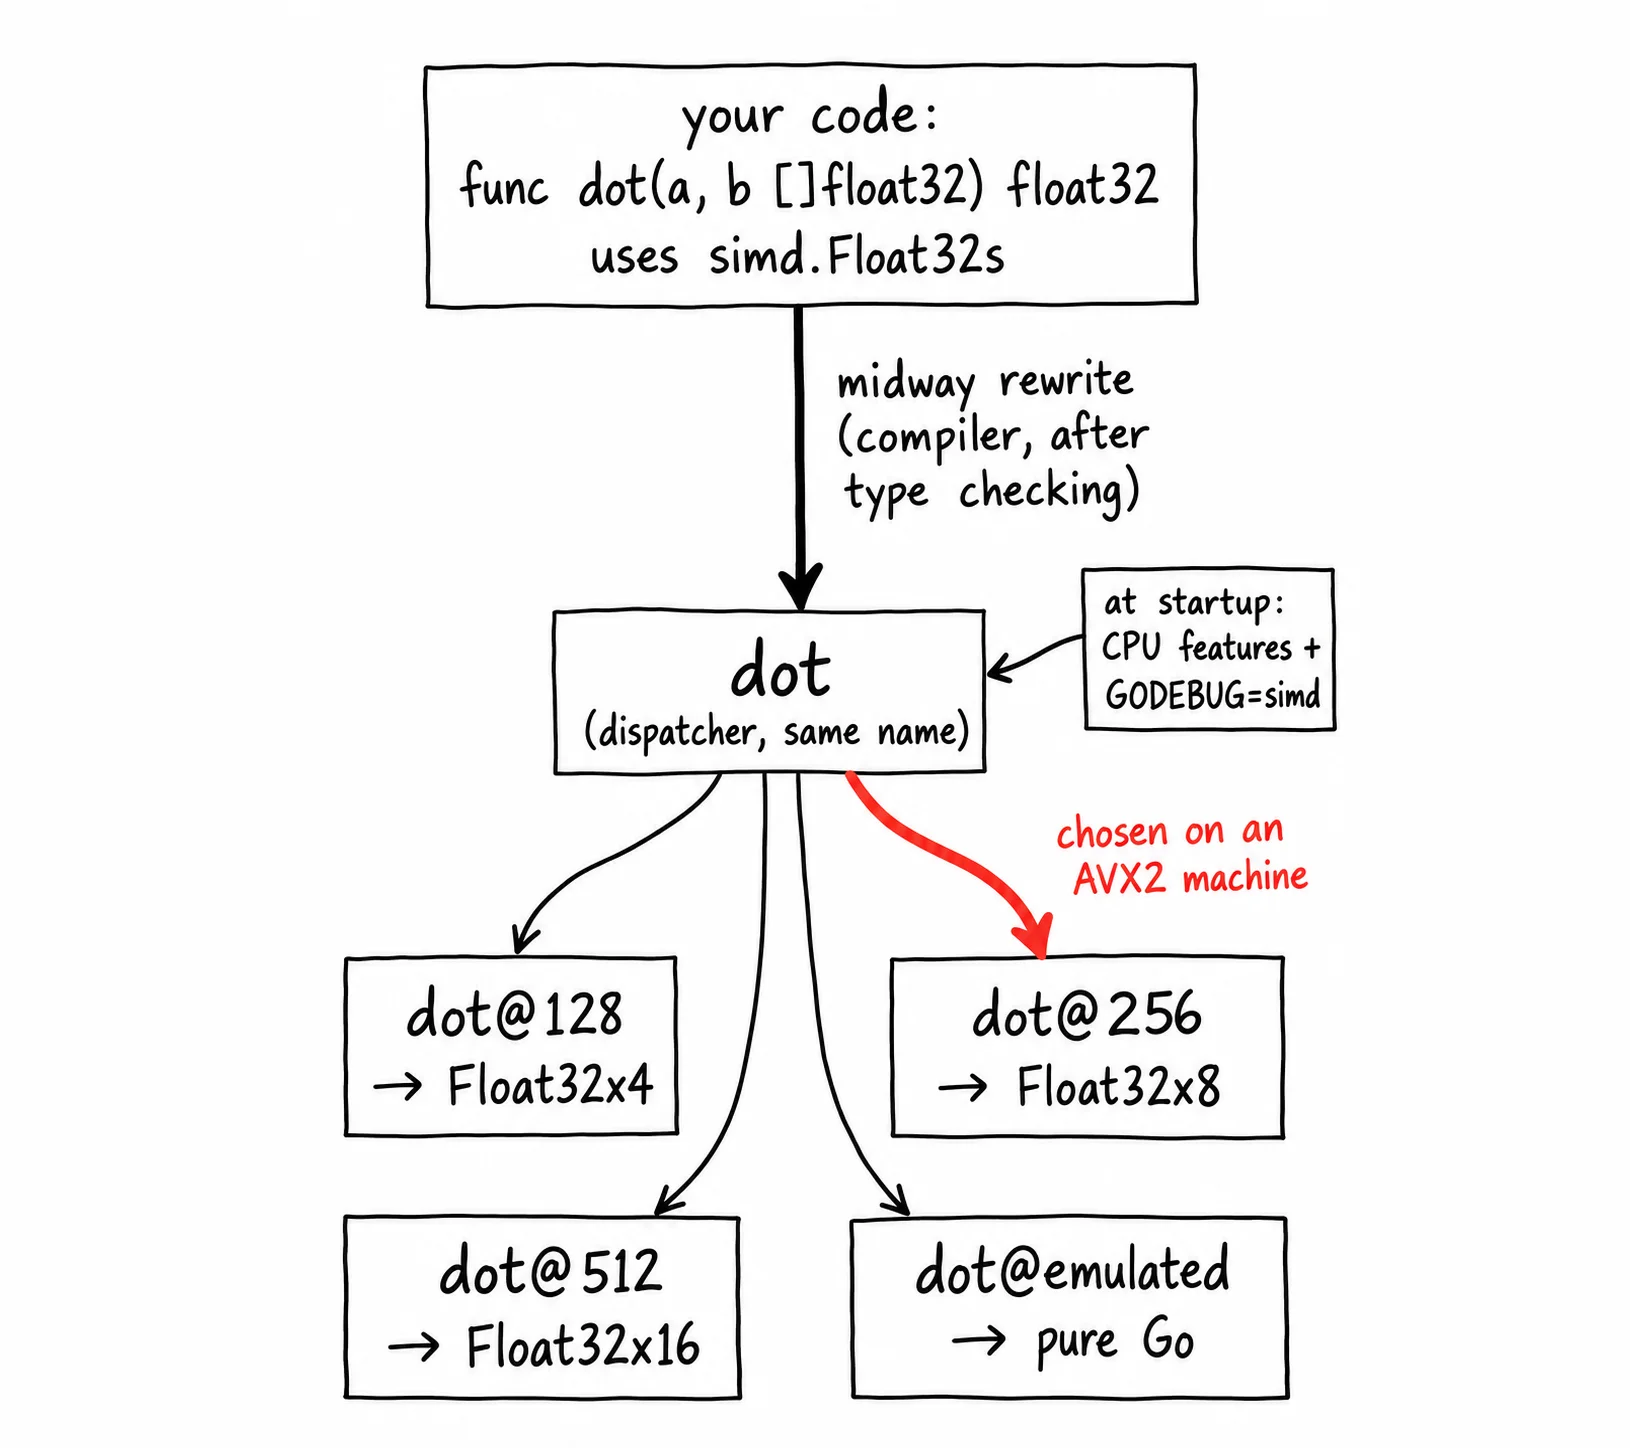
编译器索性不做单选题:它会将你的代码编译很多次。你只需编写一个使用 simd.Float32s 的标准 dot 函数。编译器中一个名为 midway 的中间处理阶段(rewrite.go)会自动为每种主流位宽生成对应的变体副本:dot@simd128、dot@simd256 和 dot@simd512,外加一个纯 Go 实现的回退版本 dot@simd0。同时,它还会生成一个轻量的分发入口,对外依然保留原有的 dot 函数名,因此你的上层业务代码无需任何改动。在程序启动时,Go 运行时会检测 CPU 支持的指令集特性,分发器据此将调用重定向至匹配度最高的副本——在支持 AVX2 的机器上,命中的正是 dot@simd256。
如果你想手动干预这个分发过程,可以通过环境变量自由控制:GODEBUG=simd=0 会强制使用纯 Go 回退版本,而 GODEBUG=simd=256(或 128、512)则强制锁定具体的位宽(midway_common.go:22)。以后如果你在排查 panic 堆栈追踪时看到类似 dot@simd256 这样的符号,就能立即心领神会它的由来了。
实战演练:端到端点积示例
现在基础知识已经齐备,我们可以顺着一条真实的案例,追踪从 Go 源代码到硅片执行的全过程了。我们以经典的点积(Dot Product)为例:将两个 []float32 切片逐元素相乘,并计算出所有积的总和。
从向量数据库的相似度搜索到深度学习推理,点积的身影无处不在,它几乎涵盖了我们前文讲过的所有概念。以下是完整的 archsimd 实现版本,短小精悍,可以直接使用 GOEXPERIMENT=simd go run . 在 Go 1.27 环境下运行:
package main

import (
	"fmt"
	"simd/archsimd"
)

func dotSIMD(a, b []float32) float32 {
	var acc archsimd.Float32x8 // 八个累加槽,初始全为 0
	i := 0
	for ; i+8 <= len(a); i += 8 {
		x := archsimd.LoadFloat32x8(a[i:])
		y := archsimd.LoadFloat32x8(b[i:])
		acc = x.MulAdd(y, acc) // acc = x*y + acc,逐通道并行
	}
	// 处理尾部:剩余元素不足 8 个,缺失的通道自动补 0
	x, _ := archsimd.LoadFloat32x8Part(a[i:])
	y, _ := archsimd.LoadFloat32x8Part(b[i:])
	acc = x.MulAdd(y, acc)

	// 折叠(Fold):将 8 个通道规约合并为单个数字
	s := acc.GetLo().Add(acc.GetHi()) // 8 个通道 -> 4 个
	s = s.ConcatAddPairs(s)           // 4 个 -> 2 个
	s = s.ConcatAddPairs(s)           // 2 个 -> 1 个
	return s.GetElem(0)
}

func main() {
	if !archsimd.X86.AVX2() || !archsimd.X86.FMA() {
		fmt.Println("当前 CPU 缺少 AVX2 或 FMA 指令集支持")
		return
	}
	a := []float32{1, 2, 3, 4, 5, 6, 7, 8, 9, 10}
	b := []float32{10, 9, 8, 7, 6, 5, 4, 3, 2, 1}
	fmt.Println(dotSIMD(a, b)) // 输出 220
}
让我们逐步拆解运行逻辑。main 函数首先检查 CPU 是否支持 AVX2 和 FMA 指令集,因为底层的 archsimd 不会自动替你做防呆保护:如果 CPU 缺乏某条硬件指令,执行时不会回退到慢速方案,而是直接抛出非法指令错误导致程序崩溃。随后,acc 初始化为一个全零向量,我们带着 10 个元素的切片进入计算流程。
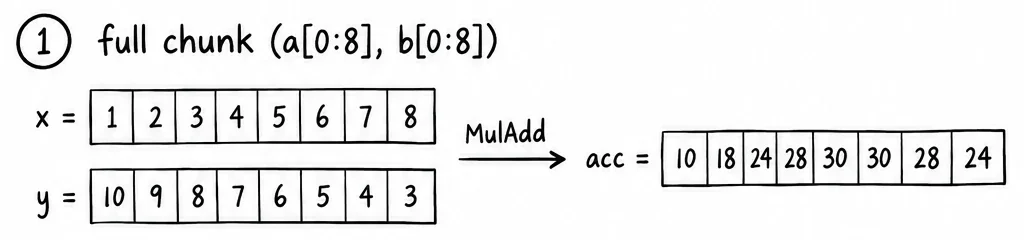
阶段 1:完整数据块处理。
由于 i+8 <= 10 成立,我们分别通过单次加载指令将 a[0:8] 和 b[0:8] 灌入两个向量寄存器。MulAdd 将它们逐通道相乘并加上 acc(当前全为 0),因此 acc 变为这八组数字的乘积:[10 18 24 28 30 30 28 24]。进入下一轮迭代时,i 变成 8,16 <= 10 条件不满足,主循环正常退出。
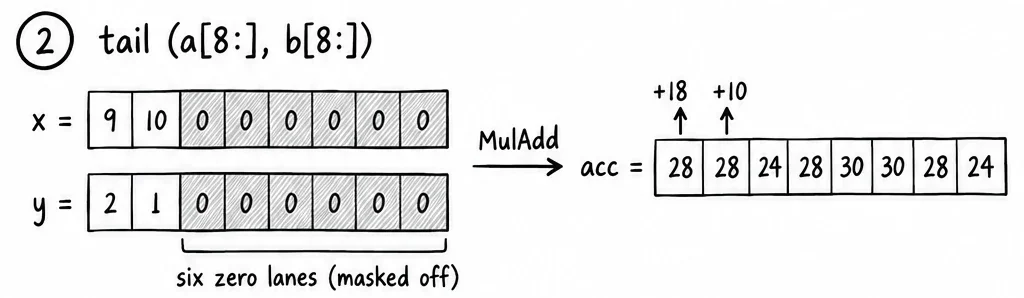
阶段 2:尾部数据处理。
此时还剩下最后两个元素。LoadFloat32x8Part 将 9 和 10 分别读入通道 0 和通道 1,其他六个通道自动补 0(切片 b 同理)。再执行一次 MulAdd:通道 0 获得 9*2 = 18 的增量,通道 1 获得 10*1 = 10 的增量,补零的通道加 0 不变。此时 acc 的内容更新为 [28 28 24 28 30 30 28 24]。
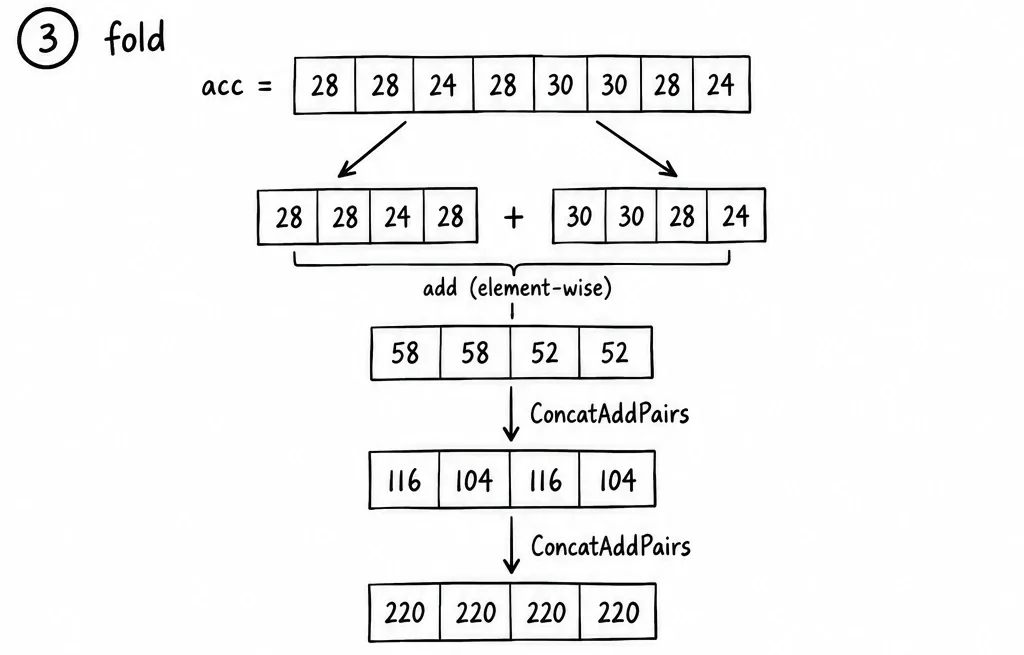
阶段 3:多级折叠(Fold)。
此时 acc 的八个通道各自持有局部的累加和,而我们最终的目标是将这八个数字求和为一个全局标量。我们当然可以把它们一个个提取出来再相加,但那意味着需要执行七次串行的常规加法。相反,我们让 SIMD 大步流星地解决问题:每次将元素数量减半。加法结合律保证了这一做法的正确性:1 + 2 + 3 + 4 与 (1 + 3) + (2 + 4) 的数学结果完全相同。
首先,我们将寄存器横向对半切开。GetLo 提取前四个通道 [28 28 24 28],GetHi 提取后四个通道 [30 30 28 24]。接着,我们将这两半像普通的垂直向量那样逐通道相加,得到 [58 58 52 52]。数据没有任何丢失:58 就是 28 + 30 的和,这四个新数字的总和与最初八个通道的数据总和完全一致。
随后,ConcatAddPairs 让相邻通道成对相加:58 + 58 = 116,52 + 52 = 104。由于此时我们手头只有一个寄存器,因此把 s 同时传给了两个入参,这也是为什么输出向量会重复显示两遍:[116 104 116 104]。重复的数据没有任何危害,直接忽略即可。现在整个数组的和已经规约到了仅存的两个数字:116 和 104。最后再执行一次 ConcatAddPairs 将它们合二为一,每个通道中就都装满了最终结果 220。
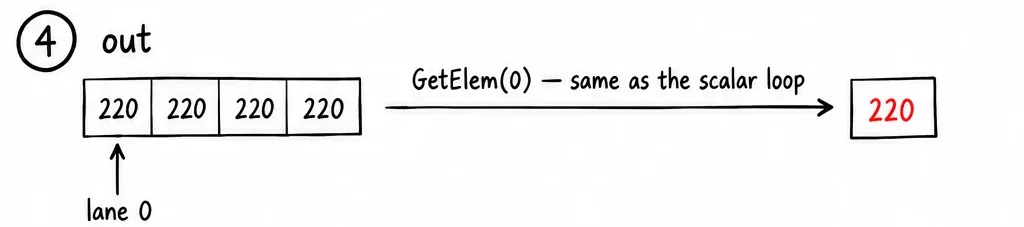
阶段 4:输出。GetElem(0) 将通道 0 的数值提取回普通的 float32 标量变量中:得到结果 220,与传统的标量循环输出完全一致。
最令人赞叹的部分在于底层生成的汇编。如果你构建该程序并使用 go tool objdump 反汇编 dotSIMD 函数,会发现核心循环体内部正如我们的推导图所预示的那样,被精准编译成了三条极简的硬件指令——两次加载和一次融合乘加:
VMOVQQU 0(DX), Y2
VMOVQQU 0(R11), Y3
VFMADD213PS Y1, Y3, Y2
而在函数的收尾折叠部分,同样是一对一的硬件指令转换:两条针对 GetLo / GetHi 的 VEXTRACTF128,一条 VADDPS,两条 VHADDPS,以及一条将通道 0 提取出来的 VPEXTRD。全程没有任何多余的函数调用开销,没有任何内存逃逸与堆分配,数据在整个生命周期中从未离开过物理向量寄存器半步。
在性能测试中,传统的标量循环耗时约 3.9 μs,而该 SIMD 版本仅耗时约 0.41 μs,获得了近乎 9 倍的性能飞跃。但天下没有免费的午餐:标量版本是任何人都能一眼看懂的微型循环;而 SIMD 版本充斥着尾部对齐、多级折叠以及宿主 CPU 指令集特性探测,理解和长期维护成本要高得多。而且性能收益的高低严重依赖具体问题:长且内存连续的切片点积运算几乎是 SIMD 的绝对主场;而对于充满大量条件分支、稀疏非连续内存访问或输入数据规模极小的场景,SIMD 能带来的提升微乎其微,甚至可能适得其反。
因此,务必以实际基准测试为准,把 SIMD 留给真正需要榨干性能的核心热点循环。
全文总结
回顾本文的核心脉络:
SIMD 允许一条指令同时对多个数据执行相同的操作,它依托于被划分成若干通道(Lanes)的宽向量寄存器(视 CPU 而定,位宽为 128、256 或 512 位)。
几乎所有的 SIMD 循环都遵循相同的工作范式:将数据加载到寄存器中、逐通道执行数学运算、将结果存储回内存(或提取出单个标量)。而诸如广播(Broadcast)、融合乘加(FMA)、掩码(Masks)、混合(Blends)、置换(Permutes)、**水平加法(Horizontal Adds)和部分加载(Partial Loads)**等扩展工具,共同构筑了解决复杂现实计算需求的基础设施。
在 Go 语言生态中,simd/archsimd 实现了对硬件几乎一对一的直接映射:Float32x8 直指拥有八个 float32 通道的物理寄存器,Add 等方法作为**编译器内建函数(Intrinsics)**会被直接内联翻译成单条汇编指令,但前置检测 CPU 指令集支持的责任落在了开发者身上;而便携式的 simd 包则通过编译器机制为不同位宽自动生成多份代码副本,并在程序启动时智能分发。
在实测中,我们的点积实现跑出了纯标量版本近 9 倍的吞吐量。但这套极速方案伴随着可读性与维护性的双重妥协,且最终收益与计算场景的数据形态高度相关。先度量,后优化,把它用在真正产生性能瓶颈的热点代码上。
虽然目前这套基础设施仍处于实验阶段,具体的 API 命名在未来可能微调,但底层支撑的体系结构设计是永恒的。一旦你在脑海中建立了清晰的数据通道图景,阅读和编写 Go 的 SIMD 代码就会变得游刃有余。
在下一篇文章中,我们将探讨另一种无需推翻重写代码即可提升 Go 程序性能的前沿利器:基于性能剖析的优化(Profile-Guided Optimization,简称 PGO)。我们将深入探究如何将真实生产环境中的 CPU Profile 投喂给编译器,以及编译器如何依据该画像做出更激进的深度内联和虚函数接口去动态化决策。
原文地址:https://internals-for-interns.com/posts/go-simd/
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。
