本文永久链接 – https://tonybai.com/2026/10/14/anthropic-scion-replaces-git-agent-scale-source-control
大家好,我是Tony Bai。
【导读】
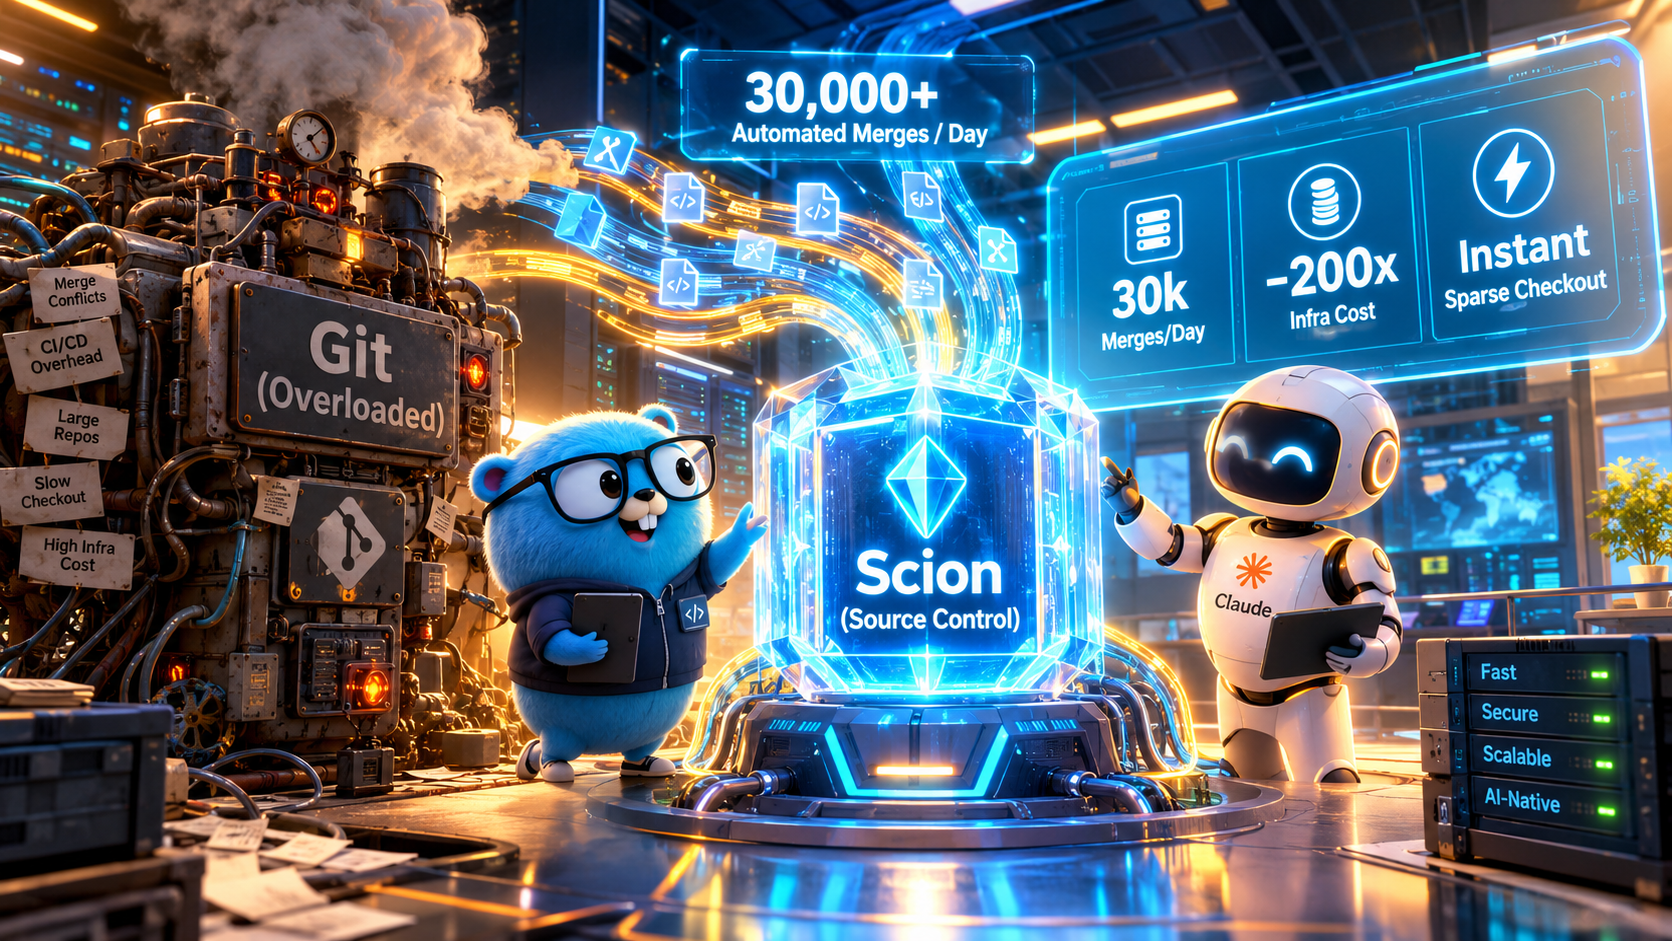
当 AI 写代码的速度远超人类,真正的瓶颈在哪?Anthropic 给出了一个出人意料的答案:不是模型,而是 Git。2026 年 5 月,Anthropic 每天合并约 2500 次代码变更,到 9 月,这个数字变成了 3 万次以上。Git 在这样的负载面前彻底“过载”,Anthropic 干脆用 5 个月时间,由 7 人小团队造出了全新的版本控制系统 Scion,并完成了整个 monorepo 的迁移。更讽刺的是,Scion 本身,大部分也是 Claude 写的。
【文章要点】
- 瓶颈已经转移:写代码不再慢,慢的是为人类规模设计的基础设施,包括版本控制、构建和 CI。
- Git 的“去中心化、离线可用”设计,在“客户端永远在线”的智能体时代,反而成了负担。
- Scion 的核心思路:服务端承担计算,客户端极瘦;一切数据内容寻址、可缓存;提交在服务端完成、无锁;工作副本可选且稀疏。
- 效果:基础设施的 CPU 和内存需求缩小到原来的 1/200,检出速度快两个数量级,CI 节省 25% CPU。
- Claude 重写 Scion 的摄取管线:内存降低 20 倍,速度提升 4 倍。
- 工程师的角色从“写代码”变成“定设计、说不”,而且合并队列这类人类时代的流程,在智能体规模下需要重新思考。
- Anthropic 明确表示:Scion 不是 Git 的通用替代品,也不打算开源,但希望把经验反哺给 Git 生态。
一天 3 万次合并,Git 先崩了
先看一组数字。
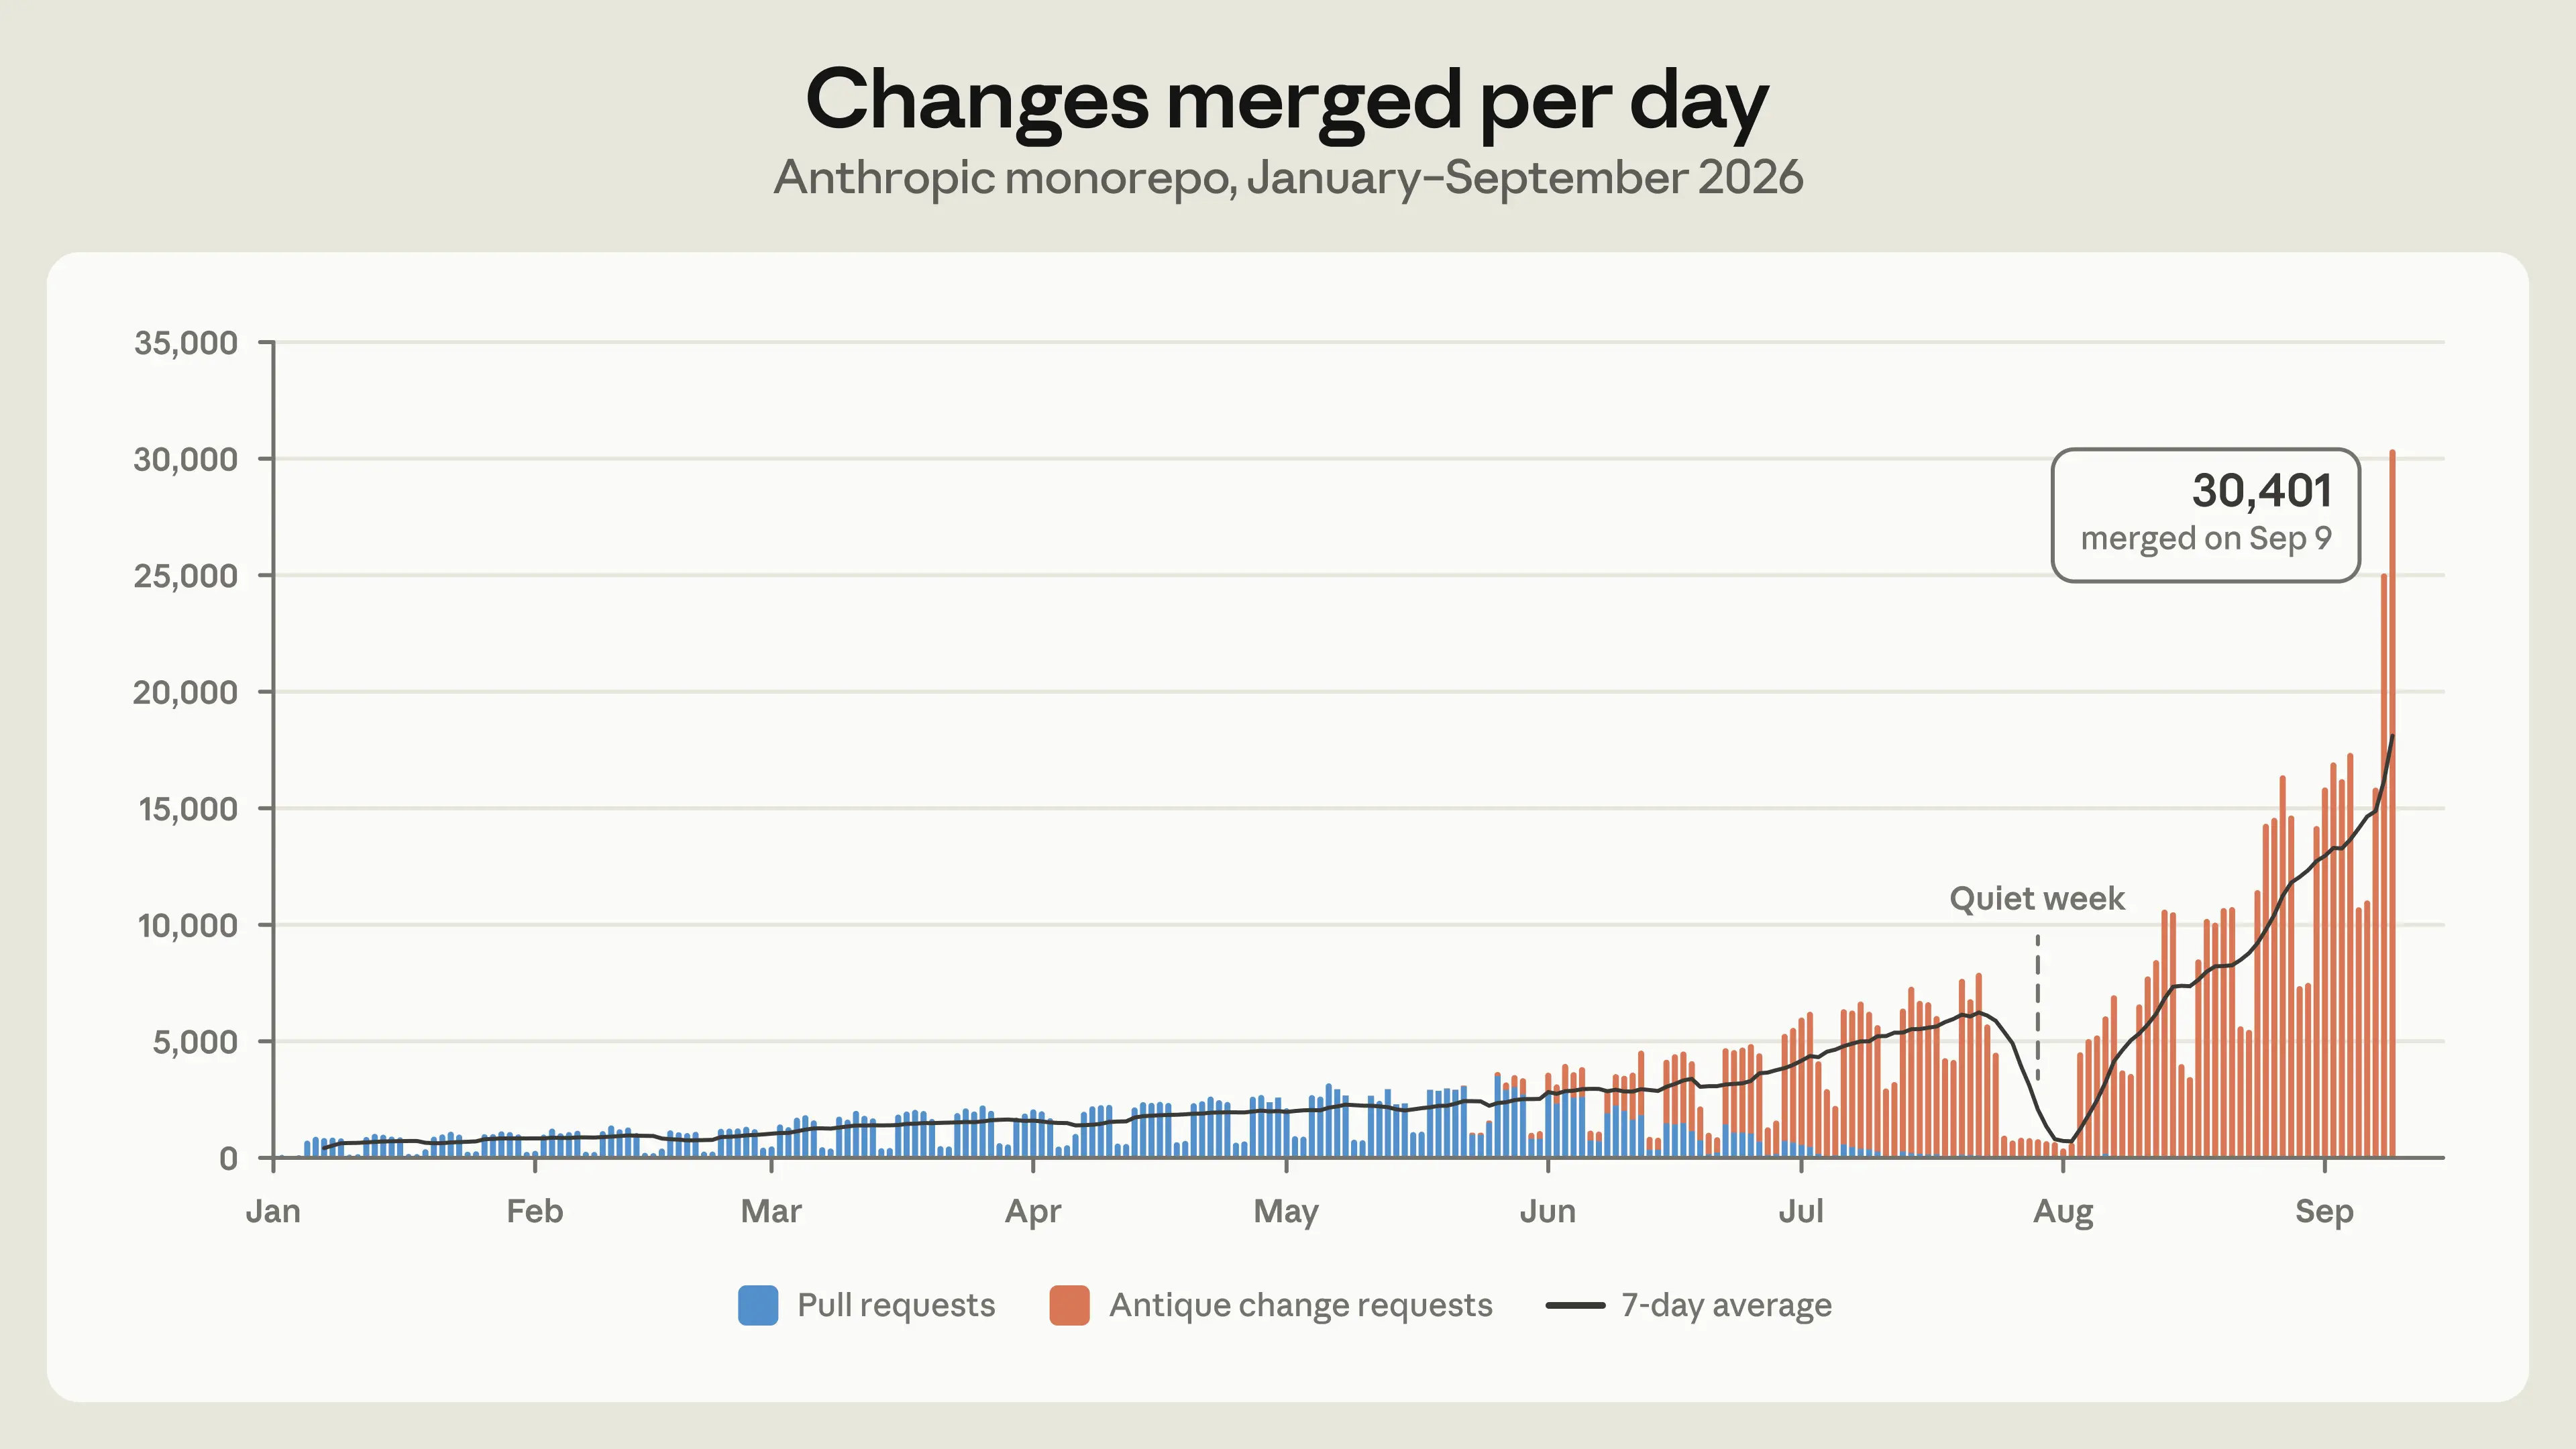
2026 年 5 月,Anthropic 平均每天合并约 2,500 个代码变更。
到了 9 月,这个数字变成了 30,000 以上。
四个月,涨了十几倍。
这就是 Anthropic 内部的日常:Claude 可以自主迭代研究循环、微调复杂程序,从零搭建新服务。官方在博客里写下了一句分量很重的话:
在 Anthropic,写代码已经不再是构建系统或做研究的瓶颈。
那瓶颈是什么?是所有为“人类规模”设计的开发者基础设施:版本控制、构建、CI。
于是,Anthropic 做了一件听起来很疯狂的事:自研了一套版本控制系统 Scion,并在 5 个月内,把整个 monorepo 从 Git 迁移了过去。
Git 为什么扛不住?
先说明一点:Git 本身并没有错。
Git 是去中心化系统,每份克隆都是完整的仓库,离线也能查历史、算 diff、切版本。对绝大多数仓库来说,这是最优设计,也是 Git 成为行业标准的原因。
但在 Anthropic 的 monorepo 面前,这套设计撞墙了:
- 主分支历史接近 100 GB
- 压缩后的工作副本超过 25 GB
- 每天为 CI 做约 2,500 万次代码检出(还不含开发环境、智能体沙箱和研究任务)
我们来验算一下:25 GB × 2500 万次 ≈ 625 PB。原文说“如果朴素地拉取,每天会产生超过 600 PB 的 Git 流量”,数字对得上。
Git 当然提供了浅克隆、稀疏检出、promisor remote 等工具,行业里也有内部镜像、仓库快照(seed)等常规手段。Anthropic 全都用过,巅峰时期运营着数百个内部 Git 镜像。
但这些办法只是“续命”:
- 合并速度越快,快照距离主干最新状态就越远
- 在部分克隆上维持 diff、blame 等依赖历史的操作,越来越费劲
- 镜像的磁盘和内存终究会被仓库撑爆
团队后来意识到一个关键事实:
他们把 Git 当成中心化系统在用(只有一份权威副本),而几乎所有客户端,都是“永远在线”的智能体和任务。
Git 最引以为傲的“离线、分布式”,反而成了扩展的绊脚石。
于是他们问了一个问题:如果从一开始就默认“客户端永远在线”,源码管理应该长什么样?
Scion 的六条设计原则
答案就是 Scion。它的设计有六条原则,条条都和 Git 反着来:
1. 客户端永远在线。
不再要求客户端保存完整仓库,需要什么数据,现取什么。
2. 客户端与服务端不对称。
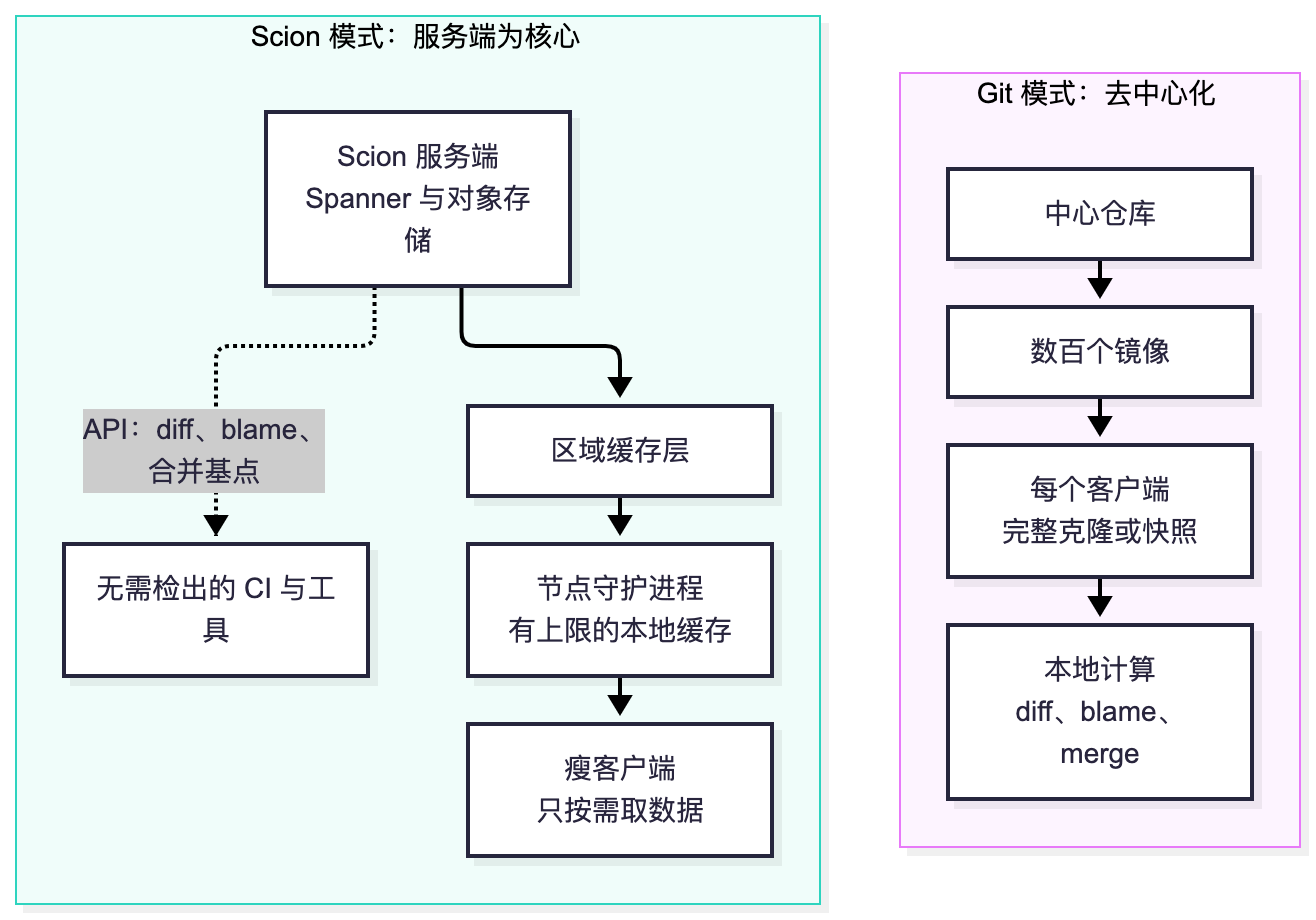
在 Git 里,每个客户端都能当服务器。在 Scion 里,历史查询、blame、创建提交、合并、变基,全部由服务端完成。客户端只维护一个有上限的本地对象缓存、铺设工作副本、监听文件系统变化,自己几乎算不了什么,但需要的数据也极少。
3. 完整的源码服务,可以支撑大量新应用。
客户端用到的所有查询,同时通过 API 暴露。很多 CI 任务甚至不需要本地仓库。Anthropic 的自动二分定位(bisect)和自动回滚流水线,就依赖这种廉价的程序化访问。
4. 一切必须水平扩展。
Scion 的数据是分布式存储的,整个系统里,包括服务端,都不存在一份完整物化的仓库。没有 packfile,也就不需要仓库维护。
5. 提交必须廉价、增量、无锁。
在 Scion 里,提交、变基、合并全在服务端发生,根本没有 push 这回事。创建提交的成本只跟改动大小有关,跟仓库总量无关。开发流程也不鼓励使用分支和标签,因为需要所有服务器达成一致的全局状态,是扩展性的隐患。
6. 工作副本是可选的,且天生稀疏。
CI 任务如果只想知道某次提交和合并基点的 diff,直接问服务器就行,不用检出。真要检出,也只拉取必要的目录,甚至按需“虚拟化”文件。
用一张图对比一下两者的思路:
拆开看:Scion 是怎么运转的
数据结构:变更集 + 派生数据
Scion 的基本单位叫“变更集”(changeset),是一个写前日志(write-ahead log)中的条目。
和 Git 提交不同:Git 的 commit 存的是指向目录树的指针,而变更集存的是相对于第一个父节点发生变化的文件列表,外加指向 blob 存储的内容寻址指针。变更集在服务端创建,创建完立刻全局可用。
好处很直接:没有 packfile 要接收,没有锁,没有跨服务器协调,也没有 ref 要移动;即便要移动,也只是 Spanner 中某一行的一次 compare-and-swap,并且与创建变更集是分开的。
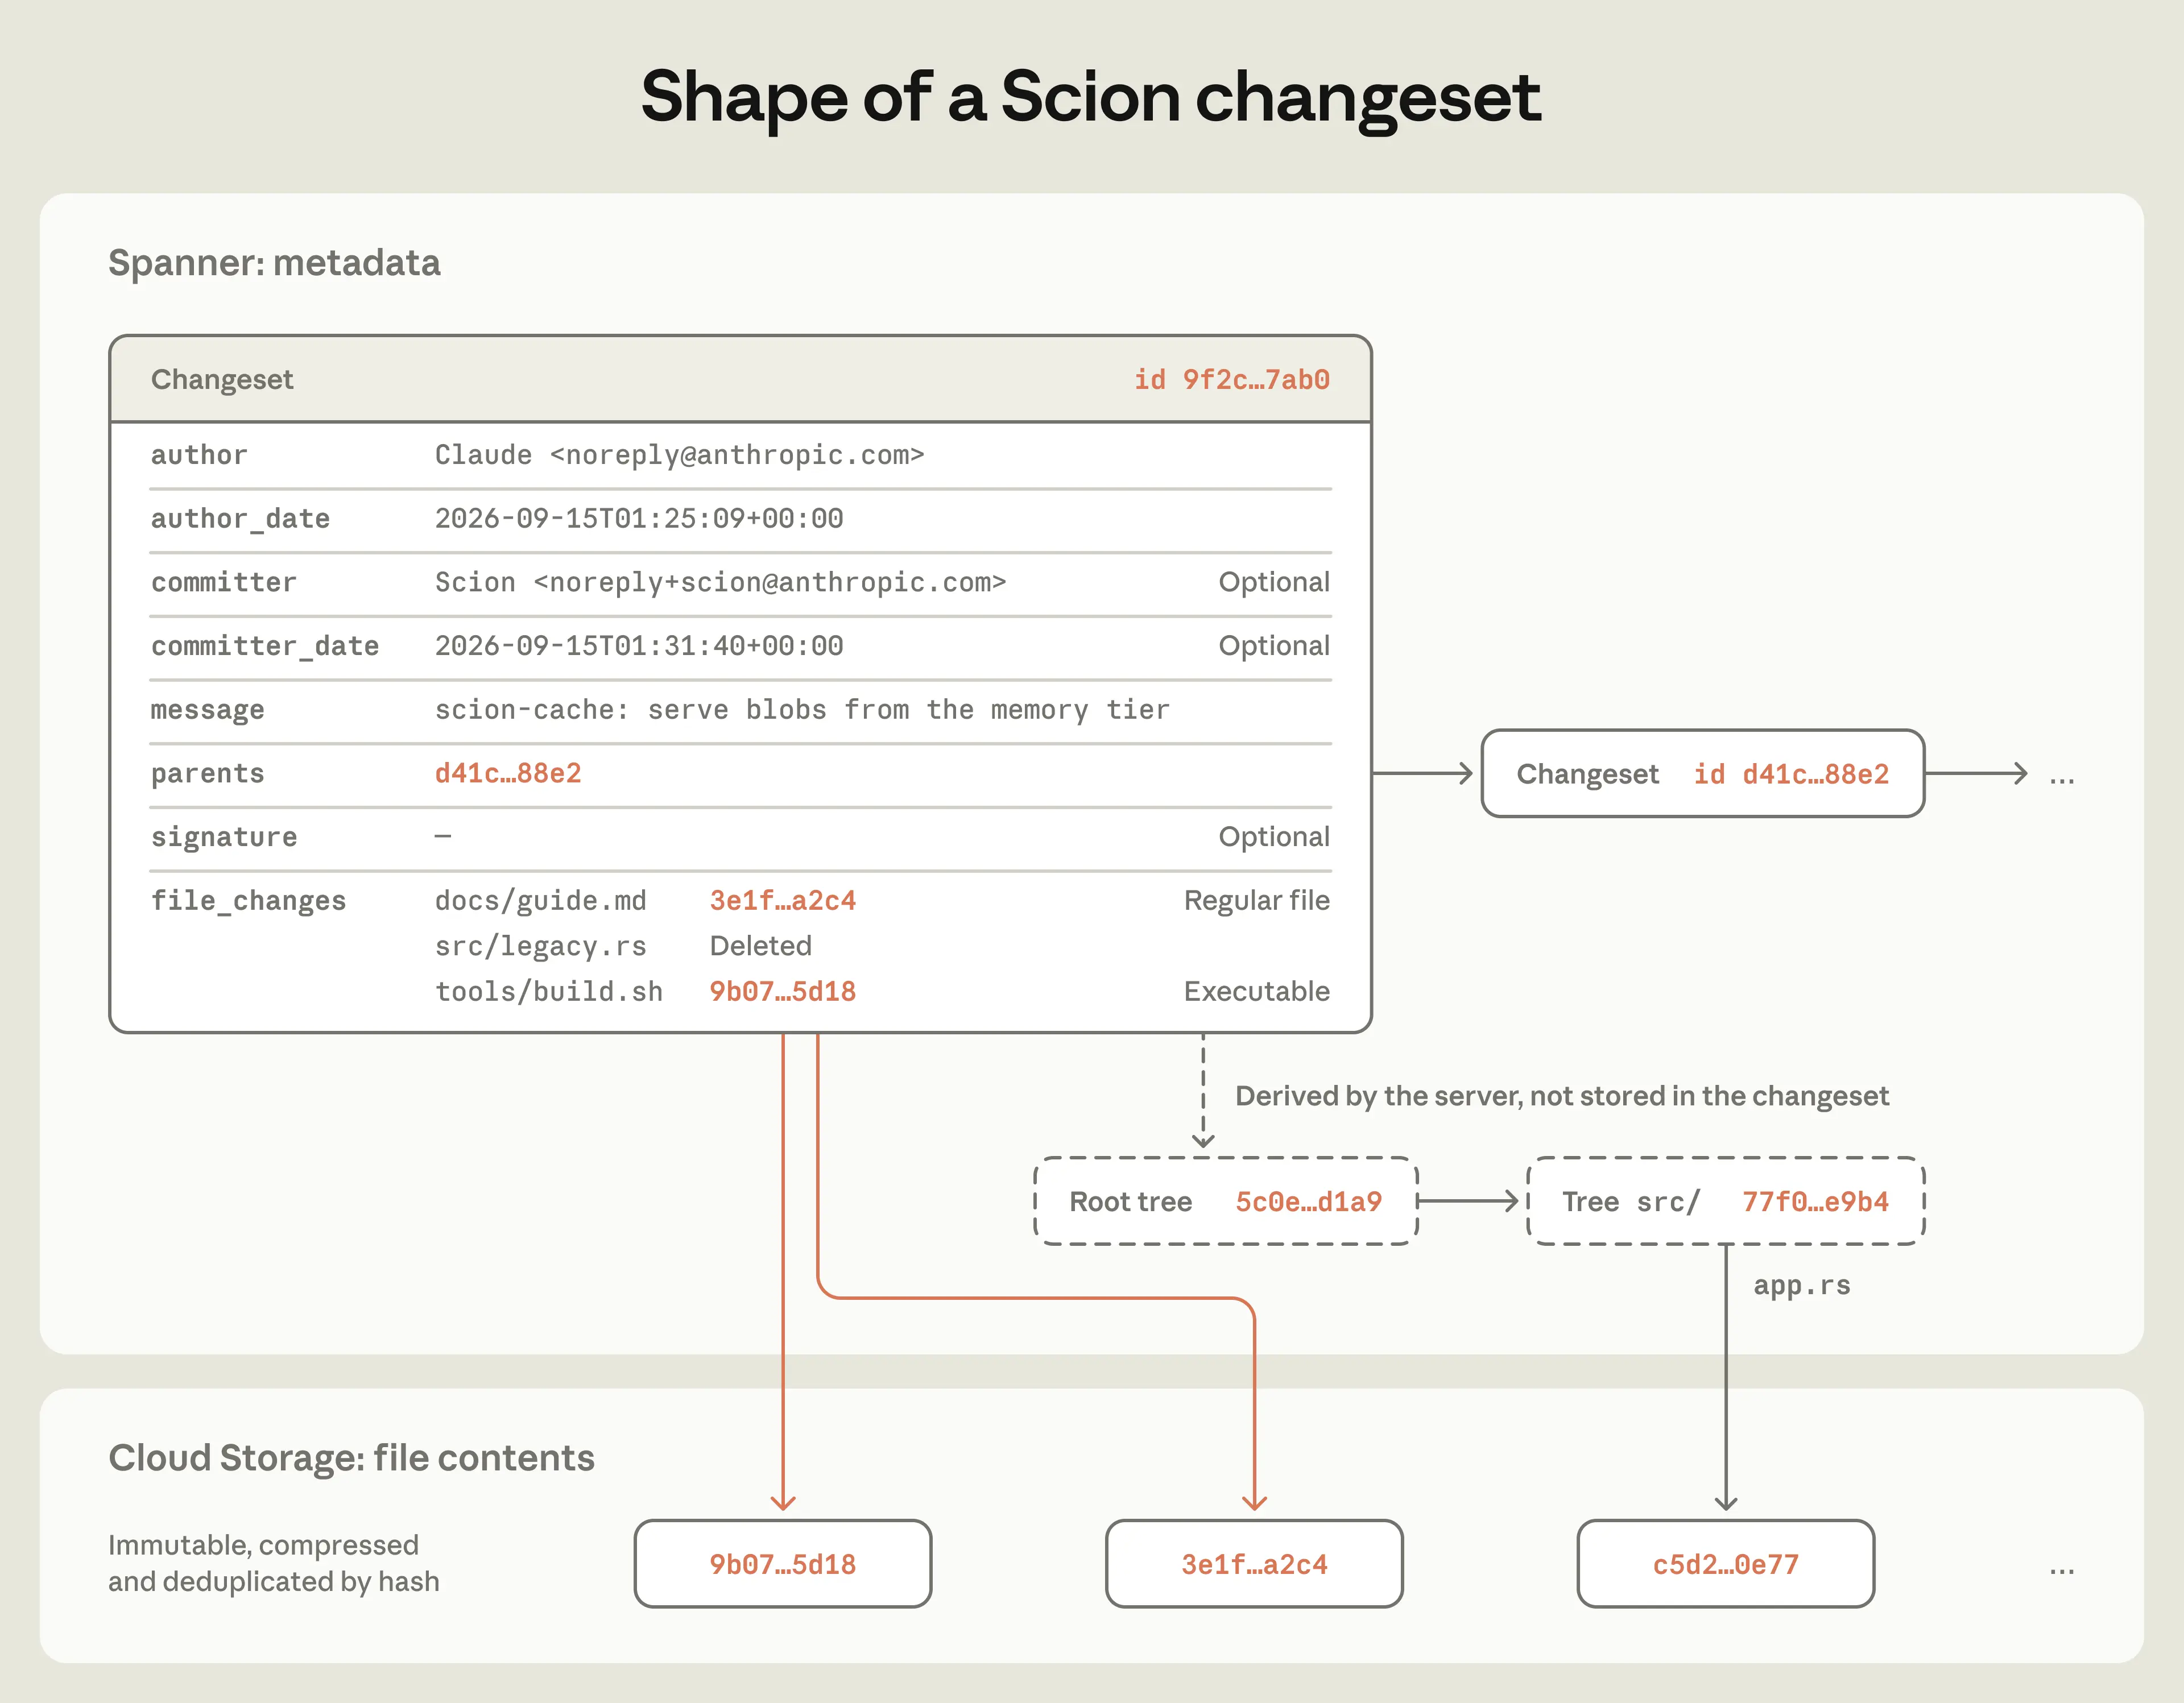
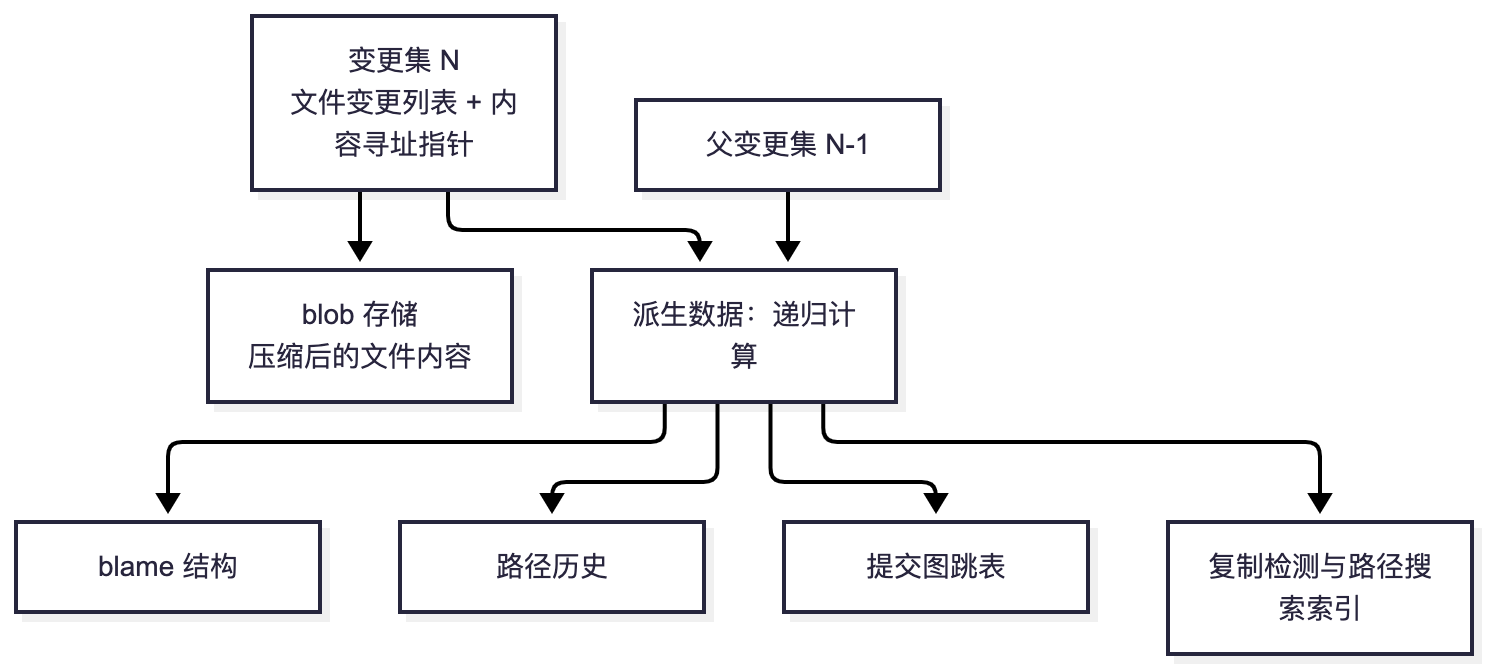
但变更集只记录“改了什么”,回答不了“这行代码谁最后改的”。为此,Scion 在变更集之上构建派生数据(derived data),比如 blame 结构、路径历史、提交图的跳表。所有派生数据都用同一套递归机制计算:一个变更集的值,由它父节点的值算出。
这带来三个好处:
- 想加新的数据结构,随时加(Anthropic 后来新增过复制检测、路径搜索等索引)
- 每种数据可以选择急切计算还是延迟计算
- 内部结构对客户端不可见,可以随意优化而不影响客户端
三层缓存架构:检出快了两个数量级
Scion 的客户端 scn 在协议上与 Git 大不相同:
- 协商时不告诉服务器“我已经有什么”,只请求“我想要的树和 blob”
- 从根目录树开始,客户端检查本地缺失的树,递归请求,再请求 blob
- 每个请求都针对不可变的具体对象,因此任何缓存都能回答
- 没有“单个几个 GB 的 packfile 响应”,因此天然可续传
- 稀疏检出、虚拟化检出无需特殊支持,不想要的树,客户端不请求就行
整个架构像一个典型的分层缓存:
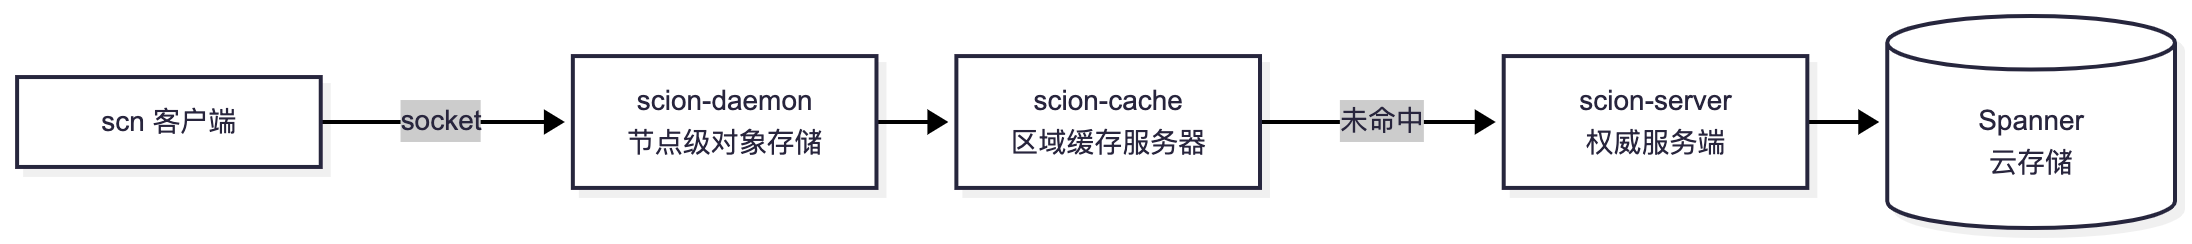
守护进程从定期刷新的快照启动,只和本区域的 scion-cache 通信。缓存服务器从内存里以客户端可直接消费的磁盘格式流式输出对象,不用计算客户端缺什么,也不用做 delta 压缩。三层使用相同的 RPC,但严格执行分层,以隔离故障域,避免区域缓存故障把上游服务器拖垮。
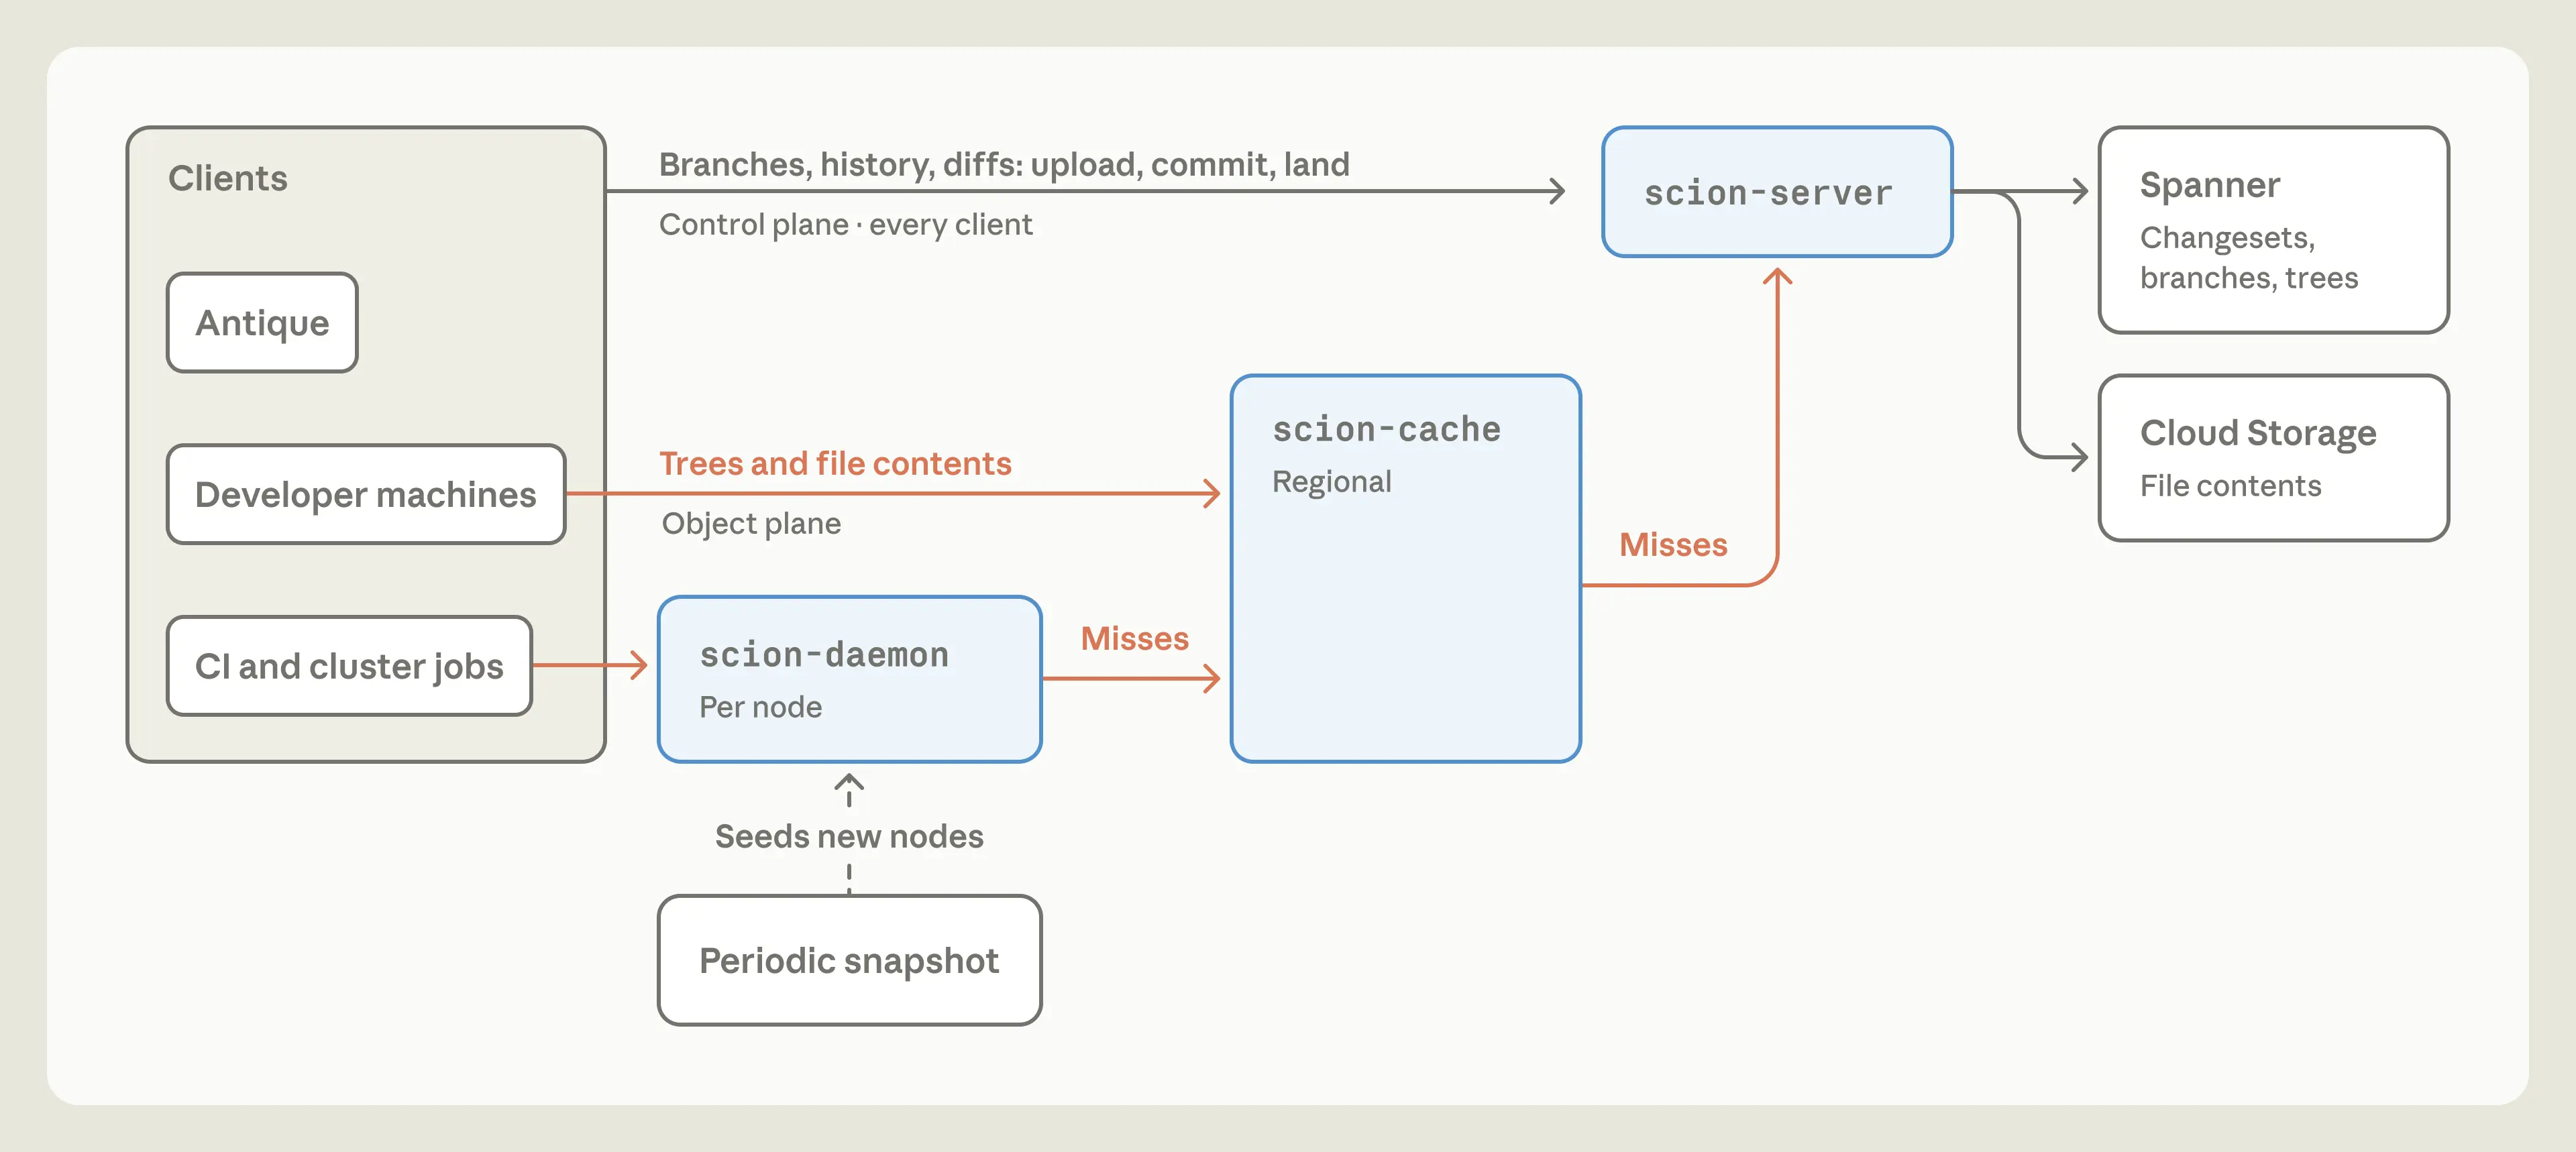
成绩单
- 每一层缓存命中率 超过 99%
- Scion 基础设施的 CPU 与内存需求,比之前的 Git 镜像体系 小 200 倍
- CI 与研究任务检出代码 快两个数量级,从分钟级降到秒级
- 仅 CI 一项就节省 25% 的 CPU 容量
- 客户端和缓存都不再需要做仓库维护
Claude 造了 Scion,Scion 又救了 Claude
这个项目最有意思的地方在于:Claude 既是问题的制造者,也是解决方案的建造者。
Mythos 重写:内存降 20 倍,速度快 4 倍
早些时候,团队手写了第一版“Git 到 Scion”的摄取管线原型,自认为已经不错。
直到他们拿到内部早期版本的 Claude Mythos Preview。团队让它把整个管线重写一遍,没有额外指令。
结果是:内存占用降低 20 倍,速度提升 4 倍,同时保留了摄取顺序与数据结构的所有隐含不变量。
7 个人,干了过去需要几年的事
官方明确表示:一个 7 人团队,在 5 个月内,不仅做了 Scion,还做了代码评审工具 Antique,以及另外半打相关系统,并完成了全量迁移。同期,每日合并量增长了 10 倍。
按他们的说法,这类项目过去需要公司花数年做渐进迁移,投入多得多的工程师。
工程师的新工作:对 Claude 说“不”
团队成员都承认,Claude 写代码比自己强。但工程师依然不可替代,因为他们负责:
- 理解跨系统的高层组件
- 做设计层面的取舍
- 经常要对 Claude 说“不”
比如,多个系统图省事,用线性读取提交日志的方式,去找“某个变更什么时候合入主干”,而不是去问代码评审工具。又比如,对抗式评审太过“谨慎”,导致 Claude 对另一个内部服务过度防御,加了大量不必要的校验。
所以现在,团队依然评审每一个变更请求,但看的是意图,而不是逐行读代码。
“Superfan”:永不下班的单组件守护者
团队借助 Claude Tag,在 Slack 里为每个组件建了一个专属频道,并让 Claude 做这个组件的“超级粉丝”(superfan):scion-daemon superfan、scion-cache superfan、Antique 合并队列 superfan……
它们能访问遥测和日志,像一个“没别的事可干、只会盯着图表看异常”的资深工程师。官方说,传统告警和它们相比,显得“一维”。
合并队列还有意义吗?
团队还提出了一个让人深思的问题:
当成百上千个变更在测试期间同时合并,CI 到底意味着什么?
他们没能复制业界标准的“合并队列全局锁”,转而投入合并后与部署前的自动化测试。代价是并发变更可能冲突,但官方说,Claude 通常修冲突比人类发现冲突还快。
冷静看:这不是“Git 的终结”
原文本身相当克制,着重强调了:
- Scion 不是 Git 的通用替代品。它只对“数万名工程师或大批智能体高频写代码”的超大 monorepo 有意义。
- 不打算对外提供。它与 Git 差异巨大,需要配套的代码评审、搜索和 CI,且内部版本高度定制。
- Anthropic 的算力预算是特例。官方承认,其内部花 token 的能力,远超其他公司会愿意花的量。
另外,这条路并非首创。官方也提到,超大 monorepo 的源码管理有前人:
| 系统 | 公司 | 特点 |
|---|---|---|
| Piper | 中心化;底层用 Bigtable 后迁 Spanner;“云端客户端”让本地副本极小,平均不到 10 个文件 | |
| Sapling | Meta | 可扩展、对用户友好;客户端兼容 Git 仓库 |
| Scion | Anthropic | 面向“永远在线的智能体”;变更集 + 派生数据;服务端为核心 |
(Piper 数据来自维基百科引用的 2016 年 ACM 论文:当年约 2.5 万名开发者每天提交约 1.6 万次变更,另有约 2.4 万次机器人提交。口径和年代不同,不宜与 Scion 的 3 万次直接对比,但足以说明:超大规模单仓库并不新鲜,新的是“主要写代码的人变成了 AI”。)
Anthropic 更想做的,是把经验带回 Git 生态。他们的设想包括:
- Git 服务端不必和客户端同构,可以采用全新的服务端架构
- Git 平台可以提供像 Scion 那样的完整服务端 RPC,甚至跨平台标准化
- 协商协议不必一成不变,稀疏和浅克隆功能应该能更好地组合
他们还特意向 Git 社区致意,说社区花了近二十年,才把 Git 扩展到服务数百万开发者,并表示希望与 GitHub、GitLab 和开源社区合作。
写在最后
这篇博客最值得记住的,不是 Scion 的某个具体设计,而是它揭示的趋势:
当“写代码”的成本趋近于零,整个软件开发生命周期里,所有为人类速度设计的环节,都会依次变成瓶颈。版本控制是第一个,构建、CI、合并队列、代码评审,都排在后面。
Anthropic 官方预测,这类问题将在未来 6 到 12 个月内变得更普遍。
对多数团队来说,今天未必需要自研一个 Scion。但值得提前想想:
- 你的 CI 有多少时间花在拉代码上?
- 你的仓库工具链,是否默认“人类速度”?
- 当 Agent 的数量翻 10 倍,哪一环会先垮?
答案,也许就藏在这篇博客里。
参考资料:
- Anthropic 工程博客:Redesigning source control at Anthropic(2026 年 10 月 13 日):https://www.anthropic.com/engineering/redesigning-source-control
- Piper(Google):https://en.wikipedia.org/wiki/Piper_(source_control_system)
- Sapling(Meta):https://sapling-scm.com/
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
还在为“复制粘贴喂AI”而烦恼?我的新专栏 《AI原生开发工作流实战》 将带你:
- 告别低效,重塑开发范式
- 驾驭AI Agent(Claude Code),实现工作流自动化
- 从“AI使用者”进化为规范驱动开发的“工作流指挥家”
扫描下方二维码,开启你的AI原生开发之旅。
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。