本文永久链接 – https://tonybai.com/2026/09/14/go-cgo-without-c-toolchain
大家好,我是Tony Bai。
【导读】
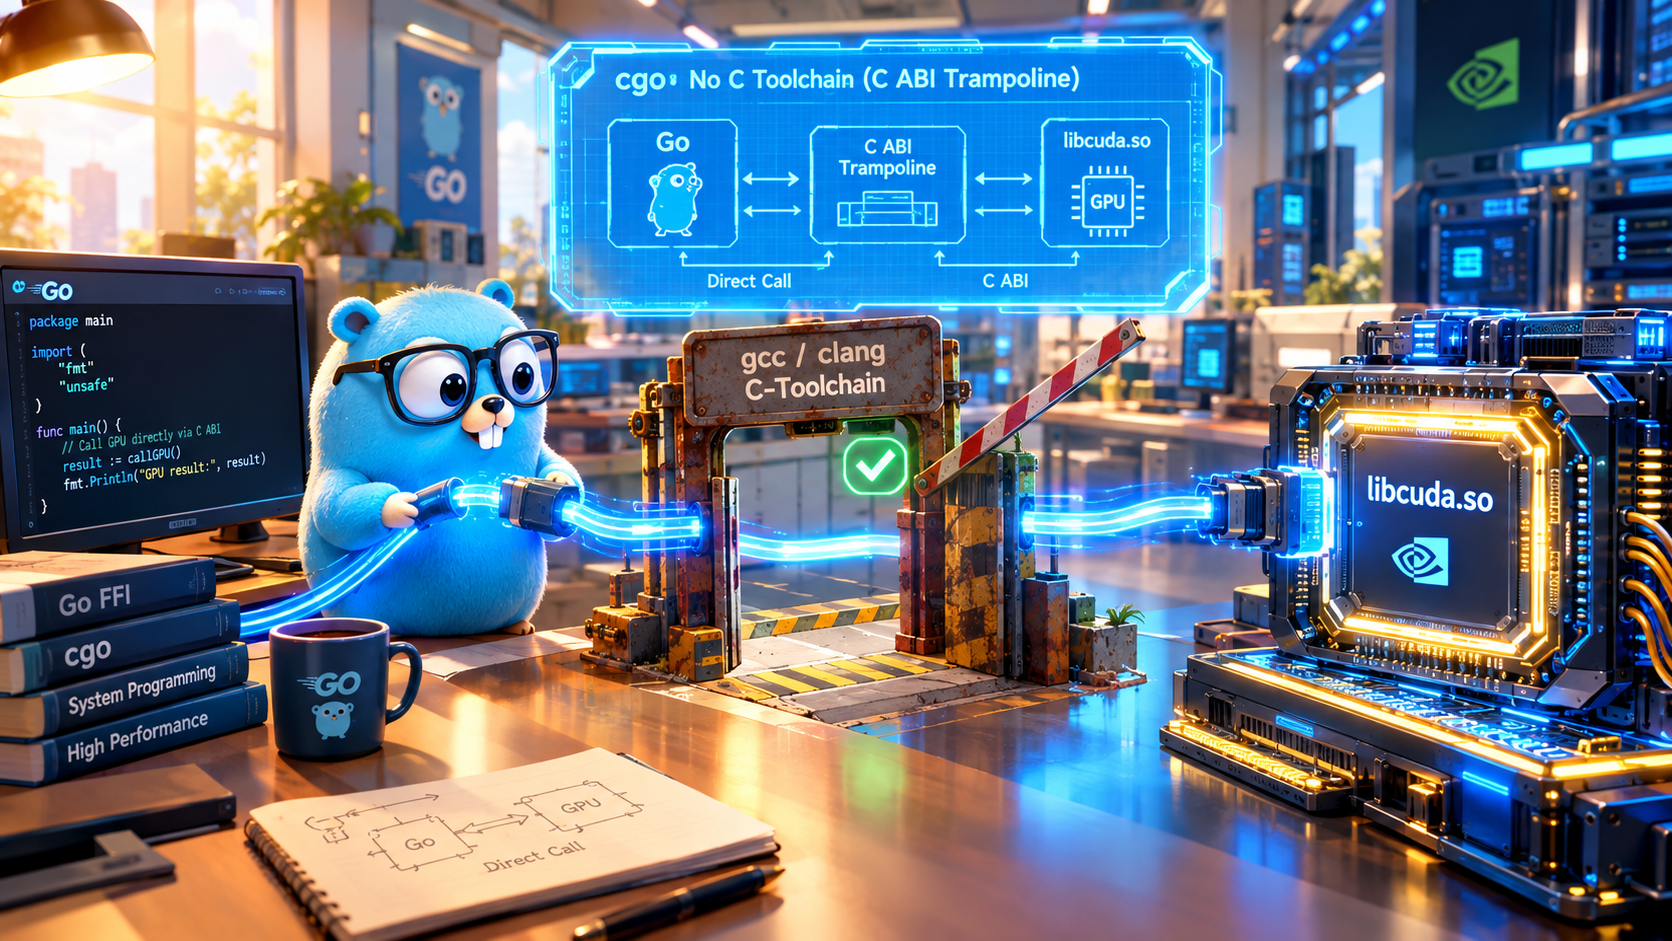
Go 语言用 cgo 打通了和 C 世界的桥梁,但这座桥一直有个“隐形收费站”——不管你调用的 C 库是不是已经编译好,只要写了 import “C”,本地就必须装一套完整的 C 工具链。近日,Go 核心开发者 Matloob 提交了一份重量级提案 #81450,试图彻底改写这条规则:cgo 不再是“请 C 编译器帮 Go 调 C”,而是“让 Go 自己理解 C ABI,直接调用已经编译好的 C”。这对跨平台构建、预编译库分发,尤其是 CUDA、TensorRT 这类 AI/GPU 原生库的调用,可能是一次架构级的松绑。
【文章要点】
- Go 核心开发者 Matloob 于 2026 年 9 月 10 日提交提案 #81450,目标是让 cgo 在“只调用预编译 C 库”的场景下彻底摆脱 C 工具链依赖;
- 核心思路是把“理解 C 声明”和“生成 Go↔C 胶水代码”拆成两步,中间用一种新的 Go 语法“binding 文件”作为桥梁;
- 关键改造点包括:cgo 需要自己理解各平台的 C calling convention,生成 Go + 汇编 trampoline;
runtime/cgo也要从 C 改写为 Go + 汇编; - 这不是要消灭 cgo,而是把 cgo 分成“binding-based(无需 C 编译器)”和“C 源码编译(仍需 C 编译器)”两条路径并存;
- 对跨平台交叉编译、以及调用 CUDA/ROCm/TensorRT 等已编译好的 AI-GPU 原生库场景,价值尤其明显;最大的落地风险不在技术,而在“binding 生态”由谁维护。

在此前 Go 官方内部会议流出的消息里,Go 1.28 的候选特性清单中出现了一项引人注目的条目:cgo without a C toolchain。
9 月 10 日,Go 核心开发者 Matloob 正式在 golang/go 仓库提交了对应提案:proposal: cmd/cgo: cgo without a C toolchain(#81450)。目前该提案还停留在讨论阶段,没有 PR,也没有明确的里程碑(暂时还未被Go 1.28里程碑纳入),但它所指向的方向,很可能是 Go 与 C/C++ 世界交互方式的一次重要重构。
先给结论:
| 方面 | 判断 |
|---|---|
| 核心思想 | 非常合理 |
| 技术可行性 | 高 |
| 工程实现难度 | 中高 |
| 对 Go 编译器的侵入性 | 较低 |
| 对 cmd/cgo 的复杂度 | 明显增加 |
| 对 C ABI 的依赖 | 非常高 |
| 对普通 cgo 用户 | 基本透明 |
| 对跨平台编译 | 价值巨大 |
对预编译 .so/.a |
特别有价值 |
| 对包含 C 源码的 cgo | 基本无效 |
| 能否彻底消灭 C 工具链 | 不能 |
最关键的一句话:它不是让 Go “不用 C 了”,而是让 Go 在“只调用已经编译好的 C”时,不再需要再次编译 C。这两个概念需要被严格区分开。
现在的 cgo,为什么必须要有 C 编译器
理解这个提案,得先弄清楚现状。假设有这样一段代码:
package main

/*
#include <math.h>

double cos(double);
*/
import "C"

func main() {
    x := C.cos(1.0)
    _ = x
}
很多人直觉上会以为流程是这样的:
Go
 ↓
C.cos()
 ↓
libm.so
既然 libm.so 早就编译好了,链接一下不就行了?
但现实中的 cgo 并不是这么工作的。真实链路大致是:
              Go source
                  │
                  ▼
               cmd/cgo
                  │
        ┌─────────┴─────────┐
        │                   │
        ▼                   ▼
   C preamble            Go wrapper
        │                   │
        ▼                   │
    C compiler              │
        │                   │
        ▼                   ▼
     C object ────────→ C ABI glue
                            │
                            ▼
                         linker
                            │
                            ▼
                        libxxx.so
也就是说,当前 cgo 至少在两个环节上强依赖 C 工具链:
- 理解 C preamble——解析
/* ... */里的头文件和声明; - 编译 cgo 生成的 C 胶水代码——cgo 会生成一部分 C 代码,需要用 C 编译器编出目标文件。
提案原文里也明确指出了这一点:即使一个 Go 包并不包含任何 C 函数定义,只是通过 C 声明去调用一个已经编译好的 .so/.a,构建过程依然需要一套 C 工具链,根源就在于 cgo 命令会处理 C preamble 并生成部分 C 代码的胶水层,而这部分代码需要用 C 编译器编译。
真正巧妙的想法:把“理解 C”和“编译 C”拆开
这是整个提案最精彩的部分。
现在的 cgo,把“C 声明”、“C ABI”、“Go <-> C 胶水代码”和“C 编译器”这四件事完全糅合在一起,一个环节出问题,整条链路都跑不通。
提案希望把它拆成两个独立的阶段:
开发阶段(包作者,可选借助 C 工具链)
C header
   ↓
C compiler(可选)
   ↓
DWARF / layout information
   ↓
cgo -gen-binding
   ↓
binding.go
构建阶段(终端用户,无需 C 工具链)
binding.go
     ↓
   cgo
     ↓
Go + assembly trampoline
     ↓
Go compiler
     ↓
binary
     ↓
existing .so / .a
换句话说:把 C 编译从“每次构建的运行时依赖”,变成“生成 binding 时的可选开发依赖”。 这正是这份提案最值得关注的地方。
Binding 文件:在 Go 世界里重新描述一次 C API
提案提出的核心新概念叫作 binding 文件。它本质上是用 Go 语法,把一段 C 接口重新描述了一遍。
例如提案原文给出的例子,原始 C 声明是:
struct point {
	float x;
	float y;
};

point global;

float compute(point p0);
对应的手写 binding 文件可能长这样:
//go:build darwin

package mypkg

import "C"

// type definition
//cgo:binding C.point
type Point struct {
	x, y float32
}

// global variable
//cgo:binding C.global
var Global Point

// function declaration
//cgo:binding C.compute
func Compute(p0 Point) float32
//cgo:binding 注解的作用,是把一个普通的 Go 类型/变量/函数声明,显式绑定到某个 C 符号上。这样一来,Go 工具链就不再需要解析原始的 C 头文件,它只需要相信这份 binding 描述即可。
提案原文特别说明,他们不希望把一套完整的 C 预处理器和 C 语法解析器塞进 Go 工具链,因为 C 声明可以涉及嵌套头文件引用、#define 宏、#if/#ifdef 条件编译、平台相关的类型定义等等,复杂度极高、维护成本极大。
用 Go 语法描述 binding,既保留了可读性、可编辑性,也方便复用 Go 工具链现成的文件解析能力。
这份判断我认为是相当克制且正确的。
Binding 怎么生成:cgo -gen-binding
对于已经有 C 工具链的包作者,提案给出了一条自动化路径:运行
go tool cgo -gen-binding
此时 cgo 命令会像传统 cgo 一样调用 C 编译器编译 C preamble,但不再生成 C 胶水代码,而是从 DWARF 调试信息里提取类型布局和符号信息,直接生成一份 Go 语法的 binding 文件(就像前面那个示例)。
以前面 struct point 的例子为例,自动生成的 binding 文件大致是这样的:
//go:build darwin

package mypkg

import "C"

// type definition
//cgo:binding C.struct_point
type _point struct {
	x, y float32
}

// global variable
//cgo:binding C_global
var _global _point

// function declaration
//cgo:binding C.compute
func _compute(p0 _point) float32
注意生成的符号名带下划线前缀,避免和用户自己命名的 binding 冲突。
这份文件生成之后,就可以和源码一起 check in 到仓库里。于是一个 cgo 包未来的目录结构可能会变成:
foo/
├── foo.go
├── foo.h
├── binding_linux_amd64.go
├── binding_linux_arm64.go
├── binding_darwin_arm64.go
└── libfoo.so
之后使用这个包的终端用户只需要 go build,不再需要本机装 gcc、clang、头文件、sysroot 这一整套东西。
为什么这能明显缓解跨平台痛点
C 的条件编译在跨平台场景里向来是个老大难问题,比如:
#if defined(__x86_64__)
    ...
#elif defined(__aarch64__)
    ...
#endif
在新模型下,这种平台分支被前移到了 binding 生成阶段,而不是留给最终用户的构建阶段:
bindings/
├── amd64/
│   └── binding.go
├── arm64/
│   └── binding.go
└── ...
配合 Go 原生的 //go:build linux && amd64 构建约束,工具链会自动选中对应平台的 binding 文件。这意味着 C 世界里那些复杂的预处理逻辑,被转移到了库作者的开发阶段完成,而不再出现在最终用户的构建阶段,对交叉编译体验的提升非常直接。
需要强调一个前提:这套机制不能凭空把 x86 的库变成 ARM 的库,目标平台对应架构的预编译库依然要事先准备好。它解决的是“生成 Go↔C 胶水代码不再需要交叉 C 编译器”,而不是“C 库本身可以跨架构自动转换”。
硬骨头一:Go ABI 不等于 C ABI
这是提案中技术含量最高的部分。一个 Go 函数:
func Compute(a float64, b float64) float64
并不能直接映射成一条 CALL compute 指令,因为 Go 有自己的一套调用约定(参数怎么传、返回值怎么传、栈怎么用、GC 怎么配合),C 也有自己独立的一套 ABI,两者并不兼容。
提案给出的方案是:cmd/cgo 在 go build 时,根据目标平台的 C ABI 计算每个被声明函数的 calling convention,生成对应的 Go + 汇编 trampoline,负责在 Go ABI 和 C ABI 之间做参数与返回值的转换,并处理栈切换等运行时细节。这部分生成出来的胶水代码全部是 Go 和汇编,因此可以用 Go 工具链本身完成编译,不再需要 C 编译器插手。
这条路径之所以行得通,一个重要原因是:C ABI 远比 C 语言本身要简单和稳定。
C 语言层面充斥着宏、#ifdef、内联、编译器扩展等复杂机制,但落到 ABI 层,只剩下整数、浮点数、指针、结构体、数组、返回值约定、寄存器分配、栈对齐这些相对收敛的问题,并且不同平台的 ABI(比如 Linux amd64 的 System V AMD64 ABI、arm64 的 AAPCS64、Windows 的 x64 ABI)通常都非常稳定,多年不会大改。
这也是提案里反复强调“C ABI 不经常变化,因此让 Go 工具链去理解它是可维护的”的原因。
硬骨头二:struct 内存布局与复杂类型
一个简单的函数签名比较好处理,但结构体开始变得棘手:
struct Foo {
    char a;
    int b;
    double c;
};
它的内存布局涉及字节偏移、对齐填充等细节,Go 侧的等价结构体必须在 ABI 层面严格保持一致,哪怕字段类型“看起来一样”也不能掉以轻心。再叠加联合体、位域、匿名结构体/联合体、#pragma pack、平台相关的 long 长度等花样,复杂度会迅速上升。
可以说,这个提案最容易落地的场景是“函数 + 标量类型 + 指针 + 简单结构体”,最难啃的骨头是完整覆盖整个 C 类型系统的边角情况。
硬骨头三:C 函数指针回调
比如:
typedef int (*callback)(int);

void register_callback(callback cb);
要在 Go 里把一个函数注册成 C 的回调,涉及回调 trampoline、runtime/cgo 的协作、goroutine/线程调度、栈切换,以及和 GC 的交互,比单向的“Go 调 C”要复杂得多。不过这并非全新的难题——Go 运行时此前处理传统 cgo 回调时,已经解决过其中相当一部分问题,这条路径在技术上并非不可行,只是工程量更大。
硬骨头四:runtime/cgo 也要“去 C 化”
这一步是整个提案能否闭环的关键。目前 runtime/cgo 包本身就是用 C 写的,如果这一层不改造,那么无论上层的 binding 机制做得多完善,最终仍然会绕回到需要 C 编译器的老路上。
提案明确提出,要把 runtime/cgo 中原本用 C 实现的部分,重写为 Go 和汇编代码。这样一来,从用户程序到最终的 C ABI 调用,中间所有环节都不再依赖 C 编译器:
           Go program
               │
               ▼
             cgo
               │
               ▼
       Go + assembly glue
               │
               ▼
          runtime/cgo(改写为 Go + 汇编)
               │
               ▼
             C ABI
               │
               ▼
          libfoo.so
需要注意的是,一旦 runtime/cgo 不再包含 C 代码,CGO_CFLAGS 里传入的编译选项将对它失效,这可能会影响到依赖 C sanitizer 的一些使用场景,提案本身也把这一点列为待解决的开放问题之一。
这和 Go 1.20/1.21 的路线一脉相承
这个提案并非凭空冒出来的新想法,而是 Go 团队一条延续多年的技术路线的自然延伸。
Go 1.20 让“没有 C 编译器时,CGO_ENABLED=0 也能构建纯 Go 程序”成为常态;Go 1.21 更进一步,Go 官方在关于可复现构建的博客文章中明确提到,Go 1.21 完成了把 host C 工具链和 host 动态链接器从 Go 工具链自身的构建过程中彻底移除,这是可复现构建和供应链安全目标的重要一步(参见 go.dev/blog/rebuild)。
于是,#81450 可以被放进这样一条演进脉络里:
Go 1.20
  │  为纯 Go 用户消除 C 依赖
  ▼
Go 1.21
  │  从 Go 工具链自身的构建过程中消除 C 依赖
  ▼
2026 #81450
  │  为特定 cgo 包消除 C 依赖
  ▼
未来
  │
  ▼
C ABI 成为 Go 工具链的一等公民概念
对 AI/GPU/原生 SDK 生态尤其有价值
这可能是这份提案最值得 Go 开发者关注的现实落点。像 CUDA、ROCm、TensorRT、ONNX Runtime、OpenSSL、SQLite 扩展,以及各类厂商 SDK,Go 侧真正的需求往往不是“我要编译一段 C 代码”,而是“我要调用一个已经编译好的原生库”。
比如调用 C.cudaMalloc(...) 时,CUDA 运行时库本身早就编译好了,真正需要打通的只是“Go 如何按照 C ABI 去调用 libcuda.so”,而不需要在本地重新走一遍 gcc 编译 C 胶水代码的流程。如果这个提案最终落地,对 Go 在 AI 基础设施、GPU 计算、原生 SDK 集成方向的开发体验会是一次实打实的提升。
它绝对无法取代所有 cgo
理解这份提案时最容易踩的坑,是误以为它能让所有 cgo 场景都摆脱 C 编译器。只要代码里还包含实际的 C 源码,比如:
/*
#include "foo.h"

static int helper(int x) {
    return x * 2;
}
*/
import "C"
C 编译器依然是刚需,因为这里有需要被真正编译的 C 源码。所以新方案实际上是把 cgo 分成了两条并行的路径:
                 cgo
                  │
         ┌────────┴─────────┐
         │                  │
   binding-based        传统 cgo
   (调用预编译库)    (含 C 源码)
         │                  │
         ▼                  ▼
   无需 C 编译器        仍需 C 编译器
这个设计相当务实:它没有试图消灭 C 编译器,而是精准地解决了“明明只是调用预编译库、却被迫装一整套工具链”这一个具体痛点。
真正的架构变化:C ABI 成为 Go 工具链的一等公民
如果只把这份提案理解成“cgo 不用装 gcc 了”,其实是低估了它。
过去,Go 把处理 C ABI 这件复杂的事情,几乎完全“外包”给了 gcc/clang:
C language → C compiler → object → linker
而在新方案里,cmd/cgo 要开始自己理解 C 的调用约定、结构体内存布局、对齐规则、参数传递方式和返回值约定,并生成对应的 ABI trampoline:
Go toolchain
      │
      ├── Go ABI
      │
      └── C ABI
这意味着 Go 正在从“调用 C 编译器”转向“直接理解 C ABI”,这是架构层面的变化,也是这份提案里我认为分量最重的部分。
可行性路线
可以把这份提案的落地难度拆成三个层次来看:
第一阶段:简单 C API(如 int foo(int)、double bar(double)、void *alloc(size_t))——技术上没有明显障碍。
第二阶段:复杂结构体、指针、回调函数——技术路径清晰,但 runtime、ABI、GC 交互的细节工作量不小。
第三阶段:完整覆盖 C 语言的边角特性(宏、__attribute__、位域、匿名联合体、变长参数函数、线程局部存储、setjmp/longjmp、信号处理、sanitizer 等)——这层不是做不到,而是没有必要为了“无 C 编译器的 cgo”把整个 C 语言重新实现一遍。提案自己也明确选择了“不去解析完整 C 语言”这条更克制的路线,这一点我认为是恰当的取舍。
最大的风险不在技术,而在 binding 生态
真正可能拖慢这份提案落地的,未必是 ABI 处理的技术难度,而是一个更现实的问题:binding 由谁来维护?
像 libssl、libsqlite、libcurl、libcuda、librocksdb、libtorch 这类库,如果每个 Go 包都要为 linux/amd64、linux/arm64、darwin/arm64、windows/amd64 等多个平台分别维护一份 binding,长期的维护成本不容小觑。更棘手的是 binding 与实际 C API 版本漂移的问题:如果上游库更新了结构体字段类型而 binding 没有同步更新,很可能不会在编译期报错,而是直接在运行时表现为内存布局错位,进而引发难以定位的段错误甚至静默内存损坏。
提案里也意识到了这个问题,给出的思路是:在系统存在 C 工具链的情况下,让 go test 重新生成一份 binding 并与 checked-in 版本做一致性校验。这几乎是必须要做的保障机制,未来很可能会进一步演变成 CI 流程里的标准一环,比如 go generate 加 diff 检查,或者类似 go test -verify-cgo-bindings 这样的校验命令。
从长期看,这可能会催生一种新的生态形态:
C library
    │
    ▼
官方 binding 生成器
    │
    ▼
Go binding package
    │
    ├── ABI definitions
    ├── platform definitions
    └── version metadata
对 Go 开发者最现实的影响
如果这份提案最终落地,未来的 Go 原生集成可能会形成三条并存的路径:
- 纯 Go:
Go → Go 编译器,现状已经很好,不受影响; - Binding-based cgo:
Go → Go/汇编 trampoline → libfoo.so,未来面向“只调用预编译库”场景的最舒适选择; - 传统 cgo:
Go → C 源码 → C 编译器 → 目标文件,涉及真实 C 源码时依然存在,属于兼容遗留路径。
小结
golang/go#81450 不是一个“为了少装一个 gcc”的小优化,它实际上在同时做三件事:
- 把 C 声明从构建时依赖变成 checked-in 的元数据;
- 把 C 编译器从 cgo 的运行时依赖降级为可选的开发时依赖;
- 把 C ABI 正式纳入 Go 工具链的能力范围。
第三点,才是这份提案里分量最重的部分。
一句话概括:过去的 cgo 是“请 C 编译器帮 Go 调 C”,这份提案想把它变成“Go 自己理解 C ABI,然后直接调用已经编译好的 C”。结合 Go 1.20/1.21 已经持续多年消除 Go 工具链对 host C 工具链依赖的路线来看,#81450 并不是一次突然冒出来的奇思妙想,而是这条演进路径的自然下一步。
如果最终顺利落地,它很可能会成为 Go 原生/FFI 生态一次分量不轻的架构升级。
目前该提案仍处于早期讨论阶段,围绕 binding 文件应该采用注解式还是独立命名空间等设计细节,Go 团队还在公开征求社区反馈。感兴趣的开发者,可以直接前往 golang/go#81450 参与讨论。
参考链接:
还在为写 Agent 框架频频死循环、上下文爆炸而束手无策?我的新专栏 《从0 开始构建 Agent Harness》 将带你:
- 抛弃臃肿框架,回归“驾驭工程 (Harness Engineering)”的第一性原理
- 用 Go 语言手写 ReAct 循环、并发拦截与上下文压缩引擎等,复刻极简OpenClaw
- 构建坚不可摧的 Safety Middleware 与飞书人工审批防线
- 在底层实现 Token 成本审计、链路追踪与自动化跑分评估
- 从“调包侠”进化为掌控大模型边界的“AI 操作系统架构师”
扫描下方二维码,开启从 0 开始构建Agent Harness 的实战之旅。
你的Go技能,是否也卡在了“熟练”到“精通”的瓶颈期?
- 想写出更地道、更健壮的Go代码,却总在细节上踩坑?
- 渴望提升软件设计能力,驾驭复杂Go项目却缺乏章法?
- 想打造生产级的Go服务,却在工程化实践中屡屡受挫?
继《Go语言第一课》后,我的《Go语言进阶课》终于在极客时间与大家见面了!
我的全新极客时间专栏 《Tony Bai·Go语言进阶课》就是为这样的你量身打造!30+讲硬核内容,带你夯实语法认知,提升设计思维,锻造工程实践能力,更有实战项目串讲。
目标只有一个:助你完成从“Go熟练工”到“Go专家”的蜕变! 现在就加入,让你的Go技能再上一个新台阶!
商务合作方式:撰稿、出书、培训、在线课程、合伙创业、咨询、广告合作。如有需求,请扫描下方公众号二维码,与我私信联系。